El 21 de octubre de 2026, OpenAI y equipos de investigación colaboradores publicaron los resultados de un experimento histórico: una flota de 1.946 agentes especializados de IA trabajó de manera coordinada para completar el análisis del atlas genético del cerebro completo de un ratón en apenas 32 minutos. Dicho atlas recoge las respuestas a perturbaciones genéticas en millones de células cerebrales, un volumen de datos de alta dimensionalidad que a los científicos humanos suele llevarles años descifrar.
Esto no es solo una exhibición de fuerza bruta de cálculo; la verdadera transformación reside en la granularidad de la descomposición ingenieril. Al enfrentarse a grandes volúmenes de datos biológicos, los modelos fundacionales monolíticos sufren sobrecarga de contexto y tienden a arrojar generalidades superficiales. Los investigadores abandonaron la idea de que un único macro-modelo asumiera todo el flujo de trabajo y dividieron el proceso de investigación en miles de micro-tareas verificables en paralelo.
Años de trabajo comprimidos en 32 minutos: ¿qué calculaban cerca de 2.000 modelos?
El cerebro del ratón alberga una densa red de interconexión celular. Mediante tecnología CRISPR, los investigadores perturbaron sistemáticamente genes clave. Al silenciarse un gen concreto, los niveles de expresión de miles de genes vinculados comenzaron a fluctuar. El atlas completo recopiló las respuestas a estas perturbaciones en millones de células individuales, generando un volumen masivo de información.
Los biólogos que analizan estos conjuntos de datos deben cotejar interminables matrices y tablas, pasando a menudo meses revisando artículos académicos para formular hipótesis sobre los mecanismos moleculares. Los 1.946 agentes equipados con GPT-Rosalind no intentaron procesar toda la información de golpe. El sistema fragmentó el análisis de perturbaciones y la búsqueda bibliográfica en etapas estandarizadas, permitiendo que cada agente se concentrara exclusivamente en dilucidar un único aspecto microscópico.
Tras 32 minutos de ejecución continua, el enjambre de agentes produjo 3.397 inferencias biológicas independientes. Algoritmos posteriores ensamblaron estas piezas en un grafo unificado de razonamiento. Durante todo el proceso no hubo intervención humana para ajustar hiperparámetros; las hipótesis se derivaron directamente de las matrices de expresión genética subyacentes. Todas las conclusiones se han publicado en código abierto en GitHub como archivo de consulta para la investigación de enfermedades neurodegenerativas.
El modelo monolítico citó 11 artículos; la descomposición de tareas escaló a 7.600
La validez de una inferencia científica depende de la solidez de su cadena de evidencias. Frente a este mismo reto a gran escala, un único modelo monolítico que ingirió todo el conjunto de datos apenas citó 11 referencias bibliográficas. Esta omisión puso de manifiesto el talón de Aquiles de las arquitecturas monolíticas: en cuanto la carga de entrada satura la ventana de procesamiento, el alcance de búsqueda y la atención del modelo decaen bruscamente.
El clúster distribuido transformó el flujo de la información. Cerca de dos mil agentes asumieron roles diferenciados: búsqueda documental, generación de hipótesis y refutación cruzada. Cada subconjunto de agentes se concentró en las anomalías de expresión de subtipos celulares específicos. Según el preprint publicado en bioRxiv, el sistema distribuido consultó y validó cerca de 7.600 publicaciones científicas para la misma tarea, lo que supone una cobertura bibliográfica 711 veces mayor que la del modelo individual.
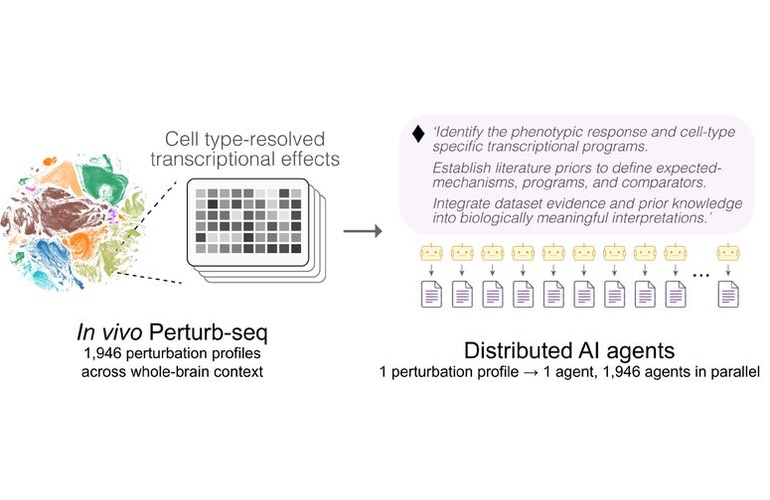 Figura: Arquitectura de orquestación jerárquica de agentes distribuidos, donde cada nodo ejecuta de forma autónoma la correlación bibliográfica y la verificación inversa para perturbaciones de genes individuales. Fuente: R&D World (adaptado de Sun et al., bioRxiv)
Inyectar datos masivos sin filtrar incita a los modelos de lenguaje a deducir correlaciones espurias. Al segmentar la tarea y encomendar a miles de agentes lecturas minuciosas y contrastadas, se conformó una red documental hermética. La profundidad de la descomposición de tareas determina de forma directa la amplitud de evidencias y el rigor de las inferencias científicas.
30 doctores en biología realizan una revisión a ciegas: 48 hallazgos replicados al instante
Generar hipótesis con IA es sencillo; lo complejo es que resistan el arbitraje de la comunidad científica. Para evaluar la calidad de los resultados, el equipo convocó a 30 doctores en biología a una revisión por doble ciego. Los evaluadores calificaron el rigor de las inferencias sin conocer el origen de los informes.
Los agentes nunca habían tenido acceso a los manuscritos originales de los estudios previos. Sin embargo, en la prueba ciega reprodujeron de forma independiente 48 de los 55 hallazgos de referencia de la literatura científica, alcanzando un 87 % de coincidencia. En la comparativa cualitativa, los especialistas humanos prefirieron los informes generados por los agentes distribuidos en el 75 % de los escenarios analizados.
 Figura: A la izquierda, la matriz de perturbación de la expresión genética en millones de células del cerebro murino; a la derecha, la topología de razonamiento desplegada en paralelo por casi dos mil agentes. Fuente: madrobot.blog
Los análisis de modelos individuales suelen quedarse en nociones básicas de manual, sin entrar en los detalles de las interacciones moleculares. Por contra, el clúster distribuido permite que los nodos señalen las inconsistencias lógicas de sus pares, descartando prematuramente las especulaciones infundadas. El mecanismo de interrogatorio cruzado entre nodos reduce drásticamente las alucinaciones en los resultados de los modelos.
Descubriendo vías genéticas poco exploradas: la IA lleva pistas al laboratorio
Replicar conclusiones ya conocidas es solo el punto de partida. El verdadero valor del sistema radica en iluminar los puntos ciegos que escapan al ojo humano. Al analizar el gen DCTN1, los agentes detectaron una anomalía imprevista: tras el silenciamiento de dicho gen, los niveles de expresión vinculados a la síntesis de colesterol aumentaban de manera muy acusada.
DCTN1 codifica una subunidad de dinactina estrechamente ligada a patologías neurodegenerativas como la esclerosis lateral amiotrófica (ELA). Los estudios anteriores se centraban casi exclusivamente en el bloqueo del transporte axonal, y muy pocos habían relacionado este gen con el metabolismo del colesterol. Tras cruzar decenas de publicaciones secundarias, el enjambre de agentes articuló una hipótesis mecanicista coherente.
El informe concluyó que el bloqueo del transporte axonal impide el retorno normal del colesterol al soma celular. Al percibir un déficit local, el núcleo activa la vía SREBP para una síntesis compensatoria, agravando la degeneración neuronal. Una segmentación precisa de tareas tiende puentes entre disciplinas aisladas: esta deducción brinda una diana terapéutica totalmente nueva para el desarrollo de fármacos.
La computación resuelve el cuello de botella de las hipótesis, pero el laboratorio húmedo sigue dictando sentencia
Resolver miles de deducciones complejas en 32 minutos es un hito llamativo. Sin embargo, en las ciencias de la vida el veredicto final siempre corresponde a las moléculas del mundo físico. Una extensa bibliografía demuestra un amplio campo de búsqueda, no una verdad incuestionable. Las deducciones que no han pasado por la placa de Petri y la pipeta siguen siendo, a fin de cuentas, una lista de hipótesis a la espera de confirmación.
Los propios científicos implicados subrayan que los mecanismos planteados por los agentes deben ser corroborados en ensayos de laboratorio húmedo. La IA no sustituye el trabajo manual de los biólogos experimentales, sino que transforma la manera en que se formulan las hipótesis científicas. Si antes un investigador requería meses para aislar una sola hipótesis plausible, ahora los algoritmos entregan conjeturas sólidamente respaldadas directamente a la mesa de trabajo.
Solo cuando los procesos de investigación se descomponen con suficiente precisión, la capacidad de cálculo se convierte en un auténtico acelerador del descubrimiento científico. El rumbo de la IA en biomedicina se vuelve cada vez más nítido: no es necesario esperar a un modelo monolítico omnisciente. Mediante una rigurosa división del trabajo y mecanismos de contraste recíproco, cientos de micro-agentes pueden coordinarse para formar un equipo de vanguardia científica de máxima eficacia.
Enlaces de referencia:
- Informe oficial de OpenAI: Escalado de la investigación en IA para datos biológicos complejos
- Preprint en bioRxiv: Agentes de IA distribuidos permiten la síntesis a gran escala de conocimientos biológicos
- Cobertura en R&D World: OpenAI despliega casi 2.000 agentes GPT-Rosalind para generar pistas biológicas en 32 minutos
- Proyecto de código abierto en GitHub: Grafo de razonamiento biológico con agentes distribuidos