En las pruebas de rendimiento de TPC-H, la interfaz de línea de comandos (CLI) de DuckDB 2.0.0 reduce en un 59% el volumen de salida que los modelos de lenguaje (LLM) deben procesar. Con el nombre en clave «Cinnamon Teal» (cerceta colorada, de nombre científico Spatula cyanoptera), esta versión de soporte a largo plazo (LTS) consolida casi 20.000 commits desde la versión 1.5. Una base de datos integrada en el propio proceso se ha rediseñado para interactuar con agentes autónomos, almacenamiento en la nube y ciclos operativos prolongados: DuckDB ha completado su transición de herramienta de análisis local a infraestructura de datos lista para entornos de producción.
 Figura: Nombre en clave y ciclo de soporte de DuckDB 2.0.0 LTS. Esta versión contará con mantenimiento activo hasta octubre de 2027. Fuente: Blog oficial de DuckDB
Durante años, la comunidad técnica concibió DuckDB como el complemento idóneo para cuadernos interactivos de ciencia de datos. Sin embargo, en la versión 2.0, los usuarios finales, la tipología de los datos y los entornos de despliegue han cambiado radicalmente. Cada vez son más los agentes de programación (Coding Agents) que redactan y ejecutan consultas SQL; los datos de entrada llegan como documentos semiestructurados y heterogéneos; y la persistencia reside en almacenamiento de objetos en la nube. Reconfigurar el núcleo en torno a estas nuevas cargas de trabajo constituye el hilo conductor de este hito de lanzamiento.
Detección automática de agentes en la CLI: reducción del 59% en la salida
En la actualidad, quien ejecuta el comando duckdb en una terminal suele ser un agente de IA como Claude Code, Codex o Cursor. Aunque los desarrolladores humanos aprecian tablas formateadas con bordes ASCII, para los modelos que facturan por token cada espacio y delimitador se convierte en ruido costoso. El consumidor primario de las interfaces de bases de datos está cambiando de los ojos humanos a la ventana de contexto de los modelos.
La CLI de DuckDB 2.0 detecta al arrancar si está siendo operada por un agente y pasa automáticamente al modo agent mode. En esta modalidad, los resultados se entregan como tablas Markdown compactas, los conjuntos de datos extensos indican explícitamente sus puntos de truncamiento y los errores se estructuran en formato JSON. Quienes desarrollan pueden activar este modo con la opción -agent para depuración o volver a la interfaz tradicional mediante -no-agent.
Más allá de compactar la salida, este modo actúa como cortafuegos operativo. Las consultas de ejecución prolongada calculan su coste estimado antes de arrancar, permitiendo al agente evaluar si debe esperar o replantear el enfoque; en caso de que una consulta se descontrole, la CLI activa automáticamente un mecanismo de interrupción (circuit breaker). Permitir que la base de datos informe proactivamente de los costes e intercepte consultas lentas soluciona un grave cuello de botella: los bucles de ensayo y error ciegos de los agentes que bloquean terminales y canalizaciones automatizadas.
I/O asíncrona para almacenamiento remoto y soporte columnar completo de VARIANT
A medida que los agentes y los flujos automatizados asumen la carga analítica, los orígenes de datos escapan de los discos locales. La versión 2.0 introduce entrada y salida asíncrona (Asynchronous I/O) para Parquet, CSV y el formato de almacenamiento nativo de DuckDB. La capa de I/O se desacopla formalmente del motor de ejecución: hilos en segundo plano lanzan múltiples solicitudes de lectura concurrentes sin bloquear los operadores vectorizados en primer plano.
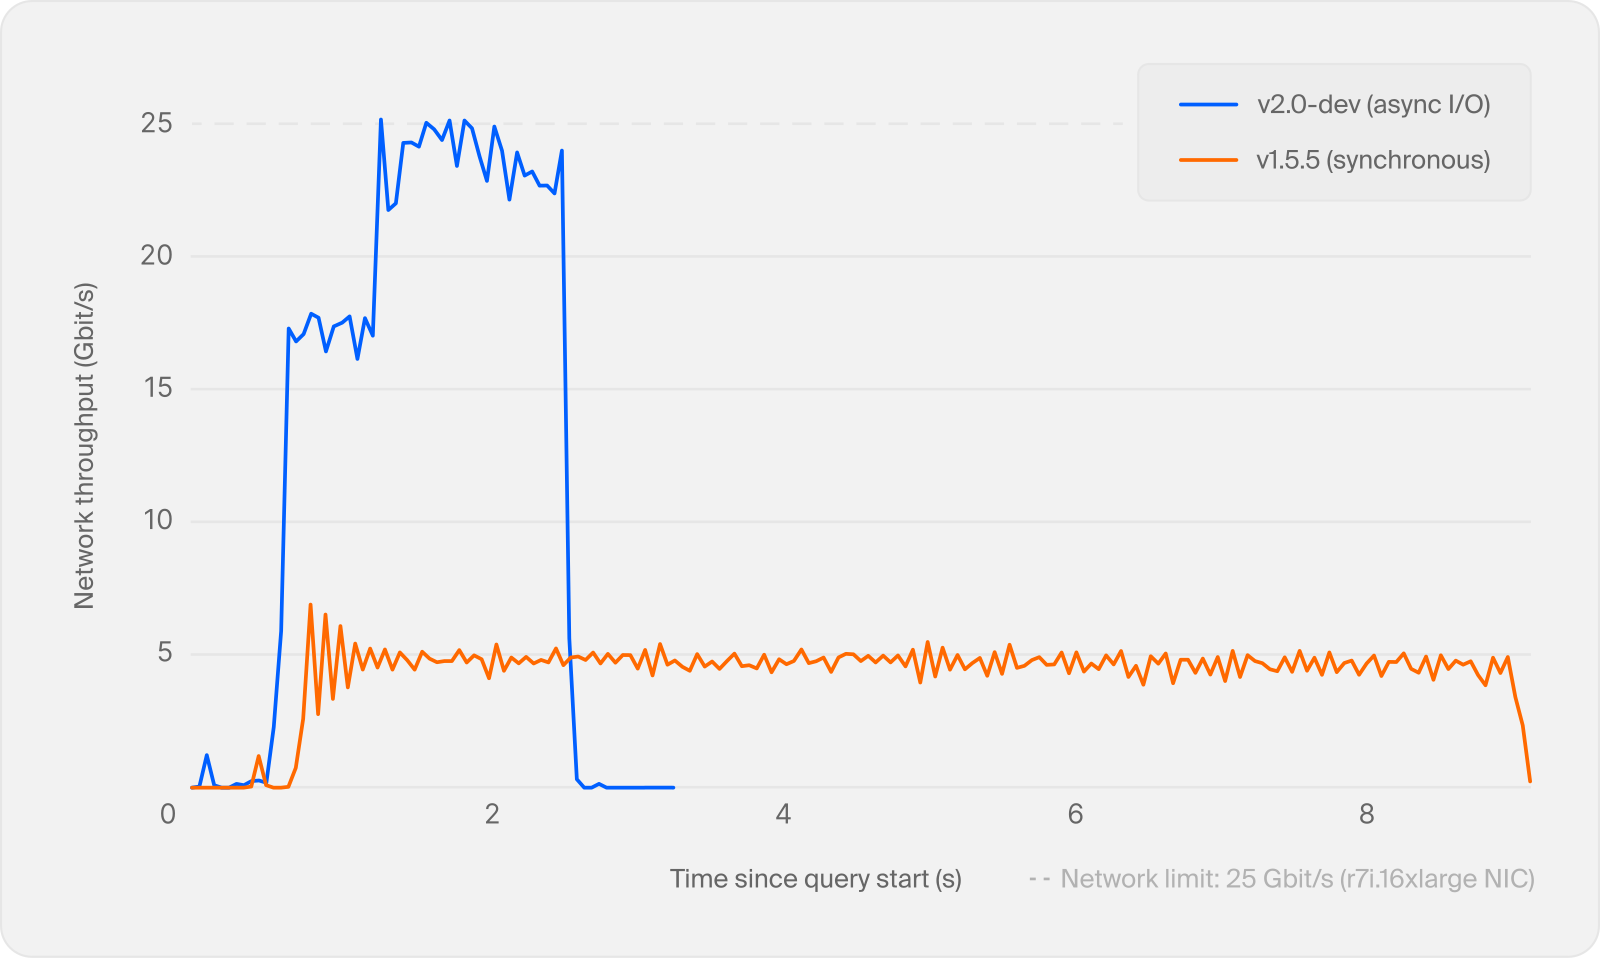 Figura: Al habilitar la I/O asíncrona, el aprovechamiento del ancho de banda durante la consulta mejora sustancialmente, eliminando los valles de rendimiento provocados por la espera síncrona. Fuente: Blog oficial de DuckDB
En unidades SSD locales, la latencia de las esperas síncronas es tolerable. No obstante, frente a almacenamientos de objetos como s3://, las peticiones secuenciales dejan la interfaz de red infrautilizada. La I/O asíncrona maximiza el rendimiento y reduce drásticamente el tiempo de ejecución en la nube. Tratar el almacenamiento de objetos como ciudadano de primera clase elimina la tediosa tarea previa de descargar conjuntos de datos remotos a discos locales para poder consultarlos.
La evolución en las formas de los datos es igualmente patente. Los registros operativos y las respuestas de API suelen presentarse como líneas JSON sin esquema homogéneo. Tras la prueba de concepto del tipo VARIANT en la versión 1.5, la versión 2.0 lo integra plenamente en la canalización columnar. El motor detecta patrones comunes y aplica particionado columnar dinámico (shredding), garantizando compatibilidad de lectura y escritura con Parquet y funciones especializadas como variant_type(payload) y variant_keys(payload). Procesar datos semiestructurados a la velocidad de un motor columnar borra la fricción habitual entre almacenes documentales y analítica relacional.
Protocolo Quack y disparadores: asumiendo funciones de servidor
Hasta ahora, integrar DuckDB en producción encontraba reticencias por la falta de una arquitectura cliente-servidor formal. El protocolo Quack y la extensión quack, presentados en mayo con la versión 1.5.3, alcanzan en 2.0 un nivel de madurez estable. En el servidor solo se requiere ejecutar CALL quack_serve(token = 'my_token'); los clientes pueden asociar bases de datos remotas usando ATTACH junto con la nueva cláusula CONNECT en una única instrucción.
Por motivos de seguridad, los servidores Quack escuchan únicamente en localhost de manera predeterminada. Las recomendaciones oficiales sugieren situar un proxy inverso con autenticación y terminación TLS para accesos entre máquinas, reservando allow_other_hostname para entornos de prueba. Además, la instrucción CONNECT puede vincularse directamente con PostgreSQL y MySQL, permitiendo al nuevo optimizador de empuje remoto (Remote Pushdown) trasladar la ejecución de consultas a la fuente remota. El motor local asume así el papel de enrutador de consultas federadas, impidiendo el colapso de ancho de banda que implicaría transferir tablas gigantescas a la memoria local.
En cuanto al estándar SQL, 2.0 incorpora soporte completo para CREATE TRIGGER, cubriendo eventos BEFORE y AFTER, a nivel de fila o sentencia, además de tablas de transición mediante REFERENCING OLD/NEW TABLE. Aunque ciertas combinaciones como BEFORE ... FOR EACH ROW y UPDATE ... FOR EACH ROW continúan en desarrollo, las capacidades actuales cubren el registro de auditoría y el mantenimiento incremental de vistas materializadas. Por ejemplo, al vincular disparadores de inserción y borrado a una tabla de empleados, es posible actualizar en tiempo real el promedio de edad por nacionalidad sin necesidad de recalcular toda la tabla periódicamente. La incorporación de triggers permite a DuckDB gestionar internamente estados ligeros sin depender de tareas cron o scripts externos.
Parser PEG y repositorios propios de extensiones: bases para una evolución a largo plazo
Cuando un motor asume responsabilidades de infraestructura, la extensibilidad sintáctica y la seguridad de la cadena de suministro deben responder a las máximas exigencias. Desde su primer commit en 2018, DuckDB dependía de un parser LALR(1) generado por YACC/Bison heredado de PostgreSQL. A medida que el dialecto crecía, cualquier pequeña modificación en las reglas gramaticales tendía a colisionar con normas preexistentes, provocando conflictos de tipo shift/reduce.
DuckDB 2.0 establece como analizador por defecto un nuevo parser PEG (Parsing Expression Grammar), manteniendo la extensión legacy_parser como alternativa de respaldo. El parser PEG evalúa las reglas en orden explícito, aislando las nuevas construcciones sintácticas de ramas no relacionadas y proporcionando diagnósticos de error con precisión en el código fuente. Las extensiones de terceros ahora pueden inyectar sintaxis propia directamente en el árbol abstracto, y junto a la publicación de la API C v2, componentes clave como sistemas de archivos y funciones de tabla se abren a una arquitectura modular. El salto a PEG derriba las barreras para que equipos externos adapten y amplíen el dialecto SQL sin tener que mantener bifurcaciones del código fuente original.
Para satisfacer las normativas internas corporativas, 2.0 permite desplegar repositorios de extensiones de confianza autohospedados. El personal de administración puede asociar prefijos de URL y claves públicas RSA con CREATE EXTENSION REPOSITORY; DuckDB fija la clave en el registro y expone una huella SHA-256 para verificación. Al mismo tiempo, DuckLake 1.1 y las extensiones Iceberg y Delta reciben actualizaciones esenciales: Iceberg soporta catálogos REST, mientras que Delta añade creación de tablas y consultas de viaje en el tiempo (Time Travel). Dentro de la comunidad existen posturas diversas ante este despliegue hacia funciones de servidor, disparadores y repositorios corporativos: mientras que algunos temen que el núcleo analítico pierda su característica ligereza, la opinión mayoritaria valora concentrar estas funciones recurrentes en extensiones y protocolos oficiales frente a la dispersión de código de integración ad-hoc.
En el plano del ciclo de vida, la dirección técnica de DuckDB ha establecido compromisos firmes: DuckDB 2.0.0 LTS recibirá soporte activo al menos hasta octubre de 2027. Sumado a la rama 1.5 con mantenimiento hasta marzo de 2027 y la 1.4 hasta finales de noviembre de 2026, el proyecto gestiona tres líneas de producción simultáneas. Aunque las librerías cliente para Go, R y Java completarán su adaptación técnica en los próximos días, este horizonte temporal confirma su nueva identidad: un motor de base de datos embebido que integra interacción nativa con agentes, I/O asíncrona en la nube, almacenamiento columnar semiestructurado y soporte LTS prolongado, orientándose a convertirse en el cimiento del ecosistema de datos moderno.
Enlaces de referencia:
- Anuncio oficial de DuckDB 2.0.0 LTS
- Discusión de la comunidad en Hacker News