在 TPC-H 基准测试中,DuckDB 2.0.0 的命令行工具(CLI,Command Line Interface)把模型需要读取的输出体积削减了 59%。这个代号为「Cinnamon Teal」(桂红鸭,学名 Spatula cyanoptera)的长期支持版,自 1.5 版本以来合并了近 20000 个 commit。一个单机进程内数据库开始为机器调用者、云端存储和长周期运维做设计;它已经从本地分析工具变成了生产环境的数据基础设施。
 图:DuckDB 2.0.0 LTS 版本代号与支持周期说明,该版本将持续维护至 2027 年 10 月。来源:DuckDB 官方博客
过去几年里,外界习惯把 DuckDB 当作数据科学家的笔记本伴侣。到了 2.0 版本,它的服务对象、数据形态和部署位置都发生了转移。写 SQL 的一方越来越多是编程智能体(Coding Agent);上游数据变成了结构多变的半结构化文档,数据存放点也搬到了远端对象存储。围绕这些新主顾重塑内核,构成了这次大版本更新的主线。
CLI 自动识别 Agent,把输出体积砍掉 59%
如今在终端里敲入 duckdb 命令的,往往是 Claude Code、Codex 或 Cursor 这类编程智能体。人类偏爱带边框填充的字符表格;但对按 token 计费的模型来说,满屏的制表符与空格全是昂贵的噪音。数据库交互界面的默认消费者,正在从人类眼球转向模型的上下文窗口。
DuckDB 2.0 的 CLI 会在启动时自动检测自身是否由智能体驱动,并无缝切换至 agent mode。在这个模式下,CLI 改用紧凑的 Markdown 表格输出结果;遇到超长结果集时它会明确标注截断信息,并将报错统一格式化为 JSON。开发者可以通过 -agent 参数手动开启该模式进行调试,也能用 -no-agent 强制退回传统界面。
除了压缩输出体积,这个模式还替智能体加上了护栏。长耗时查询在执行前会先报告预期计算成本,由智能体自行评估是否继续等待;一旦查询失控,CLI 会主动提前熔断。让数据库主动汇报查询代价并拦截慢查询,直接解决了智能体盲目试错时卡死终端流水线的工程难题。
异步 I/O 解耦网络读取,VARIANT 打通半结构化管线
智能体与自动化流水线接管查询后,数据源的位置与格式也超出了本地单机的传统边界。2.0 版本为 Parquet、CSV 以及 DuckDB 原生存储格式引入了异步输入输出(Asynchronous I/O)。I/O 层与查询处理层正式解耦;后台线程可以同时发出多个读取请求,不再阻塞前台算子。
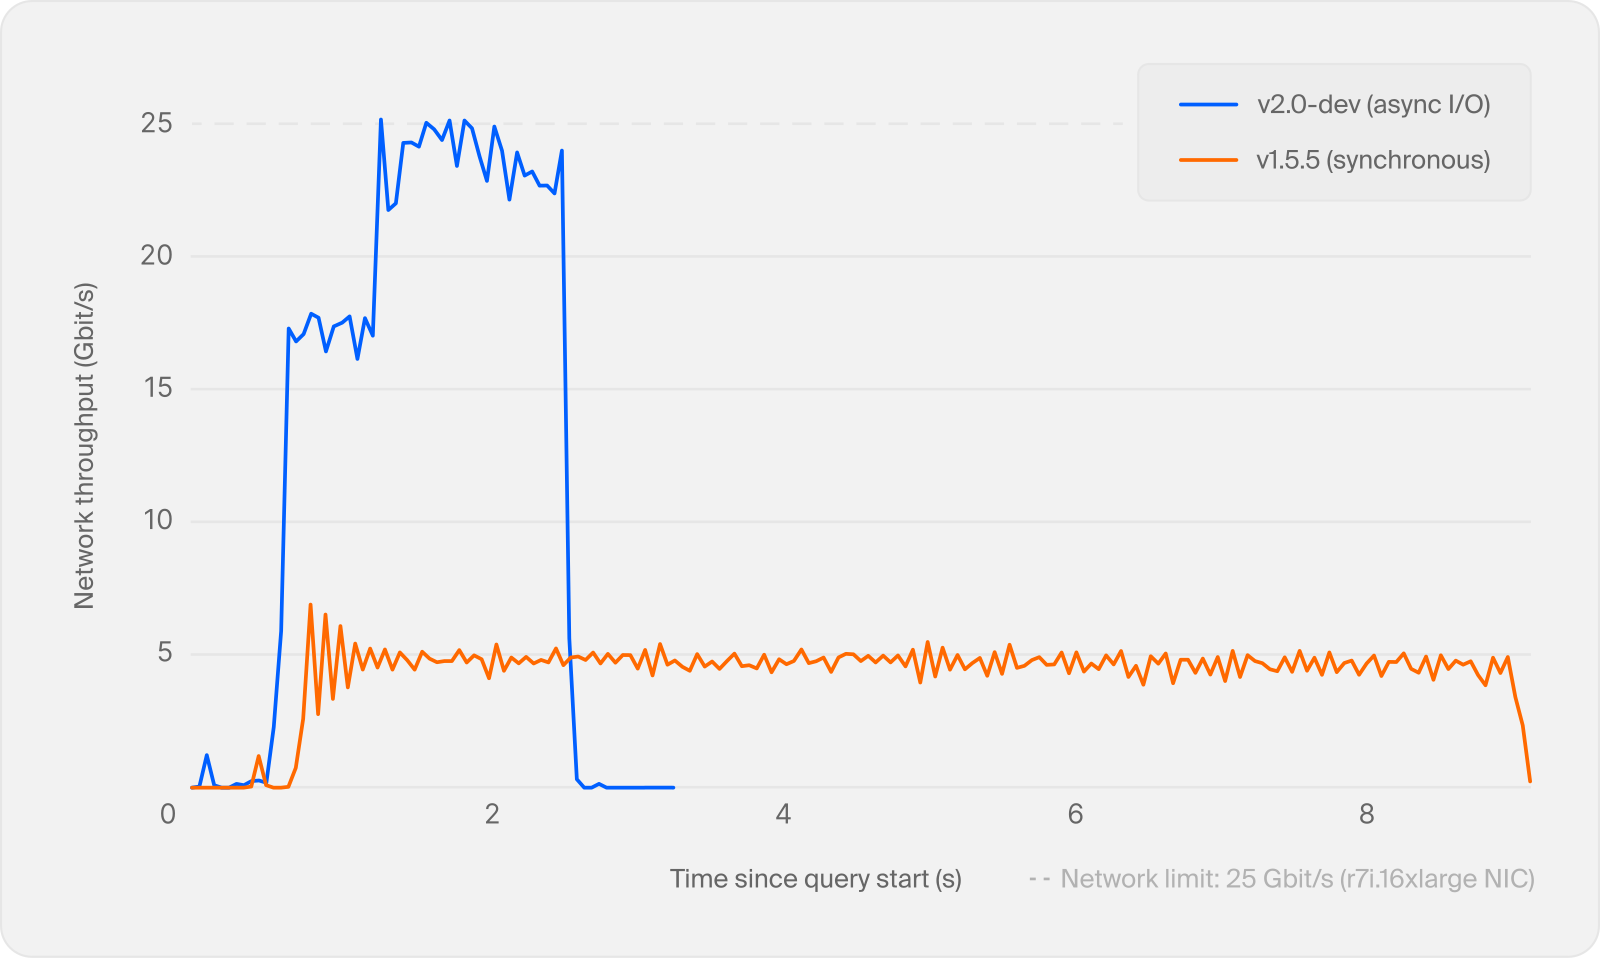 图:开启异步 I/O 后,单次查询过程中的网络带宽利用率明显拉升,消除了同步等待造成的吞吐低谷。来源:DuckDB 官方博客
在本地磁盘上,同步等待的延迟尚可忍受。但面对 s3:// 这类高延迟对象存储,串行请求会让网卡长期闲置。异步 I/O 大幅拉升了网络吞吐利用率,缩短了云端分析任务的总运行时间。把对象存储当作一等公民来优化吞吐,让单机引擎省去了先将数据同步到本地磁盘的繁琐步骤。
数据形态的变化同样直接。上游日志与接口返回往往是一行一个模样的 JSON;为此 1.5 版本曾试水引入 VARIANT 类型,而 2.0 将它完整接进了列式管线。引擎会自动识别公共结构并执行列式切分(Shredding);它打通了从底层存储到 Parquet 的读写,并配齐 variant_type(payload)、variant_keys(payload) 等函数。用列式引擎的速度直接跑无固定模式的半结构化数据,抹平了文档型数据与关系型分析之间的转换损耗。
Quack 协议定型与触发器补齐,单机引擎接管服务端活计
过去把 DuckDB 塞进生产环境,常会遇到缺乏标准服务端形态的阻力。今年 5 月的 1.5.3 版本首次引入了 Quack 协议与 quack 扩展;2.0 版本则将这套客户端-服务器架构打磨定型。服务端只需执行 CALL quack_serve(token = 'my_token');客户端即可通过 ATTACH 配合新增的 CONNECT 语句,一步完成远端库挂载与切换。
出于安全考量,Quack 服务端默认只监听 localhost。官方建议跨机访问时在前端挂载负责 TLS 终止的反向代理,仅在测试环境使用 allow_other_hostname。同时,CONNECT 语句还能连向 PostgreSQL 与 MySQL;全新的远端下推(Remote Pushdown)优化器会把查询直接下推给远端执行。单机引擎借此具备了联邦查询路由器的能力,避免了把远端整张大表拉回本地内存的带宽灾难。
在 SQL 能力上,2.0 新增了 CREATE TRIGGER 语法;它支持 BEFORE 与 AFTER、行级与语句级触发,并可通过 REFERENCING OLD/NEW TABLE 读取过渡表(Transition Table)。虽然 BEFORE ... FOR EACH ROW 与 UPDATE ... FOR EACH ROW 等组合尚待补齐,但现有能力已足够支撑审计表与物化视图的增量维护。例如在人员表上挂载插入与删除触发器,即可实时维护按国籍分组的平均年龄;整个过程无需每次全表重算。触发器的加入让 DuckDB 能够独立承担轻量级状态维护,进一步减少了对外部调度脚本的依赖。
换用 PEG 解析器与自建扩展仓库,为长周期演进铺路
引擎开始承担基础设施角色后,语法扩展与供应链安全就必须经得起折腾。自 2018 年提交第一个 commit 以来,DuckDB 一直沿用源自 PostgreSQL、由 YACC/Bison 生成的 LALR(1) 解析器。随着方言规模膨胀,哪怕改动很小的语法规则都容易撞上已有规则,抛出 shift/reduce 冲突。
2.0 版本将全新的解析表达文法(PEG,Parsing Expression Grammar)解析器设为默认选项,同时保留 legacy_parser 扩展供回退。PEG 按照书写顺序匹配备选规则,新增语法不再牵连无关分支;报错信息也能给出精确的源码位置。第三方扩展现在可以直接挂载进语法树;配合同步发布的 C API v2,文件系统与表函数等组件也向扩展全面敞开。用 PEG 替换传统解析器,扫清了外部团队在不修改内核源码的前提下深度定制 SQL 方言的障碍。
面对企业内网的合规要求,2.0 还允许组织自建可信扩展仓库。管理员执行 CREATE EXTENSION REPOSITORY 即可绑定 URL 前缀与 RSA 公钥;DuckDB 会在创建时固定公钥并打印 SHA-256 指纹供核验。与此同时,DuckLake 1.1 与 Iceberg、Delta 扩展也同步更新;其中 Iceberg 扩展支持挂载 REST 目录,Delta 扩展则补上了建表与时间旅行能力。围绕这波向服务端、触发器与企业级仓库的扩张,社区内部也有不同声音。一部分开发者担忧特性膨胀会让原本轻巧的分析内核背上历史包袱;另一派则认为,将高频周边能力收敛进官方扩展与标准协议,比每个团队各自拼凑胶水代码更易维护。
从维护周期看,DuckDB 官方给出了明确承诺:2.0.0 LTS 将至少支持到 2027 年 10 月;1.5 分支也延长至 2027 年 3 月,与支持到 2026 年 11 月底的 1.4 分支构成三条并行产品线。尽管 Go、R、Java 等部分客户端库还需等待数日才能完成适配,但跨年的版本保障已经亮明了它的新身份。一个单机数据库把智能体交互、云端异步读取、半结构化列存与长周期维护全部收进标准版图;它瞄准的早已是下一代数据栈的底座。
参考链接:
- DuckDB 2.0.0 LTS 官方发布公告
- Hacker News 社区讨论