In TPC-H-Benchmarks reduziert das Command-Line-Interface (CLI) von DuckDB 2.0.0 das von LLMs einzulesende Ausgabevolumen um 59 Prozent. Diese Long-Term-Support-Version mit dem Codenamen „Cinnamon Teal“ (Zimtente, wissenschaftlich Spatula cyanoptera) vereint fast 20.000 Commits seit Version 1.5. Eine prozessinterne Datenbank wurde von Grund auf für autonome Maschinenaufrufe, Cloud-Objektspeicher und mehrjährigen Betrieb ausgelegt: DuckDB hat sich endgültig vom lokalen Analysewerkzeug zur Dateninfrastruktur für Produktionsumgebungen gewandelt.
 Abb.: Versionscodename und Supportzyklus von DuckDB 2.0.0 LTS. Diese Version wird bis Oktober 2027 gepflegt. Quelle: Offizieller DuckDB-Blog
In den vergangenen Jahren galt DuckDB vor allem als verlässlicher Begleiter für Data Scientists in Jupyter Notebooks. Mit Version 2.0 haben sich Zielgruppe, Datenstrukturen und Einsatzorte grundlegend verschoben: SQL-Abfragen werden immer häufiger von Coding-Agenten generiert und ausgeführt; Quelldaten treffen zunehmend als schemalose, halbstrukturierte JSON-Dokumente ein; und der persistente Speicher liegt in entfernten Cloud-Objektspeichern. Die Kernarchitektur rund um diese neuen Anforderungen neu zu ordnen, bildet den roten Faden dieses Meilensteins.
CLI erkennt Agenten automatisch und senkt Ausgabevolumen um 59%
Wer heute duckdb im Terminal startet, ist oft kein Mensch mehr, sondern ein Coding-Agent wie Claude Code, Codex oder Cursor. Menschliche Entwickler schätzen tabellarische ASCII-Ausgaben mit Rahmen; für Modelle, die nach Token abgerechnet werden, stellen Leerzeichen und Rahmenstriche jedoch teures Rauschen dar. Der primäre Konsument von Datenbankschnittstellen verlagert sich von menschlichen Augen hin zu den Kontextfenstern von Sprachmodellen.
Das CLI von DuckDB 2.0 erkennt beim Start automatisch, ob es von einem KI-Agenten gesteuert wird, und schaltet nahtlos in den agent mode. In diesem Modus formatiert das CLI Tabellen als kompaktes Markdown, versieht abgeschnittene Ergebnismengen mit expliziten Grenzhinweisen und gibt Fehlermeldungen strukturiert als JSON zurück. Entwickler können diesen Modus mit -agent manuell zum Debuggen aktivieren oder mit -no-agent das traditionelle Interface erzwingen.
Über die reine Datenkompaktierung hinaus dient der Agentenmodus als Sicherheitsgurt: Ressourcenintensive Abfragen berechnen vorab ihre geschätzten Ausführungskosten, damit der Agent entscheiden kann, ob sich das Warten lohnt. Läuft eine Abfrage aus dem Ruder, greift die CLI-interne Notabschaltung ein. Dass die Datenbank ihre Abfragekosten proaktiv meldet und langsame Abfragen abfängt, löst ein akutes Problem: Terminal-Pipelines werden nicht mehr durch blindes Trial-and-Error von Agenten blockiert.
Asynchrone I/O entkoppelt Netzwerkabfragen, VARIANT meistert halbstrukturierte Daten
Wenn automatisierte Pipelines und Agenten die Abfragen übernehmen, liegen die Datenbestände selten noch auf lokalen NVMe-Laufwerken. Version 2.0 führt asynchrone I/O (Asynchronous I/O) für Parquet, CSV und das native DuckDB-Speicherformat ein. Die I/O-Schicht ist nun sauber von der Ausführungsschicht entkoppelt: Hintergrund-Threads setzen parallele Leseanfragen ab, ohne die vorrangigen Vektoroperatoren zu blockieren.
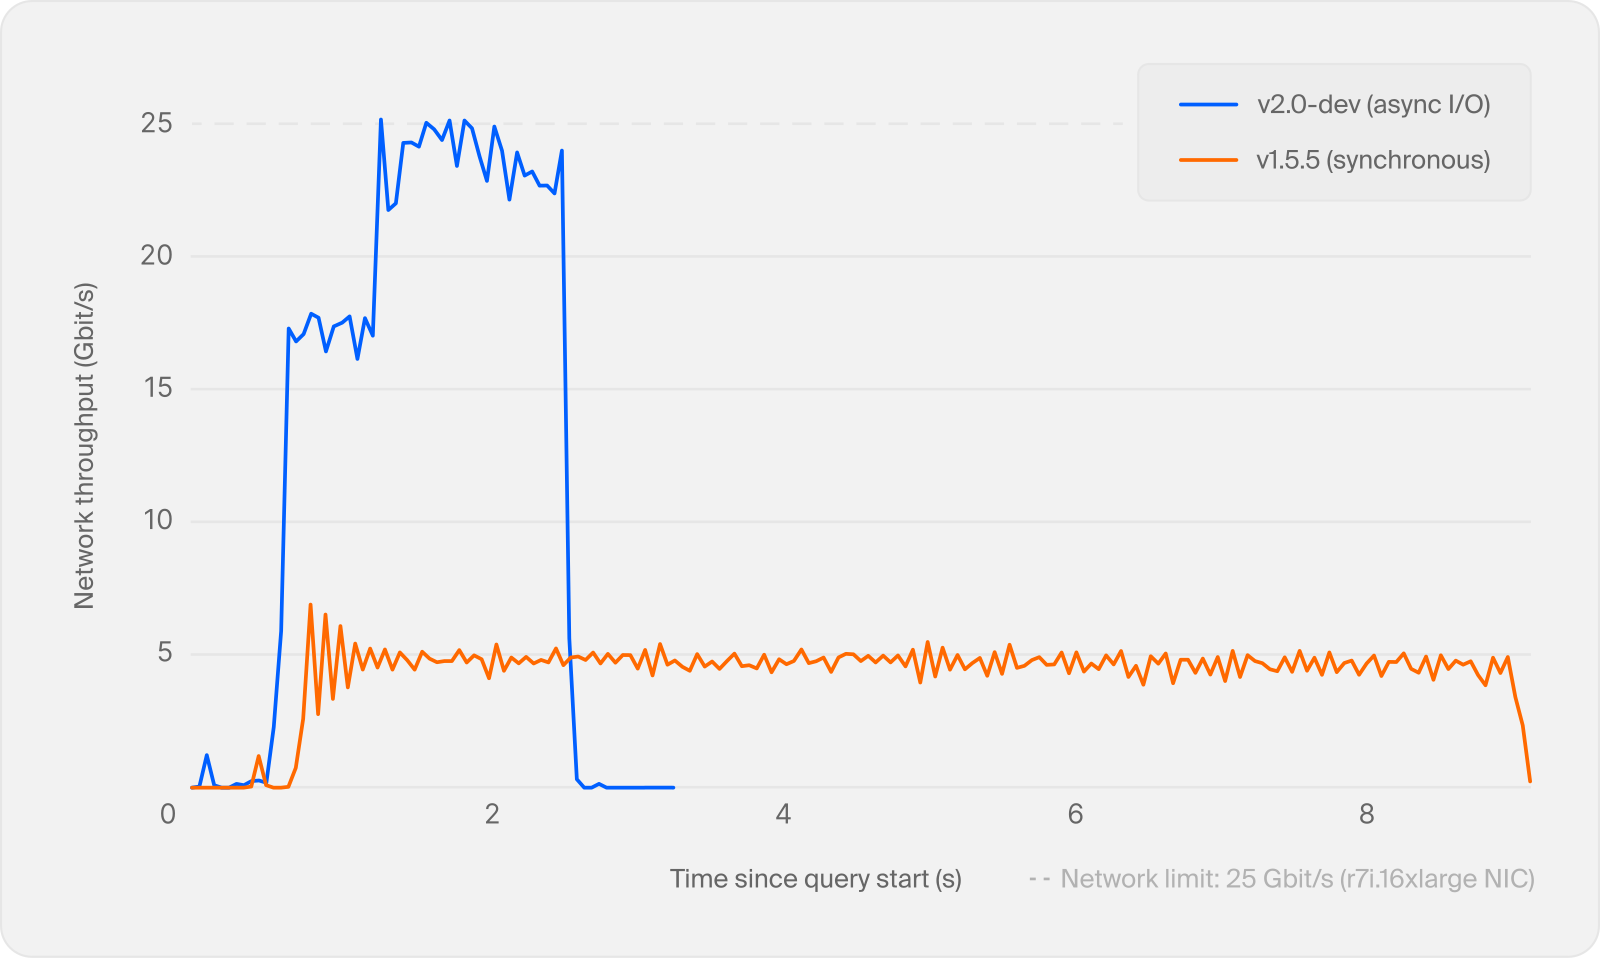 Abb.: Durch asynchrone I/O wird die verfügbare Netzwerkbandbreite während einer Abfrage gleichmäßig ausgelastet; Einbrüche durch synchrones Warten entfallen. Quelle: Offizieller DuckDB-Blog
Auf lokalen SSDs fällt die synchrone Wartezeit kaum ins Gewicht. Bei Verbindungen zu Latenz-behafteten Objektspeichern wie s3:// führt sequentielles Abrufen jedoch dazu, dass Netzwerkkarten die meiste Zeit im Leerlauf verharren. Asynchrone I/O maximiert den Durchsatz und verkürzt die Gesamtlaufzeit von Cloud-Analysen spürbar. Die erstklassige Optimierung für Objektspeicher erspart es Entwicklern, entfernte Datensätze vor der Analyse erst langwierig auf lokale Festplatten spiegeln zu müssen.
Parallel dazu haben sich die Datenformen verändert: Upstream-Logs und API-Antworten bestehen meist aus zeilenbasiertem JSON mit wechselndem Schema. Nachdem Version 1.5 den VARIANT-Typ versuchsweise einführte, bindet 2.0 ihn vollständig in die spaltenbasierte Pipeline ein. Die Engine erkennt wiederkehrende Teilstrukturen automatisch und zerlegt sie spaltenweise (Shredding). Zudem integriert sie nahtlos in Parquet und bringt Hilfsfunktionen wie variant_type(payload) und variant_keys(payload) mit. Halbstrukturierte Daten direkt mit der Geschwindigkeit einer spaltenbasierten Engine abzufragen, beseitigt den bisherigen Konvertierungsaufwand zwischen Dokumentenspeichern und relationalen Analysen.
Quack-Protokoll und Trigger: Die Engine übernimmt Server-Aufgaben
Bislang gestaltete sich der produktive Einsatz von DuckDB oft schwierig, weil es an einer standardisierten Server-Architektur fehlte. Das im Mai mit Version 1.5.3 vorgestellte Quack-Protokoll samt quack-Erweiterung wurde in 2.0 zu einer stabilen Client-Server-Architektur ausgebaut. Auf Serverseite genügt ein Aufruf von CALL quack_serve(token = 'my_token'); Clients binden entfernte Datenbanken mit ATTACH und dem neuen Befehl CONNECT direkt an.
Aus Sicherheitsgründen lauscht der Quack-Server standardmäßig ausschließlich auf localhost. Für den maschinenübergreifenden Zugriff empfiehlt das Projekt einen vorgeschalteten Reverse-Proxy mit TLS-Terminierung; der Schalter allow_other_hostname ist Testumgebungen vorbehalten. Zudem kann CONNECT direkte Verbindungen zu PostgreSQL und MySQL herstellen, wobei der neue Remote-Pushdown-Optimierer Abfragen direkt an das Zielsystem delegiert. Damit fungiert die lokale Engine als föderierter Abfrage-Router und verhindert, dass riesige Tabellen unnötig über das Netzwerk in den lokalen Arbeitsspeicher geladen werden müssen.
Im SQL-Funktionsumfang führt 2.0 den Befehl CREATE TRIGGER ein. Unterstützt werden BEFORE- und AFTER-Trigger auf Zeilen- und Statement-Ebene sowie Übergangstabellen über REFERENCING OLD/NEW TABLE. Auch wenn Kombinationen wie BEFORE ... FOR EACH ROW und UPDATE ... FOR EACH ROW noch in Arbeit sind, reicht der aktuelle Stand für Audit-Protokolle und die inkrementelle Aktualisierung materialisierter Sichten völlig aus. Wird beispielsweise ein Trigger für Einfüge- und Löschoperationen auf einer Personaltabelle eingerichtet, lässt sich das Durchschnittsalter nach Nationalität in Echtzeit pflegen, ohne die Tabelle jedes Mal komplett neu zu scannen. Mit nativen Triggern kann DuckDB leichtgewichtige Zustandsverwaltungen autonom steuern, ohne auf externe Cronjobs oder Skripte angewiesen zu sein.
PEG-Parser und eigene Extension-Repositories schaffen Basis für langfristige Evolution
Wächst ein Datenbanksystem in die Rolle einer Kerninfrastruktur hinein, müssen Grammatikerweiterungen und Lieferkettensicherheit höchsten Ansprüchen genügen. Seit dem ersten Commit im Jahr 2018 setzte DuckDB auf einen von YACC/Bison generierten LALR(1)-Parser aus der PostgreSQL-Codebasis. Mit wachsendem Sprachumfang kollidierten jedoch selbst kleinste Anpassungen mit bestehenden Regeln und provozierten shift/reduce-Konflikte.
Version 2.0 macht einen neuen Parsing-Expression-Grammar-Parser (PEG) zum Standard, behält aber die Erweiterung legacy_parser zur Rückfallebene bei. Der PEG-Parser arbeitet Regeln strikt in definierter Reihenfolge ab, wodurch neue Syntaxzweige isoliert bleiben und Fehlermeldungen die exakte Codestelle markieren. Drittanbieter-Erweiterungen können nun eigene Syntaxelemente direkt in den Syntaxbaum einhängen. In Kombination mit der zeitgleich veröffentlichten C API v2 öffnen sich interne Komponenten wie Dateisysteme und Tabellenfunktionen vollständig für modulare Erweiterungen. Der Wechsel zum PEG-Parser beseitigt die Barrieren für externe Teams, eigene SQL-Dialekte ohne Modifikationen am Kerncode einzubinden.
Um Compliance-Vorgaben in Unternehmensnetzwerken zu erfüllen, erlaubt 2.0 zudem den Betrieb eigener vertrauenswürdiger Erweiterungs-Repositories. Administratoren können über CREATE EXTENSION REPOSITORY URL-Präfixe mit RSA-Public-Keys verknüpfen; DuckDB speichert den Schlüssel ab und gibt zur Verifikation einen SHA-256-Fingerprint aus. Zeitgleich wurden DuckLake 1.1 sowie die Iceberg- und Delta-Erweiterungen aktualisiert: Iceberg unterstützt das Mounten von REST-Katalogen, Delta ergänzt Tabellenerstellung und Time-Travel-Abfragen. In der Community stößt diese Ausrichtung auf Serverfunktionen, Trigger und Enterprise-Features auch auf Skepsis: Manche Entwickler befürchten, dass der schlanke Kern überfrachtet werden könnte; die Befürworter halten dagegen, dass offizielle Erweiterungen und Standardprotokolle wesentlich wartungsfreundlicher sind als unzählige proprietäre Hilfsskripte.
Hinsichtlich des Lebenszyklus setzt DuckDB auf verlässliche Zusagen: Version 2.0.0 LTS wird bis mindestens Oktober 2027 unterstützt. Zusammen mit dem bis März 2027 gepflegten 1.5-Zweig und der 1.4-Linie (Support bis Ende November 2026) betreibt das Projekt nun drei parallele Schienen. Auch wenn Client-Bibliotheken für Go, R und Java noch wenige Tage für Anpassungen benötigen, untermauert dieser langfristige Horizont den neuen Anspruch: Eine prozessinterne Datenbank bündelt Agenteninteraktion, asynchrones Cloud-I/O, halbstrukturierte Spaltenspeicherung und mehrjährigen LTS-Support zu einem robusten Fundament moderner Datenarchitekturen.
Weiterführende Links:
- Offizielle Ankündigung zu DuckDB 2.0.0 LTS
- Diskussion in der Hacker News Community