Dans les benchmarks TPC-H, l’interface en ligne de commande (CLI) de DuckDB 2.0.0 réduit de 59 % le volume de données que les grands modèles de langage (LLM) doivent ingérer. Portant le nom de code « Cinnamon Teal » (sarcelle cannelle, nom scientifique Spatula cyanoptera), cette version à support étendu (LTS) intègre près de 20 000 commits depuis la version 1.5. Une base de données intégrée au processus se réinvente pour les appels d’agents autonomes, le stockage cloud et l’exploitation à long terme : DuckDB passe officiellement du statut d’outil d’analyse local à celui d’infrastructure de données pour la production.
 Figure : Nom de code et cycle de vie de DuckDB 2.0.0 LTS, maintenue activement jusqu’en octobre 2027. Source : Blog officiel de DuckDB
Pendant des années, DuckDB a été perçu avant tout comme le compagnon idéal des data scientists travaillant sur des notebooks interactifs. Avec la version 2.0, les profils d’utilisateurs, la nature des données et les environnements de déploiement changent d’échelle. L’écriture du SQL est de plus en plus souvent déléguée à des agents de codage (Coding Agents) ; les données sources se présentent sous forme de flux semi-structurés hétérogènes ; et le stockage persistant s’est déporté vers le stockage d’objets cloud. Reconstruire le moteur autour de ces nouveaux cas d’usage constitue le fil conducteur de cette mise à jour majeure.
Détection automatique des agents dans la CLI : 59% de volume en moins
Aujourd’hui, l’entité qui lance duckdb dans un terminal est fréquemment un agent autonome tel que Claude Code, Codex ou Cursor. Si les opérateurs humains apprécient les tableaux ASCII richement bordés, les modèles facturés au token voient dans ces espaces et délimiteurs un bruit particulièrement coûteux. Le consommateur par défaut des interfaces de bases de données bascule des yeux humains vers la fenêtre de contexte des modèles.
Au démarrage, la CLI de DuckDB 2.0 vérifie automatiquement si elle est pilotée par un agent et bascule sans friction en agent mode. Dans ce mode, les résultats sont formatés sous forme de tableaux Markdown compacts, les résultats tronqués indiquent clairement leurs limites et les messages d’erreur sont structurés en JSON. Les développeurs peuvent activer ce mode manuellement via -agent pour le débogage ou revenir à l’affichage traditionnel avec -no-agent.
Au-delà de la réduction de taille, ce mode fonctionne comme un garde-fou opérationnel. Les requêtes lourdes estiment leur coût de calcul avant exécution, permettant à l’agent d’évaluer s’il doit patienter ou interrompre la tâche. En cas d’emballement, la CLI déclenche d’elle-même un coupe-circuit. Le fait que la base de données communique proactivement ses coûts et intercepte les requêtes trop lentes résout une véritable difficulté d’ingénierie : les boucles d’essais-erreurs aveugles qui paralysent les pipelines de terminaux.
I/O asynchrone pour le stockage distant, VARIANT traite les données semi-structurées en colonnes
Dès lors que les agents et les pipelines automatisent les requêtes, les sources de données s’affranchissent des frontières du disque local. La version 2.0 apporte des entrées-sorties asynchrones (Asynchronous I/O) pour Parquet, CSV et le format de stockage natif de DuckDB. La couche I/O se découple formellement du moteur d’exécution : des threads d’arrière-plan émettent plusieurs requêtes de lecture en parallèle sans bloquer les opérateurs vectorisés au premier plan.
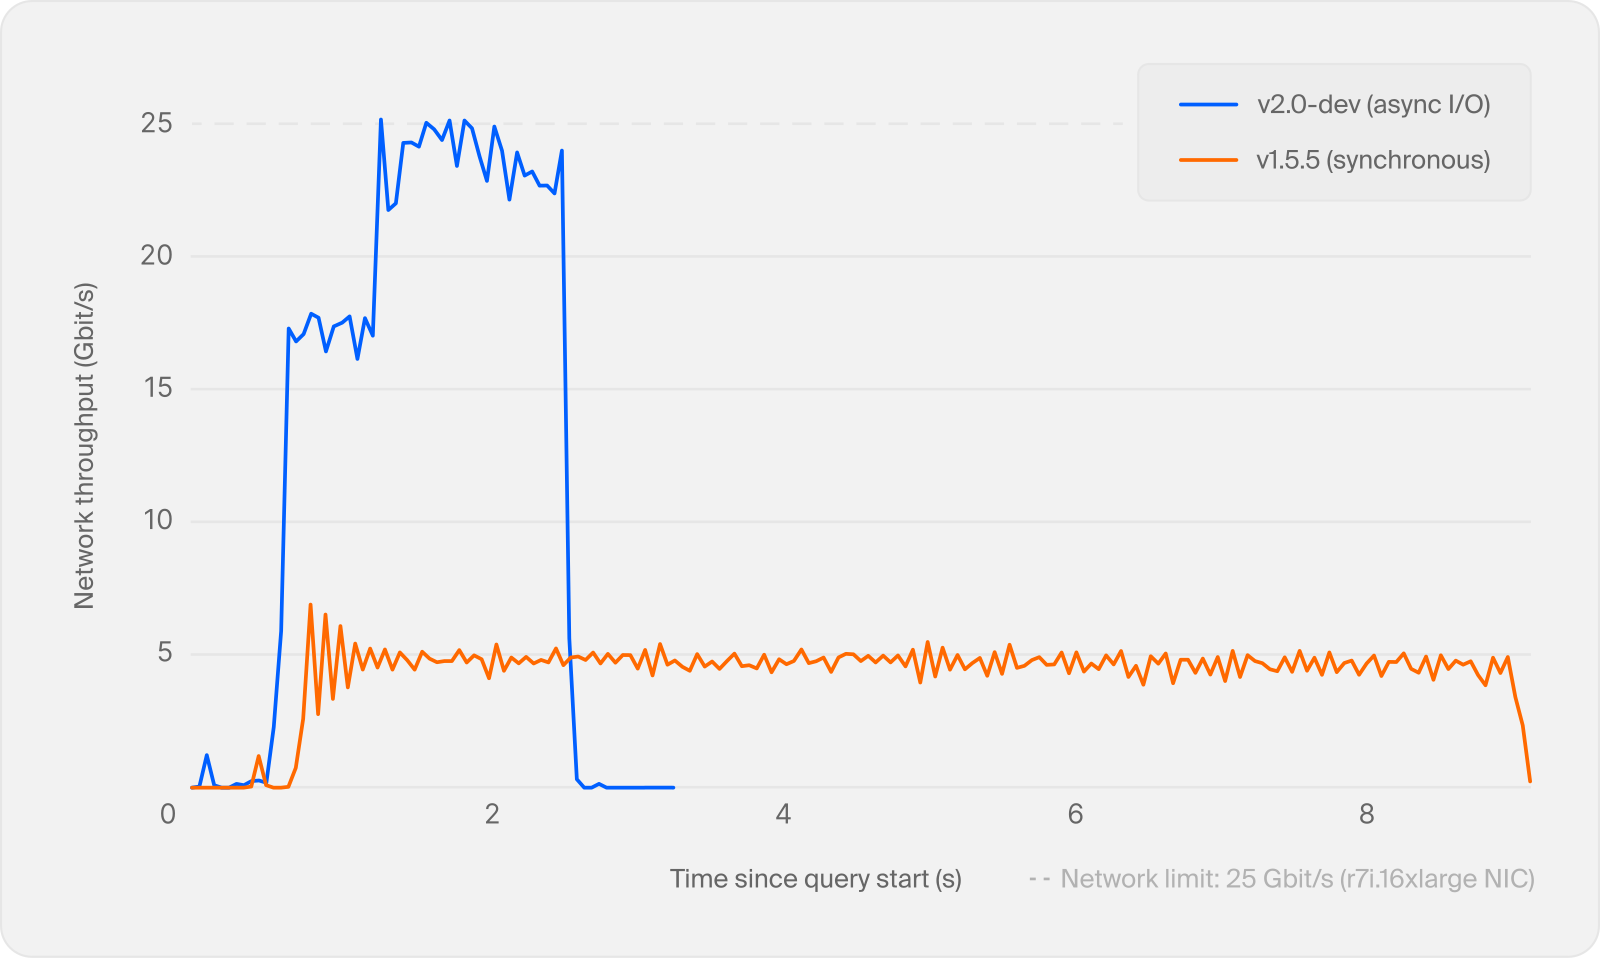 Figure : L’activation de l’I/O asynchrone améliore nettement l’exploitation de la bande passante réseau pendant l’exécution, éliminant les creux de débit dus aux attentes synchrones. Source : Blog officiel de DuckDB
Sur un SSD local, la latence des accès synchrones reste indolore. En revanche, face à du stockage d’objets distant comme s3://, des requêtes séquentielles sous-utilisent la carte réseau. L’I/O asynchrone sature efficacement le débit et réduit substantiellement la durée totale des analyses dans le cloud. Considérer le stockage d’objets comme un citoyen de premier ordre évite l’étape laborieuse consistant à rapatrier les données sur disque local avant de pouvoir les interroger.
L’évolution de la forme des données est tout aussi marquée. Les journaux et réponses d’API se présentent le plus souvent sous la forme de documents JSON sans schéma fixe. Après une introduction expérimentale dans la version 1.5, le type VARIANT s’intègre pleinement dans le moteur colonnaire de la 2.0. Le moteur identifie automatiquement les structures partagées et applique une découpe colonnaire dynamique (shredding). Il assure l’interopérabilité en lecture et écriture avec Parquet et propose des fonctions d’inspection dédiées telles que variant_type(payload) et variant_keys(payload). Interroger des données semi-structurées à la vitesse d’un moteur vectorisé supprime les pertes de performance habituelles entre stockage documentaire et analyse relationnelle.
Protocole Quack et déclencheurs : le moteur local prend en charge les besoins serveur
Jusqu’alors, intégrer DuckDB dans un environnement de production se heurtait à l’absence d’une architecture client-serveur standardisée. Introduits en mai avec la version 1.5.3, le protocole Quack et l’extension quack se stabilisent dans cette version 2.0. Côté serveur, un simple CALL quack_serve(token = 'my_token') suffit ; côté client, la clause ATTACH combinée à la nouvelle commande CONNECT permet de lier et de basculer de base distante en une seule ligne.
Pour des raisons de sécurité, le serveur Quack n’écoute par défaut que sur localhost. Les guides officiels recommandent de placer un proxy inverse assurant la terminaison TLS en amont pour les accès inter-machines, réservant le paramètre allow_other_hostname aux environnements de test. De plus, CONNECT peut cibler des instances PostgreSQL ou MySQL, tandis que le nouvel optimiseur de délégation distante (Remote Pushdown) décharge l’exécution directement sur le serveur distant. Le moteur local devient ainsi un routeur de requêtes fédérées, évitant le désastre réseau que représenterait le transfert intégral de tables massives en mémoire locale.
Côté SQL, la version 2.0 intègre la commande CREATE TRIGGER. Elle prend en charge les déclencheurs BEFORE et AFTER, au niveau ligne ou instruction, ainsi que les tables de transition via REFERENCING OLD/NEW TABLE. Bien que des combinaisons comme BEFORE ... FOR EACH ROW et UPDATE ... FOR EACH ROW demeurent en cours de développement, les fonctionnalités actuelles répondent déjà aux exigences de journalisation d’audit et de maintenance incrémentielle des vues matérialisées. Par exemple, attacher des déclencheurs d’insertion et de suppression sur une table des employés permet de maintenir en temps réel l’âge moyen par nationalité sans recalcul complet de la table. L’arrivée des déclencheurs permet à DuckDB d’assurer lui-même la gestion d’états légers, sans dépendre de scripts ou d’ordonnanceurs externes.
Parseur PEG et dépôts d’extensions dédiés : préparer l’évolution à long terme
Lorsqu’un moteur prend en charge des rôles d’infrastructure critique, l’extensibilité grammaticale et la sécurité de la chaîne d’approvisionnement doivent être irréprochables. Depuis son premier commit en 2018, DuckDB s’appuyait sur un parseur LALR(1) généré par YACC/Bison hérité de PostgreSQL. Avec l’expansion du dialecte, la moindre modification syntaxique risquait d’entrer en conflit avec les règles existantes, générant des conflits shift/reduce.
La version 2.0 adopte par défaut un parseur PEG (Parsing Expression Grammar), tout en conservant l’extension legacy_parser en repli. Le parseur PEG évalue les règles dans un ordre de priorité strict : les nouveaux ajouts syntaxiques n’interfèrent plus avec les branches existantes et les erreurs de syntaxe pointent avec exactitude le code source incriminé. Les extensions tierces peuvent désormais greffer leur propre grammaire directement dans l’arbre syntaxique, tandis que la nouvelle API C v2 ouvre de manière modulaire les systèmes de fichiers et les fonctions de table. L’adoption du parseur PEG élimine les obstacles pour les équipes souhaitant personnaliser le dialecte SQL sans modifier le code source du moteur.
Pour répondre aux exigences de conformité en entreprise, la version 2.0 permet également d’héberger ses propres dépôts d’extensions certifiés. Les administrateurs peuvent associer un préfixe d’URL et une clé publique RSA via CREATE EXTENSION REPOSITORY ; DuckDB verrouille la clé lors de la création et affiche son empreinte SHA-256 pour validation. En parallèle, DuckLake 1.1 et les extensions Iceberg et Delta reçoivent des mises à jour majeures : Iceberg supporte le montage de catalogues REST et Delta enrichit la création de tables et les requêtes avec voyage temporel (Time Travel). Si cette expansion vers des rôles serveur, des déclencheurs et des fonctions d’entreprise suscite quelques inquiétudes quant au risque d’alourdir un cœur analytique très léger, la majorité des retours salue la centralisation de ces besoins fréquents dans des protocoles standard et des extensions officielles, bien plus fiables à maintenir que des scripts dispersés.
Concernant le cycle de vie, la gouvernance de DuckDB affiche des engagements précis : DuckDB 2.0.0 LTS sera maintenue jusqu’en octobre 2027 au minimum. Avec la branche 1.5 supportée jusqu’en mars 2027 et la 1.4 jusqu’à fin novembre 2026, le projet maintient trois lignes de production en parallèle. Même si certaines bibliothèques clientes pour Go, R ou Java requièrent encore quelques jours d’ajustement, cet horizon de support pérenne consacre son nouveau statut : une base de données intégrée combinant une interface optimisée pour les agents, des I/O cloud asynchrones, le traitement colonnaire semi-structuré et une stabilité LTS pluriannuelle, prête à devenir un socle essentiel des architectures de données modernes.
Liens de référence :
- Annonce officielle de DuckDB 2.0.0 LTS
- Discussion au sein de la communauté Hacker News