Le 21 octobre 2026, OpenAI et des équipes de recherche partenaires ont dévoilé les résultats d’une expérience marquante : une flotte de 1 946 agents IA spécialisés a fonctionné de manière coordonnée pour mener à bien l’analyse de l’atlas génétique du cerveau entier d’une souris en seulement 32 minutes. Cet atlas répertorie les réponses à des modifications génétiques à l’échelle de millions de cellules cérébrales — un volume de données à haute dimension qui mobilise habituellement des équipes humaines pendant plusieurs années.
Il ne s’agit pas d’une simple démonstration de puissance brute de calcul ; la véritable rupture réside dans la granularité de la décomposition méthodologique. Confrontés à des ensembles de données biologiques massifs, les modèles de fondation monolithiques saturent fréquemment leur fenêtre de contexte et tendent à produire des généralités convenues. Les chercheurs ont donc renoncé à confier l’intégralité du processus à un unique modèle géant, préférant découper le protocole scientifique en milliers de micro-tâches vérifiables en parallèle.
Des années de travail en 32 minutes : que calculaient ces deux mille modèles ?
Le cerveau murin est constitué d’un réseau cellulaire d’une grande complexité. Grâce à la technologie CRISPR, les chercheurs ont ciblé et perturbé systématiquement plusieurs gènes clés. Lorsqu’un gène est inhibé, les niveaux d’expression de milliers d’autres gènes oscillent en cascade. L’atlas complet enregistre ces réponses chez des millions de cellules distinctes, générant un corpus de données colossal.
Pour analyser de tels volumes, les biologistes doivent confronter d’innombrables matrices d’expression et passer des mois à éplucher la littérature afin de dégager des hypothèses mécanistiques. Les 1 946 agents propulsés par GPT-Rosalind n’ont pas cherché à ingérer toutes ces données d’un seul bloc. Le système a fractionné l’analyse des perturbations et la recherche documentaire en étapes modulaires, chaque agent se consacrant à l’examen approfondi d’un mécanisme microscopique précis.
Au terme des 32 minutes de fonctionnement, l’essaim d’agents a généré 3 397 déductions biologiques distinctes. Des algorithmes en aval ont ensuite assemblé ces briques en un graphe unifié de raisonnement. Aucune intervention humaine n’a été nécessaire pour ajuster les hyperparamètres ; les hypothèses ont été déduites directement des matrices brutes d’expression génique. L’ensemble de ces déductions a été publié en open source sur GitHub, constituant une archive de référence pour l’étude des maladies neurodégénératives.
11 articles cités par le modèle monolithique contre 7 600 après décomposition
La robustesse d’une déduction scientifique dépend de la rigueur de sa chaîne de preuves. Face à ce même problème à grande échelle, un modèle monolithique analysant l’ensemble des données n’a mentionné que 11 références bibliographiques. Cette lacune met en lumière la faiblesse structurelle des architectures monolithiques : dès que la charge dépasse leur capacité d’attention, leur vision documentaire et leur acuité s’effondrent rapidement.
L’architecture distribuée a fondamentalement transformé la circulation de l’information. Près de deux mille agents se sont partagé les rôles : extraction documentaire, formulation d’hypothèses et contre-interrogatoire croisé. Chaque groupe d’agents a ciblé les anomalies d’expression propres à des sous-populations cellulaires bien délimitées. D’après le préprint paru sur bioRxiv, le système distribué a consulté et contre-vérifié environ 7 600 articles scientifiques pour la même tâche, soit une couverture bibliographique 711 fois supérieure à celle du modèle isolé.
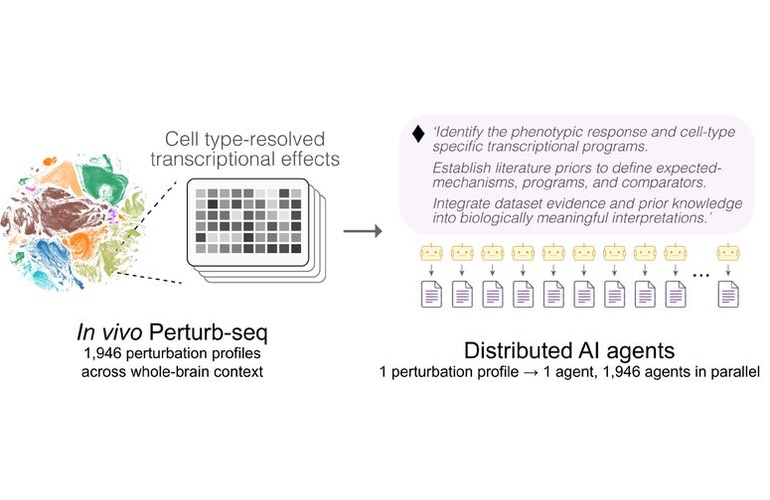 Figure : Architecture d’ordonnancement hiérarchique des agents distribués, où chaque nœud prend en charge de façon autonome l’appariement documentaire et la validation croisée d’une perturbation génétique. Source : R&D World (adapté de Sun et al., bioRxiv)
Ingérer des données massives sans tri préalable expose les modèles de langage à de fausses corrélations. En découpant la charge de travail et en chargeant des milliers d’agents d’examiner minutieusement des extraits ciblés, le système a tissé une trame de preuves d’une grande rigueur. La profondeur de la décomposition des tâches conditionne directement l’amplitude documentaire et la fiabilité des déductions scientifiques.
30 docteurs en biologie en double aveugle : 48 découvertes reproduites sur-le-champ
Formuler des hypothèses avec l’IA est accessible ; franchir le cap de l’évaluation par les pairs constitue le véritable défi. Pour évaluer la qualité des synthèses, l’équipe a fait appel à 30 docteurs en biologie dans le cadre d’un examen en double aveugle. Les experts ont noté la pertinence des déductions sans connaître l’origine des rapports.
Les agents n’avaient jamais eu accès aux manuscrits originaux des études antérieures. Pourtant, lors de ce test en aveugle, ils ont reproduit de manière autonome 48 des 55 découvertes majeures de la littérature, soit un taux de concordance de 87 %. En comparaison directe de qualité, les experts humains ont préféré les rapports de l’essaim distribué dans 75 % des scénarios d’évaluation.
 Figure : À gauche, la matrice de perturbation de l’expression génique sur des millions de cellules cérébrales ; à droite, la topologie de raisonnement déployée en parallèle par près de 2 000 agents. Source : madrobot.blog
Les analyses produites par un modèle unique se cantonnent souvent à des généralités de manuel sans détailler les interactions moléculaires concrètes. Au sein de l’essaim distribué, les nœuds relèvent mutuellement les failles logiques de leurs pairs, éliminant très tôt les spéculations infondées. Ce dispositif d’interrogatoire croisé entre nœuds réduit considérablement l’incidence des hallucinations.
Identification de voies génétiques méconnues : l’IA apporte des pistes à la paillasse
La confirmation de résultats déjà établis n’est qu’une première étape. La véritable plus-value du système réside dans l’exploration des angles morts qui échappent aux chercheurs humains. En analysant le gène DCTN1, les agents ont mis en évidence un signal atypique : l’inhibition de ce gène entraîne une élévation marquée de l’expression des gènes liés à la synthèse du cholestérol.
Le gène DCTN1 code une sous-unité de la dynactine et joue un rôle clé dans des pathologies neurodégénératives comme la sclérose latérale amyotrophique (SLA). Les recherches antérieures se focalisaient presque exclusivement sur le ralentissement du transport axonal, et très peu de travaux le reliaient au métabolisme lipidique. En croisant des dizaines de publications spécialisées, l’essaim a échafaudé une hypothèse mécanistique globale et cohérente.
Le rapport indique que l’entrave au transport axonal empêche le retour régulier du cholestérol vers le corps cellulaire. Percevant ce déficit local, le noyau active la voie SREBP pour engager une synthèse compensatoire qui aggrave la dégradation neuronale. Un découpage méthodique des tâches permet ainsi de dépasser les cloisonnements disciplinaires : cette déduction offre une cible thérapeutique inédite pour le développement de futurs traitements.
Le calcul lève le goulot d’étranglement des hypothèses, la paillasse reste le juge ultime
Aboutir à des milliers de déductions étayées en 32 minutes constitue une prouesse technique indéniable. Néanmoins, en sciences de la vie, le verdict final appartient toujours aux molécules du monde réel. Une vaste couverture bibliographique témoigne d’une grande envergure de recherche, non d’une vérité absolue. Les déductions qui n’ont pas été soumises aux boîtes de Petri et aux pipettes ne demeurent, en définitive, qu’une liste d’hypothèses prometteuses à vérifier.
Les scientifiques engagés dans le projet soulignent que les mécanismes proposés par les agents doivent impérativement être validés par des expériences in vitro et in vivo. L’IA ne saurait se substituer au savoir-faire manuel des biologistes expérimentaux ; elle transforme en profondeur la manière dont émergent les hypothèses scientifiques. Alors qu’un chercheur consacrait auparavant des mois à isoler une piste, les algorithmes livrent désormais des hypothèses solidement étayées directement sur la paillasse du laboratoire.
C’est en décomposant les étapes de recherche avec une finesse suffisante que la puissance de calcul devient un véritable accélérateur de la découverte scientifique. L’avenir de l’IA en biologie se dessine avec netteté : point n’est besoin d’attendre un modèle omniscient unique. Grâce à une répartition méthodique du travail et à des mécanismes d’arbitrage croisé, des centaines de micro-agents peuvent former un collectif scientifique d’une redoutable efficacité.
Liens de référence :
- Rapport de recherche officiel d’OpenAI : Élargissement de la recherche en IA pour les données biologiques complexes
- Préprint bioRxiv : Des agents IA distribués permettent la synthèse à grande échelle de connaissances biologiques
- Article de R&D World : OpenAI déploie près de 2 000 agents GPT-Rosalind pour générer des pistes biologiques en 32 minutes
- Projet open source sur GitHub : Graphe de raisonnement biologique par agents distribués