TPC-Hベンチマークにおいて、DuckDB 2.0.0のコマンドラインインターフェース(CLI)はLLMが読み込む出力データ量を59%削減した。コードネーム「Cinnamon Teal」(アカシマアジ、学名 Spatula cyanoptera)と名付けられたこの長期サポート(LTS)版は、1.5以降に約20,000件のコミットを取り込んでいる。単一プロセスの組み込みデータベースが、自律エージェントの呼び出し、クラウドオブジェクトストレージ、そして長期運用を前提とした設計へと踏み出した。ローカル分析ツールから、本番環境のデータインフラへの転換である。
 図:DuckDB 2.0.0 LTSのコードネームとサポートサイクル。本バージョンは2027年10月までサポートされる。出典:DuckDB公式ブログ
これまでDuckDBは、データサイエンティストがJupyter Notebookで手軽に使う分析エンジンとして重宝されてきた。しかしバージョン2.0に至り、その想定ユーザー、扱うデータ形式、そして配置場所は一変した。SQLを発行するのは人間のアナリストからAIコーディングエージェントへと移り、上流データはスキーマレスな半構造化JSONとなり、データ本体は遠隔のオブジェクトストレージに置かれるようになった。これらの新たなワークロードに合わせてコアエンジンを再構築したことが、今回のメジャーリリースの主眼である。
CLIがエージェントを自動判別、出力トークンを59%圧縮
今日、ターミナルで duckdb を実行しているのは、Claude CodeやCodex、Cursorといったコーディングエージェントであることが増えている。人間にとっては罫線で整えられたASCIIテーブルが見やすいが、トークン課金のLLMにとっては空白や罫線文字は高価なノイズにすぎない。データベースインターフェースの主要なコンシューマーは、人間の視覚からモデルのコンテキストウィンドウへと移行している。
DuckDB 2.0のCLIは、起動時に自身がエージェントから呼び出されているかを自動検知し、シームレスに agent mode へ切り替える。このモードでは結果がコンパクトなMarkdown表形式で出力され、長大な結果セットには明確な打ち切り境界が示され、エラーはJSON構造体として返される。デバッグ時には -agent オプションで明示的に有効化でき、-no-agent を指定すれば従来の人間向けUIに戻すことも可能だ。
単に出力量を削るだけでなく、エージェントモードは安全機構としても働く。実行コストの高いクエリは開始前に推定計算コストを返し、エージェント側で続行するか判断できるようにした。万が一クエリが暴走した場合も、CLIが能動的にサーキットブレーカーを作動させて強制中断する。データベース側がコストを自己申告しスロークエリを遮断することで、エージェントの試行錯誤によるターミナルパイプラインの停止という現場の難題を解消している。
非同期I/Oでリモート読み出しを分離、VARIANTで半構造化データを列指向処理
エージェントやパイプラインによる自動処理が進むにつれ、データソースはローカルストレージの枠を超えている。2.0ではParquet、CSV、DuckDBネイティブストレージに対して非同期I/O(Asynchronous I/O)が導入された。I/O層とクエリ実行エンジンが正式に分離され、バックグラウンドスレッドが複数の読み出しリクエストを並行して発行できるため、フォアグラウンドのベクトル化実行演算子をブロックしなくなった。
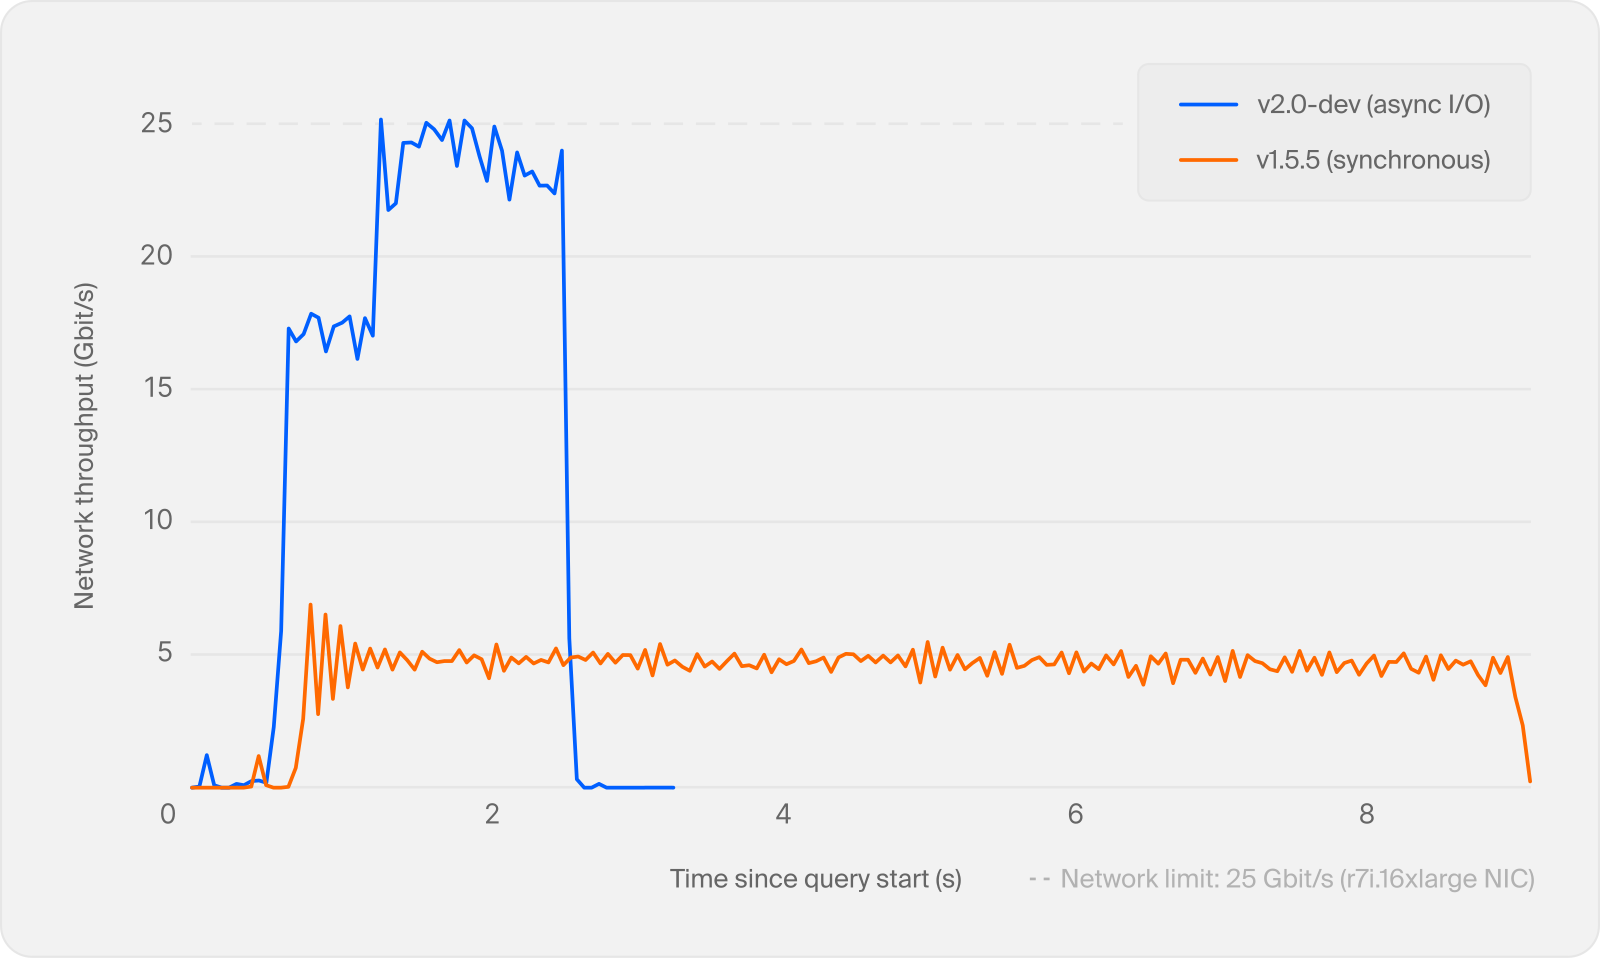 図:非同期I/Oの有効化により、クエリ実行中のネットワーク帯域利用率が大幅に向上し、同期待機によるスループット低下が解消された。出典:DuckDB公式ブログ
ローカルSSDであれば同期I/Oのレイテンシは許容範囲に収まる。しかし s3:// のような高レイテンシなオブジェクトストレージでは、直列リクエストによってネットワーク帯域が遊休化してしまう。非同期I/Oはスループットを限界まで引き出し、クラウドアナリティクス全体の実行時間を大幅に短縮する。オブジェクトストレージをファーストクラスの市民として最適化することで、リモートデータをわざわざ手元のディスクにダウンロードしてから集計する手間が不要になった。
データ形状の変化も著しい。本番のログやAPIレスポンスは1行ごとに構造が異なるJSONであることが多い。1.5で試験導入された VARIANT 型は、2.0で列指向パイプラインに完全統合された。共通構造を自動識別して列指向データに分解(Shredding)し、Parquetとの相互変換や variant_type(payload)、variant_keys(payload) などの専用関数が提供される。スキーマレスな半構造化データを列指向エンジンの速度でそのまま集計できるため、ドキュメントストアとリレーショナル分析の境界が取り払われた。
Quackプロトコルの確立とトリガー対応、サーバー領域を担う単一プロセスエンジン
これまでDuckDBを本番システムに組み込む際、標準的なサーバー機能の欠如が課題となることが多かった。2026年5月の1.5.3で試験導入されたQuackプロトコルと quack 拡張機能は、2.0で正式なクライアント・サーバーアーキテクチャとして完成した。サーバー側は CALL quack_serve(token = 'my_token') を叩くだけで起動し、クライアント側は ATTACH に新設された CONNECT 構文を組み合わせることで、リモートデータベースの接続と切り替えを1行で完結できる。
セキュリティ面への配慮から、Quackサーバーはデフォルトで localhost にのみバインドする。公式は複数マシン間の接続にはTLS終端を担う認証プロキシのリバースプロキシ配置を推奨しており、allow_other_hostname は検証環境に限定するよう案内している。さらに CONNECT 構文はPostgreSQLやMySQLにも直接接続可能で、新設されたリモートプッシュダウン(Remote Pushdown)オプティマイザがクエリをリモート側にオフロードして処理する。単一マシンエンジンがフェデレーテッドクエリのルーター役を果たし、巨大なリモートテーブルをローカルメモリに全転送する帯域崩壊を防ぐ。
SQL機能としては、新たに CREATE TRIGGER 構文が追加された。BEFORE と AFTER、行レベルとステートメントレベルのトリガーに対応し、REFERENCING OLD/NEW TABLE を通じた遷移テーブルの参照も可能だ。現時点では BEFORE ... FOR EACH ROW や UPDATE ... FOR EACH ROW などの一部の組み合わせは今後の実装予定だが、監査ログの記録やマテリアライズドビューの増分更新には十分実用的である。たとえば社員テーブルに挿入・削除トリガーを設定しておけば、全件再集計を行わずに国籍別の平均年齢をリアルタイム更新できる。トリガー機能の獲得により、外部のスケジューラに頼らずとも軽量な状態管理をDuckDB内部で完結できるようになった。
PEGパーサー採用と独自拡張リポジトリ、長期的な拡張への布石
データベースがインフラ基盤としての責任を負う以上、文法拡張やサプライチェーンの堅牢性は不可欠だ。2018年の最初期コミット以来、DuckDBはPostgreSQL由来のYACC/Bison生成によるLALR(1)パーサーを採用してきた。しかし独自方言の拡大に伴い、わずかな文法追加でも既存ルールと衝突し、shift/reduce コンフリクトを引き起こしやすくなっていた。
2.0では新たな構文解析表現文法(PEG、Parsing Expression Grammar)パーサーがデフォルトになり、互換性確保のために legacy_parser 拡張も残された。PEGパーサーは定義順にルールを評価するため、新構文が既存ロジックに予期せぬ副作用を及ぼさず、構文エラー時もソースコードの正確な位置を指摘できる。サードパーティ製拡張機能が構文木に直接独自ルールを登録できるようになり、同時に公開されたC API v2と相まって、ファイルシステムやテーブル関数などコア機能のモジュール化が進んだ。PEGへの刷新により、コアソースコードをフォークすることなく独自のSQL方言を組み込む障壁が取り払われた。
エンタープライズのセキュリティ要件に応え、2.0では組織独自の信頼できる拡張機能リポジトリの構築もサポートされた。管理者は CREATE EXTENSION REPOSITORY でURLプレフィックスとRSA公開鍵を登録でき、DuckDBは登録時に鍵をピン留めしてSHA-256フィンガープリントを表示・検証する。同時にDuckLake 1.1、Iceberg、Delta拡張もアップデートされ、IcebergはRESTカタログのマウントに対応し、Delta拡張はテーブル作成とタイムトラベルクエリをサポートした。こうしたサーバー化やエンタープライズ機能の拡充に対しては、軽量な分析コアに余計な肥大化をもたらすのではないかという懸念もあるが、チームごとに接着剤のようなコードを量産するより公式拡張と標準プロトコルに集約するほうが保守性が高いという評価が勝りつつある。
サポートサイクルに関して、DuckDB公式は明確な方針を打ち出している。2.0.0 LTSは少なくとも2027年10月まで長期保守され、1.5系統も2027年3月まで、1.4系統も2026年11月末まで並行してサポートされる。GoやR、Javaなどの一部クライアントライブラリの追従には数日要する見込みだが、年単位の安定運用保証はDuckDBの新たな位置づけを裏付けている。AIエージェントとの協調、クラウド非同期I/O、半構造化データの列指向処理、そして長期LTSサポートを兼ね備えたこのエンジンは、次世代データスタックの中核インフラを見据えている。
参考リンク:
- DuckDB 2.0.0 LTS 公式発表
- Hacker News コミュニティの議論