Öffnet man eine 208 MB große Webanwendung im Browser und tippt vim test.txt ein, springt der Bildschirm sofort in die gewohnte Editoroberfläche. Auch Splitscreens mit tmux oder eine Runde Snake meistert der Cursor ohne spürbare Verzögerung. Doch tippt man absichtlich den Tippfehler pythoon in die Befehlszeile, passiert etwas Verblüffendes: Weder erscheint die Meldung „command not found“, noch stürzt das System ab. Stattdessen öffnet sich ganz selbstverständlich ein interaktiver Python-Prompt. Hinter diesem Terminal namens WorldTUI läuft kein Bash-Prozess und es ist kein Dateisystem eingehängt; sämtliche Bildschirminhalte werden in Echtzeit von einem Sprachmodell mit nur 360 Millionen Parametern vorhergesagt.
Mit nur 360 Millionen Parametern und ohne eine einzige Zeile nativen Systemcodes hält WorldTUI eine in sich konsistente Terminalwelt aufrecht und behält über 70 Prozent der Dateiinhalte über Sitzungen hinweg im Gedächtnis. Da das Modell jedoch lediglich Zeichenänderungen auf dem Bildschirm vorhersagt und die zugrundeliegenden Regeln nicht versteht, bricht die Illusion zusammen, sobald bekannte Befehle neu kombiniert werden.
360M Parameter im Browser, ganz ohne echten Code
Das Fundament von WorldTUI bildet das quelloffene Qwen2.5-Coder-0.5B von Alibaba, das gestutzt und feingetunt auf 360M Parameter direkt via WebGPU im Desktop-Browser Chrome oder Edge lokal ausgeführt wird. Die Einschätzung des Entwicklers fällt entwaffnend ehrlich aus: „Ist das nützlich? Eigentlich nicht.“ Die eigentliche Kernhypothese stammt aus DeepMinds Genie 3: Wenn künftige Software nicht mehr zeilenweise von Entwicklern programmiert, sondern von neuronalen Netzen Bild für Bild anhand von Nutzereingaben vorhergesagt wird – kann ein so kompaktes Modell überhaupt eine zustandsbehaftete, konsistente Welt aufrechterhalten?
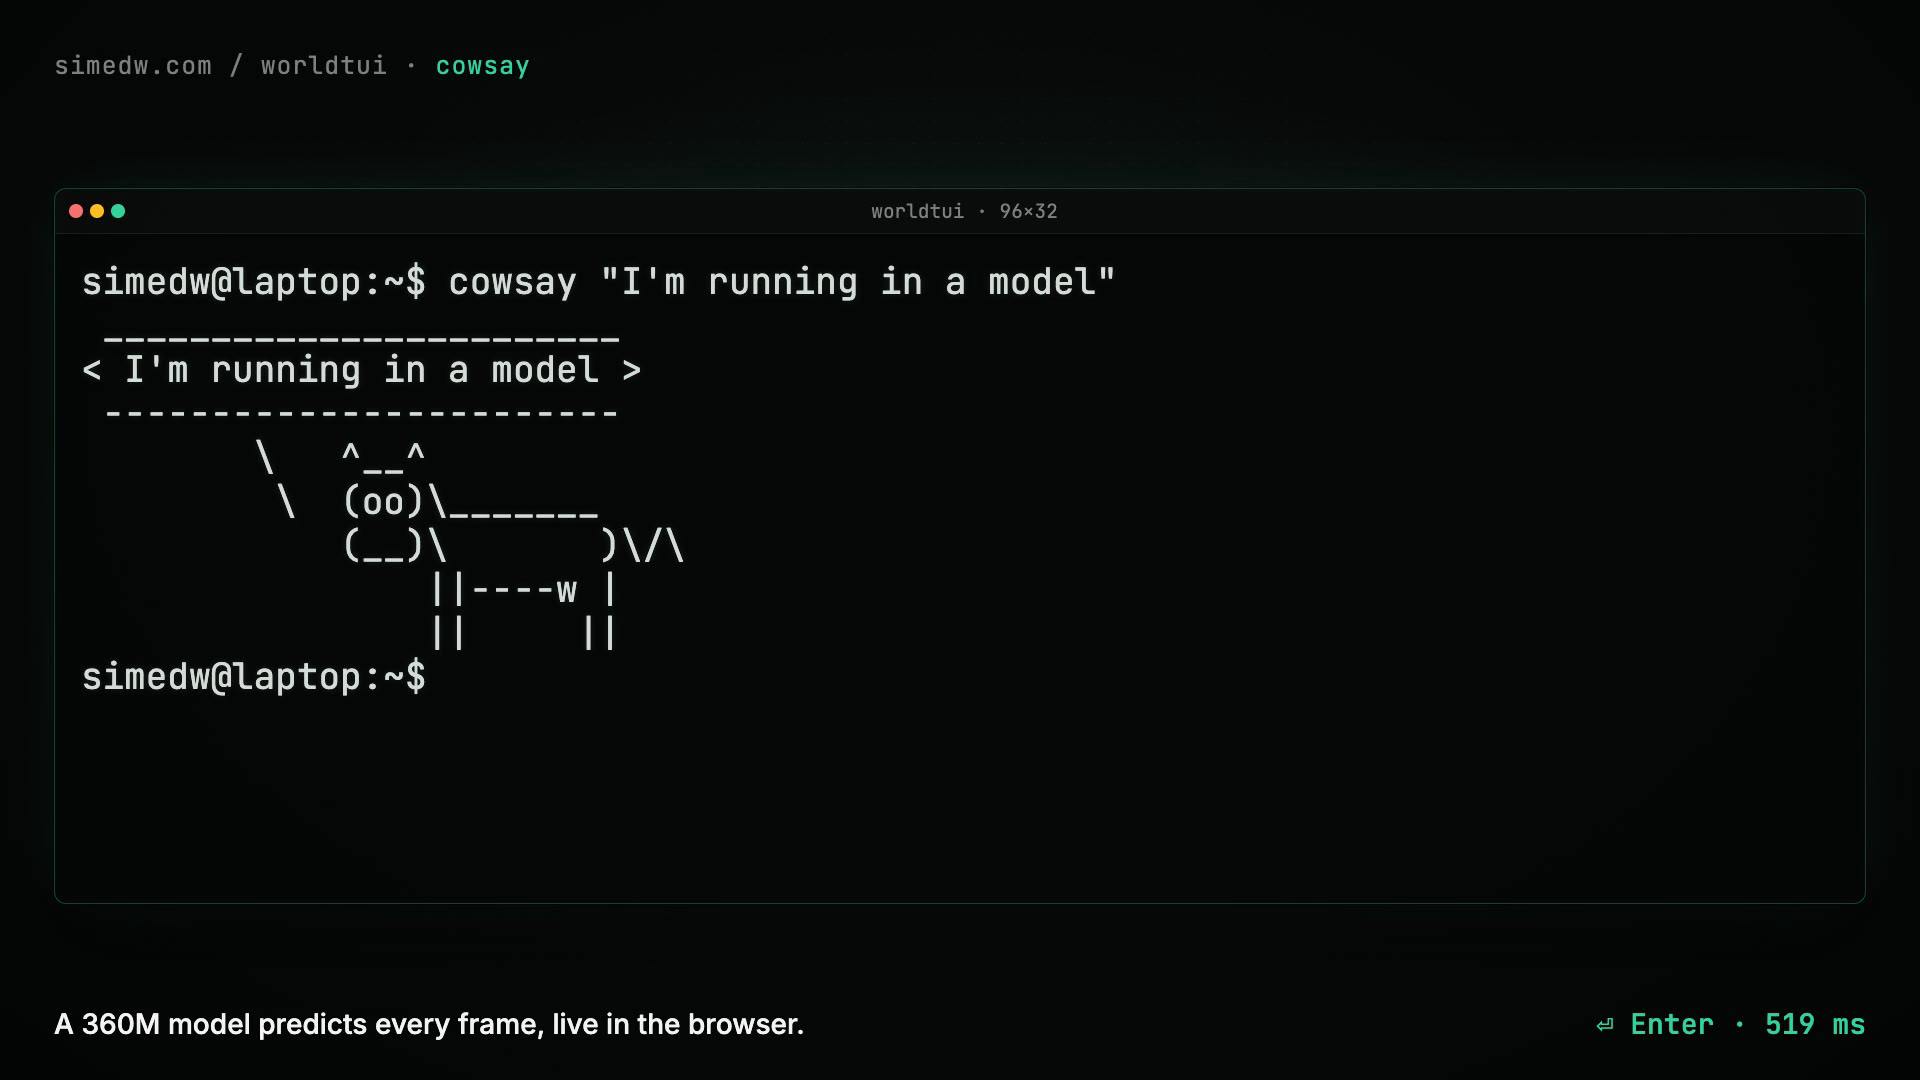 Abbildung: Die von WorldTUI im Browser vorhergesagte cowsay-Ausgabe und Verzeichnisstruktur. Am oberen Rand lassen sich Zeilen- und Spaltenmaße frei anpassen. Quelle: SimEdw’s Blog (Original-Screenshot)
Bereits 2022 brachten Entwickler ChatGPT per Prompting dazu, ein Linux-Terminal nachzuahmen. Später simulierte GameNGen das Spiel Doom Bild für Bild über Diffusionsmodelle, während NeuralOS versuchte, grafische Benutzeroberflächen (GUIs) zu erzeugen. Doch videobasierte Weltmodelle auf Pixelebene erfordern gewaltige GPU-Cluster und riesige Trainingsdatensätze – für Einzelentwickler unbezahlbar. Die Verlagerung des Testfelds von Pixeloberflächen auf terminale Zeichenraster umgeht diese Rechenhürde elegant: Echte Unix-Shells erzeugen beliebig viele, fehlerfrei annotierte Trainingsdaten zum Nulltarif, und vortrainierte Codemodelle bringen bereits ein robustes Grundverständnis dafür mit, was ls oder cat ausgeben müssen. Indem das Weltmodell von Pixeln auf Zeichenraster reduziert wurde, reicht eine handelsübliche Consumer-Grafikkarte völlig aus, um die Kernfrage der Zustandskonsistenz zu erforschen.
333 Tokens und ein Zeilenkopierbefehl: 97 Prozent Rechenaufwand beim Scrollen eingespart
Standard-LLMs hängen neue Tokens sequenziell an das Textende an. Dieses Paradigma scheitert im Terminal sofort. Ein Druck auf Esc in vim erzeugt keinen Text; der Befehl clear löscht den Bildschirm und setzt den Cursor in die linke obere Ecke. Die Ausgabe findet keineswegs nur in der letzten Zeile statt. Der Autor verwarf daher die rein serielle Textvorhersage und trainierte das Modell stattdessen darauf, Bildschirm-Deltas vorherzusagen: Zu Beginn jeder Sitzung wird ein Snapshot aus Abmessungen (z. B. 32×96), aktuellem Zeicheninhalt und Cursorposition übergeben. Nachfolgende Tastaturanschläge geben nur noch an, welche Zeilen überschrieben werden müssen und wo der Cursor verbleibt. Da die Rastermaße explizit als Eingabeparameter dienen, kann das Modell jederzeit mitten im Geschehen ansetzen – sei es bei einer laufenden Partie Snake oder einem halb geöffneten vim-Puffer.
Tastatureingaben werden als Rohbytes verarbeitet: Enter entspricht \r, Escape ist 0x1b, und der Linkspfeil ESC [ D. Bleibt der Nutzer inaktiv, speist das System ein zeitbehaftetes WAIT-Token ein – genau dieses Zeitsignal sorgt dafür, dass sich die Schlange in Snake selbstständig weiterbewegt. Anstatt ein neues Vokabular für Koordinaten und Zeichen zu entwerfen, griff der Entwickler auf Qwens native Byte-Tokens zurück, die alle 256 Bytewerte abdecken; eine Zeilennummer wie 17 belegt somit nur ein einziges Token. Der eigentliche Flaschenhals lag beim Scrollen: Sobald das Terminal eine Zeile nach oben rollt, verschieben sich alle Zeichen auf dem Bildschirm. Müsste das Modell den gesamten Bildschirm neu zeichnen, würde jeder Druck auf die Enter-Taste rund 3.000 Tokens verschlingen.
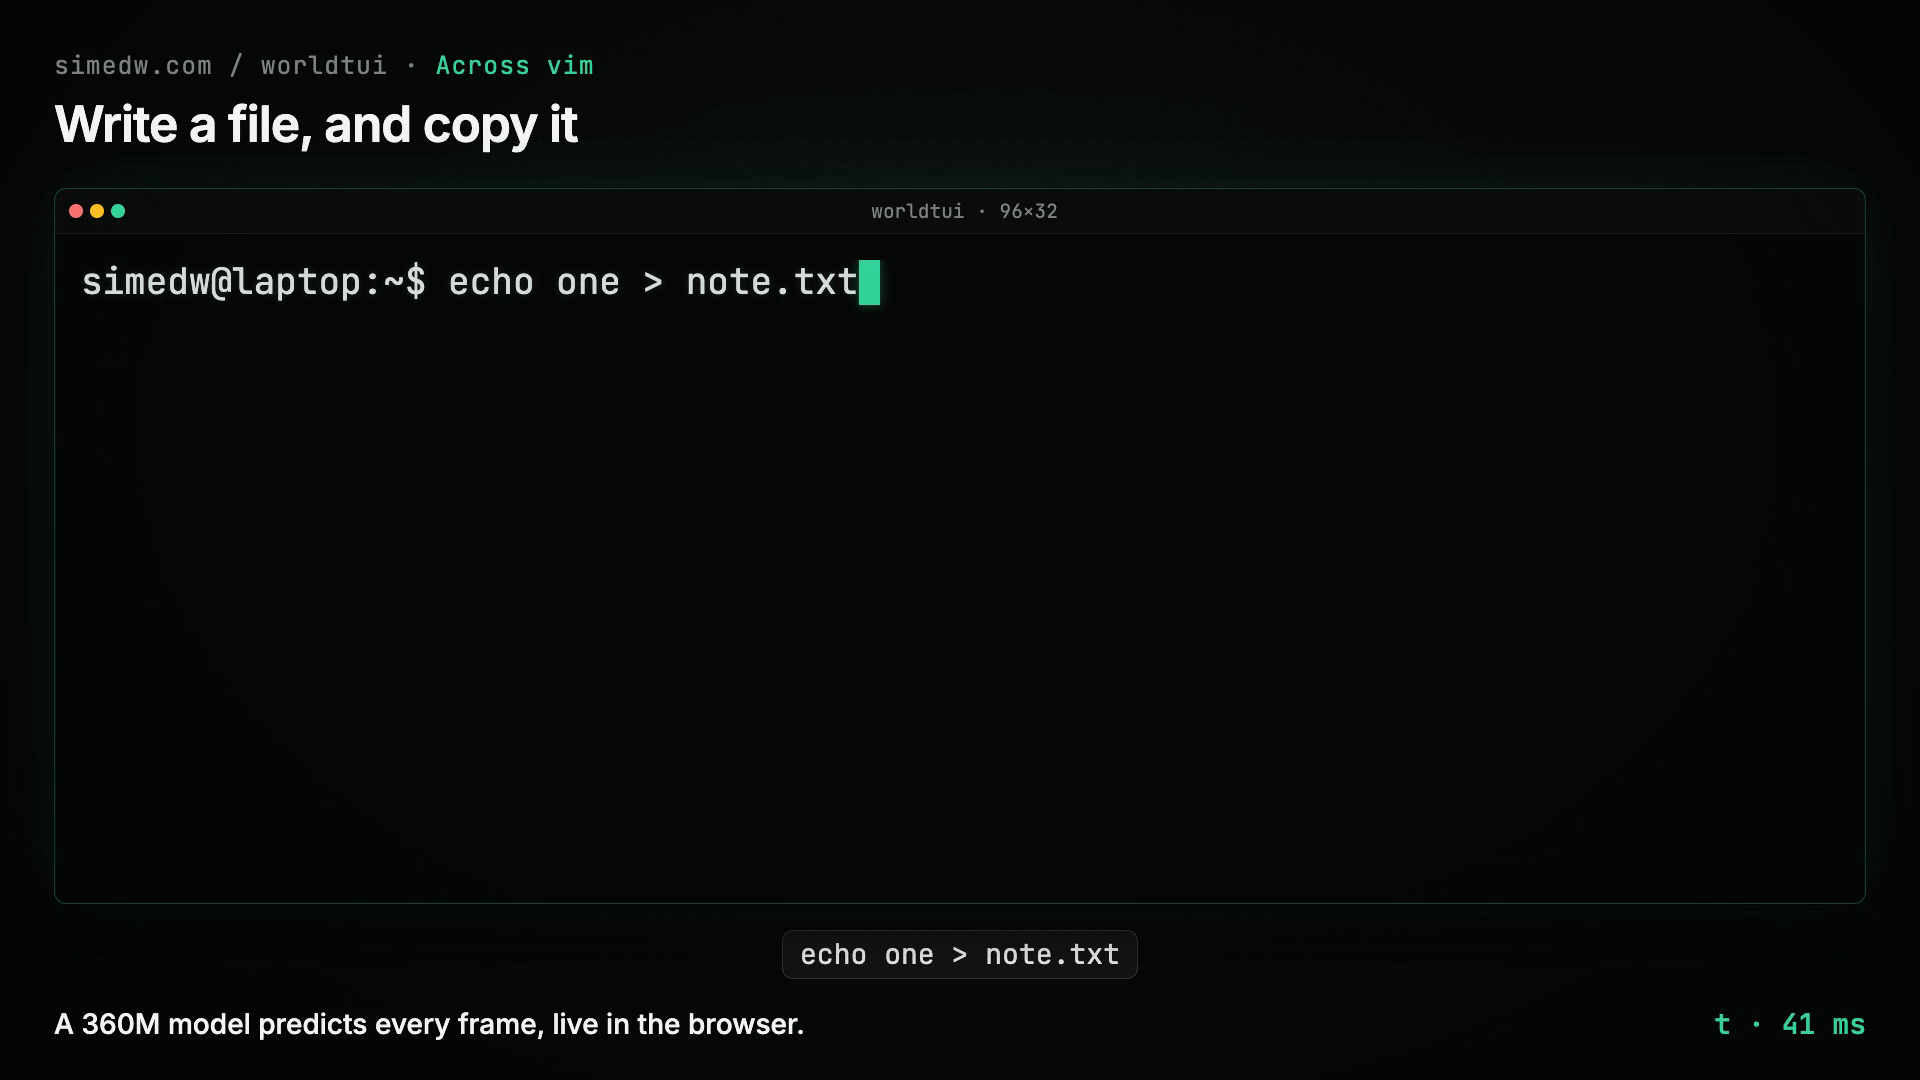 Abbildung: WorldTUI führt eine mehrzeilige Kopieroperation in vim aus; zeilenbasierte COPY-Befehle vermeiden das vollständige Neuzeichnen des Bildschirms. Quelle: SimEdw’s Blog (Videocapture)
Um diesen Rechenaufwand einzudämmen, führte der Autor Zeilenkopierbefehle wie ROW_0 COPY 1 und ROW_1 COPY 2 ein. Beim Scrollen benötigt jede Zeile nur noch 3 Tokens für den Versatz anstelle von rund 96 Tokens für den vollständigen Neuaufbau. Das löste zugleich die partielle Aktualisierung bei Bildschirmlöschungen, Zeileneinfügungen in vim und beim Blättern in man-Pages. Am Ende schrumpfte das aktive Vokabular auf lediglich 333 Tokens (256 Byte-Tokens, 64 Zeilen-Tokens sowie wenige Sonderbefehle). In Kombination mit grammatikbeschränktem Decoding erzeugt jede Vorhersage garantiert gültige Bildschirmaktualisierungen. Ob ein Weltmodell auf Endgeräten lauffähig ist, hängt gleichermaßen von der Modellgröße wie von der Kompressionseffizienz seiner Zustands-Deltas ab.
75 Trainingsstunden gegen Halluzinationen: Das Modell korrigiert eigene Fehler
Nachdem das Vokabular definiert war, stellte sich heraus, dass gängige Terminal-Mitschnitte (inklusive asciinema) keine präzise zeitliche Synchronisation zwischen Tastaturanschlägen und Bildschirmframes boten. Der Entwickler musste die Daten in Docker-Containern synthetisieren. Generierte Rollenprofile (von Softwareentwicklern bis hin zu Systemadministratoren) erzeugten zufällige Verzeichnisbäume und Benutzernamen und führten 6 bis 24 Aktivitäten pro Sitzung aus – vom Editieren von Dateien über Python-Skripte bis hin zu tmux. Die Pipeline simulierte realistisches Tipptempo, Tab-Vervollständigung, eine Tippfehlerrate von 1,2 Prozent und ließ 35 Prozent der Sitzungen mittendrin starten. So entstanden 336.000 Episoden mit rund 2 Milliarden Tokens für Rasterformate wie 32×96, 24×80 und 40×120.
Mit überwachtem Feintuning (SFT) lernte das Modell schnell, Eingaben, Rücktasten und Cursorbewegungen darzustellen. In langen Sitzungen brach das Verhalten jedoch zusammen: Sobald das Modell an einer Stelle einen Dateinamen falsch schrieb, pflanzte sich dieser Fehler durch den gesamten Kontext fort. Inspiriert vom DAgger-Algorithmus (Dataset Aggregation) aus der Robotik entwarf der Autor eine fehlerselbstkorrigierende Trainingspipeline: An einem zufälligen Punkt einer echten Sitzung lässt man das Modell 1 bis 4 Schritte eigenständig agieren. Weicht der vorhergesagte Fehler nicht zu weit vom Original ab, wird ein Korrekturschritt konstruiert, der den Bildschirm beim nächsten Tastenanschlag wieder auf den Sollzustand zurücksetzt.
Dabei galt eine strikte Regel: Jedes im Korrekturschritt verwendete Wort musste zuvor bereits auf einem echten Bildschirm oder im Eingabeverlauf aufgetaucht sein. Hatte das Modell einen zuvor gesehenen Dateinamen falsch geschrieben, stärkte die Korrektur das Gedächtnis; hatte das Modell jedoch eine Datei frei erfunden, hätte das erzwungene Zurückbiegen auf die reale Datei die Halluzination belohnt. Etwa ein Drittel der Stichproben lieferte verwertbare Korrekturen. Über drei Iterationen und 75 GPU-Stunden auf einer einzelnen RTX 4090 steigerte das int4-quantisierte Modell seinen PresetBench-Score (47 fehleranfällige Praxisskripte) von 24/47 auf 38/47. Autoregressive Weltmodelle leiden besonders unter kumulierenden Fehlern; die direkte Schulung von Korrekturmustern auf der Inferenzverteilung ist weitaus wirksamer als das bloße Aufblähen von Demonstrationsdaten.
4-fache Sitzungsretention gegenüber Basismodellen, doch Kombinationen überfordern das Modell
Um die Konsistenz der simulierten Welt zu prüfen, wurden drei Testreihen außerhalb der Trainingsdaten aufgesetzt. Die härteste Prüfung war der sitzungsübergreifende Gedächtnistest (Memory Test): In 32 unabhängigen Welten wurden Zufallszeichenketten in zwei Dateien geschrieben, die Sitzung neu gestartet und die Inhalte wieder ausgelesen. Nur wenn beide Dateien fehlerfrei übereinstimmten, galt der Test als bestanden:
| Modellansatz | Parameter | ShellBench (106 Befehle) | Sitzungsübergreifendes Lesen (Memory Test) |
|---|---|---|---|
| WorldTUI (feingetuntes Terminal-Weltmodell) | 360M | 80 / 106 | 9 / 13 |
| Qwen2.5-Coder-0.5B (Prompt-Rollenspiel) | 500M | 52 / 106 | 2 / 13 |
| Qwen3-0.6B (Prompt-Rollenspiel) | 600M | 60 / 106 | 3 / 13 |
Beim sitzungsübergreifenden Gedächtnis erreichte WorldTUI 9/13 und übertraf damit promptbasierte Basismodelle ähnlicher Größe um das Drei- bis Vierfache. Doch dieselbe Tabelle offenbarte auch die technologische Grenze: Während isolierte Standardbefehle zuverlässig ablaufen, gerät das Modell sofort ins Straucheln, wenn vertraute Befehle neu verknüpft werden. Wird beispielsweise mit echo green >> colors Text an eine Datei angehängt und unmittelbar danach cat colors aufgerufen, fehlt die neu hinzugefügte Zeile auf dem Bildschirm häufig komplett. Befürworter betonen, dass ein 360M-Modell allein über Aufmerksamkeitsmechanismen fast 70 Prozent des Zustands über Sitzungen hinweg bewahrt und damit die Machbarkeit „neuronaler Zustandsautomaten“ demonstriert. Skeptiker halten dagegen: Dass selbst triviale Weiterleitungen nicht zuverlässig generalisiert werden können, beweist, dass probabilistische Vorhersagen niemals einen deterministischen Betriebssystemkern ersetzen können.
Neben den Generalisierungsgrenzen gefährdete die rein autoregressive Generierung fast die Interaktivität. Bei sequenzieller Token-Generierung lag die Tipplatenz bei akzeptablen 38 Millisekunden. Bei Vollbild-Aktualisierungen durch vim, man oder clear mussten jedoch bis zu 3.000 Tokens erzeugt werden – was auf einer RTX 4090 zu einer Wartezeit von 12 Sekunden führte. Der Entwickler erkannte den entscheidenden Ansatzpunkt: Die meisten Zeilen eines Bildschirms sind unabhängig voneinander und müssen keineswegs nacheinander berechnet werden. Indem jede Zeile als eigenständiges Batchelement unter geteiltem Prefix-KV-Cache und gezielten Attention-Masks verarbeitet wird, decodieren alle Zeilen parallel; nur die Cursorposition wird in einem abschließenden Schritt bestimmt. Dadurch sank die Decodierschrittzahl für Vollbilder von 3.000 auf etwa 100 (die Länge der längsten Zeile), und die p95-Latenz für große Frames fiel von 6,7 Sekunden auf 0,87 Sekunden (unter Firefox WebGPU bleibt es allerdings noch rund 20-mal langsamer als in Chrome, vermutlich bedingt durch Browsertreiber). Historische Zeichenfolgen abzurufen bedeutet nicht, die Semantik eines Dateisystems zu begreifen; ohne symbolische Regelbindung stößt rein neuronale Vorhersage bei kompositorischer Generalisierung an eine unüberwindbare Wand.
Mit 75 GPU-Stunden Rechenaufwand liefert WorldTUI einen nüchternen Realitätscheck für den Hype um „KI als Software“ und lotet die Leistungsgrenzen kompakter 360M-Modelle aus. Dank kompakter 333-Token-Codierung, DAgger-Fehlerkorrektur und zeilenparallelem Decoding bringt es ein Terminal, das Dateien editieren, Fenster teilen und Snake ausführen kann, in 208 MB Browsercache unter – ohne eine einzige Zeile Shell-Code. Doch die verschwundene Zeile nach echo green >> colors mahnt zur Vorsicht: Die Vorhersage visueller Zeichenmuster unterscheidet sich grundlegend von der Beherrschung echter Zustandsübergänge. Als nächsten Schritt plant der Autor das Training an Tausenden prozedural generierten Mikro-Apps, um zu prüfen, ob Kontextinformationen allein ausreichen, um die Bedienlogik unbekannter Software zu erschließen – erst dann vollzieht das Weltmodell den Schritt vom bloßen Abspielen von Bildschirmaufnahmen zum echten Verständnis von Softwarelogik.
Weiterführende Links:
- SimEdw Blog: WorldTUI: A Terminal World Model
- Hacker News Diskussion zu WorldTUI