Ouvrez une application web de 208 Mo dans votre navigateur et tapez vim test.txt : l’écran bascule aussitôt vers l’interface familière de l’éditeur. Scindez l’affichage avec tmux ou lancez une partie de Snake, et le curseur répond sans le moindre ralentissement. Mais en saisissant délibérément la faute de frappe pythoon dans la ligne de commande, une anomalie apparaît : au lieu d’afficher « command not found » ou de se figer, le terminal ouvre naturellement un interpréteur interactif Python. Derrière ce terminal baptisé WorldTUI, aucun processus bash ne s’exécute et aucun système de fichiers n’est monté. Chaque modification à l’écran est prédite en temps réel par un modèle de langage d’à peine 360M de paramètres.
Avec seulement 360 millions de paramètres et sans la moindre ligne de code d’exécution système, WorldTUI maintient un univers de terminal cohérent et retient près de 70 % du contenu des fichiers d’une session à l’autre. Cependant, comme le modèle se contente de prédire les variations de caractères sans assimiler les règles sous-jacentes, l’illusion s’effondre dès que l’on combine des commandes familières de façon inédite.
360M de paramètres dans le navigateur, sans une seule vraie ligne de code
WorldTUI repose sur Qwen2.5-Coder-0.5B, le modèle open source d’Alibaba, élagué et affiné à 360M de paramètres pour une exécution locale via WebGPU dans Chrome ou Edge sur ordinateur. L’auteur fait preuve d’une franchise désarmante : « Est-ce utile ? Pas vraiment. » La véritable hypothèse qu’il cherchait à explorer s’inspire directement de Genie 3 de DeepMind : si les logiciels de demain ne sont plus programmés ligne par ligne par des ingénieurs, mais prédits image par image par un réseau neuronal à partir des saisies de l’utilisateur, un modèle aussi modeste peut-il soutenir un monde cohérent et doté d’états ?
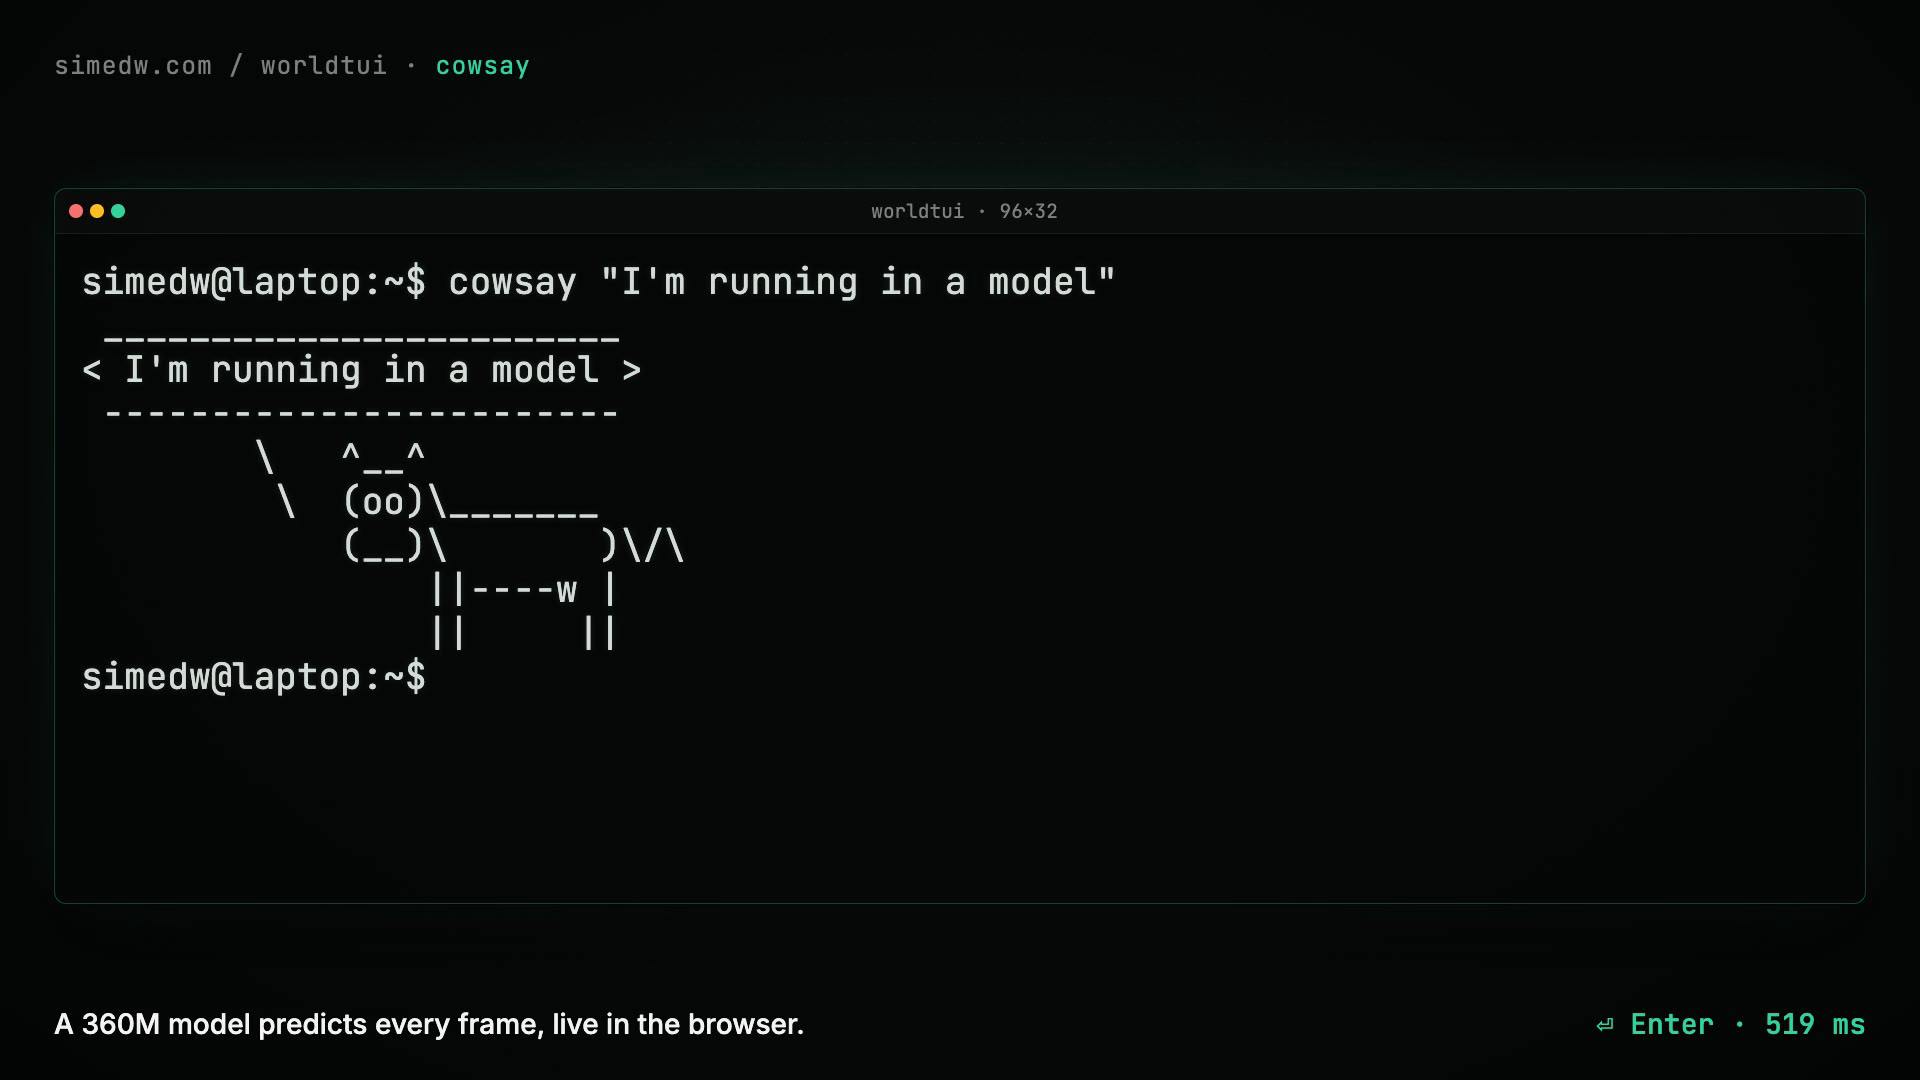 Figure : Sortie de cowsay et navigation dans les répertoires prédites par WorldTUI dans le navigateur. Notez en haut les dimensions de la grille librement configurables. Source : SimEdw’s Blog (capture d’écran officielle du projet)
Dès 2022, des développeurs concevaient des invites pour inciter ChatGPT à simuler un terminal Linux. Plus tard, GameNGen a employé des modèles de diffusion pour reproduire Doom image par image, tandis que NeuralOS s’est essayé à la génération d’interfaces graphiques (GUI). Cependant, les modèles de monde vidéo au niveau du pixel exigent des grappes massives de GPU et d’immenses jeux de données, hors de portée des développeurs indépendants. Déplacer le banc d’essai de la vidéo vers la grille de caractères textuels contourne élégamment ce goulot d’étranglement : les terminaux réels génèrent gratuitement des volumes infinis de données d’entraînement parfaitement étiquetées, et les modèles de code pré-entraînés disposent déjà d’une intuition solide sur ce que des commandes comme ls ou cat doivent renvoyer. En réduisant le modèle de monde du pixel à la grille de caractères, une simple carte graphique grand public suffit pour sonder la question cruciale de la cohérence d’état.
333 tokens et une commande de copie : le coût du défilement réduit de 97 %
Les modèles de langage classiques se contentent d’ajouter des tokens de manière séquentielle à la fin d’un texte, un principe qui heurte de plein fouet le fonctionnement d’un terminal. Dans vim, appuyer sur Échap ne génère aucun texte ; exécuter clear efface l’écran entier et replace le curseur en haut à gauche : la sortie n’est presque jamais confinée au bas de l’écran. L’auteur a donc abandonné la prédiction de flux séquentiel au profit d’une estimation des « deltas de grille » : au début de chaque session, un instantané fournissant la taille du terminal (par ex. 32×96), les caractères affichés et la position du curseur est transmis. Par la suite, chaque frappe au clavier ne prédit que les lignes à réécrire et la nouvelle position du curseur. Comme la taille de la grille fait partie intégrante des paramètres d’entrée, le modèle peut reprendre n’importe quel état en cours de route, qu’il s’agisse d’une partie de Snake engagée ou d’un tampon vim à moitié modifié.
Les touches sont transmises sous forme d’octets bruts d’un véritable terminal : Entrée vaut \r, Échap est 0x1b, et la flèche gauche ESC [ D. En l’absence de saisie utilisateur, le système injecte un token WAIT muni d’une durée, servant d’horloge interne pour faire progresser le serpent de Snake. L’auteur n’a pas conçu de vocabulaire ad hoc pour les coordonnées et les caractères, mais a réutilisé les tokens natifs de Qwen couvrant les 256 valeurs d’octets ; un numéro de ligne comme 17 ne mobilise ainsi qu’un seul token. Le véritable défi résidait dans le défilement vertical : à chaque ligne qui défile vers le haut, l’ensemble des caractères de l’écran se décale. Si le modèle devait régénérer tout l’écran à chaque saut de ligne, chaque pression sur Entrée consommerait environ 3 000 tokens.
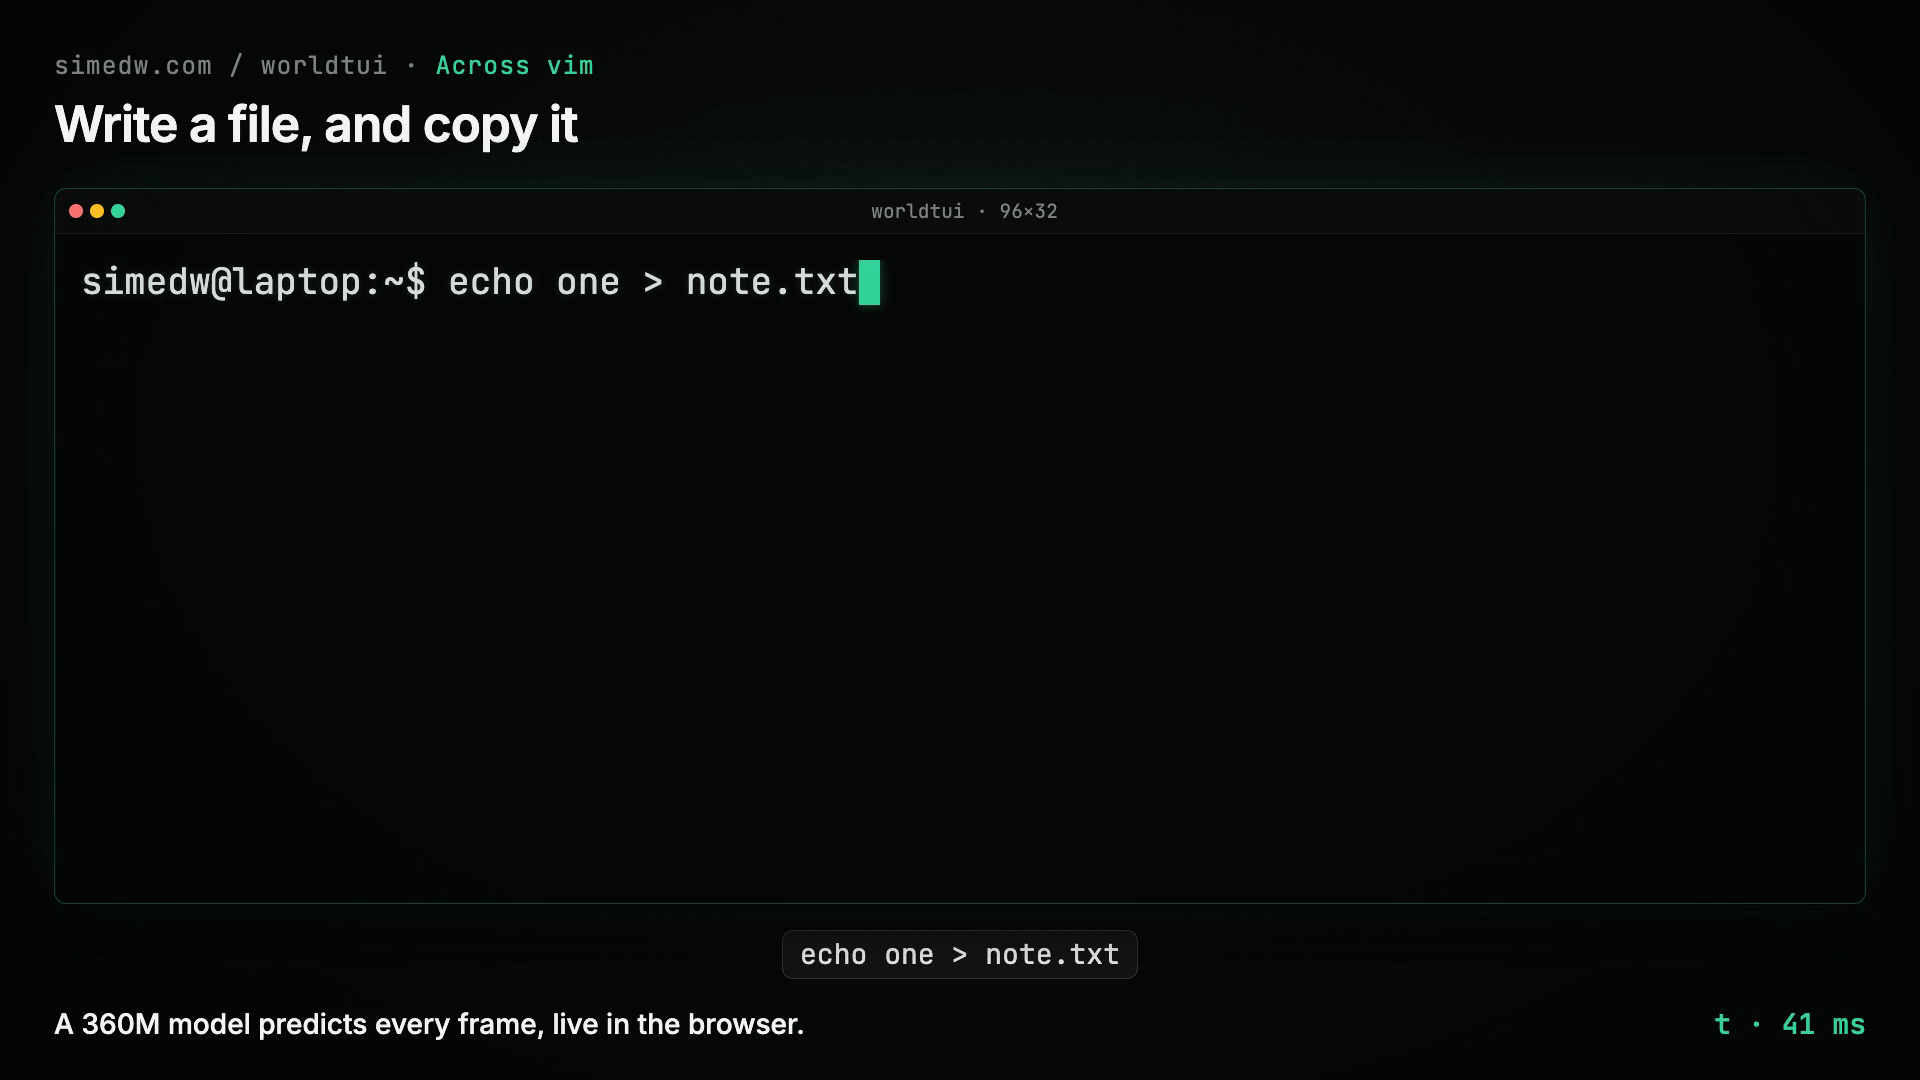 Figure : WorldTUI exécutant une copie multiligne dans vim grâce à des instructions COPY par ligne, évitant le rafraîchissement complet de l’écran. Source : SimEdw’s Blog (capture vidéo)
Pour remédier à cette dérive de calcul, l’auteur a introduit des instructions de copie par ligne comme ROW_0 COPY 1 ou ROW_1 COPY 2. Lors du défilement, le décalage de chaque ligne ne requiert plus que 3 tokens au lieu des 96 tokens nécessaires à un tracé complet. Cette approche a également résolu les mises à jour partielles lors de l’effacement de l’écran, de l’insertion ou de la suppression de lignes dans vim et de la consultation des pages de manuel man. Au final, le vocabulaire actif a été ramené à seulement 333 tokens (256 tokens d’octets, 64 tokens de lignes et quelques marqueurs spécifiques). Associé à un décodage contraint par grammaire, chaque prédiction produit nécessairement une mise à jour d’écran valide. La viabilité d’un modèle de monde sur terminal local dépend autant de la taille du réseau neuronal que de l’efficacité de compression de ses incréments d’état.
75 heures d’entraînement contre les hallucinations en corrigeant ses propres dérives
Une fois le vocabulaire figé, les enregistrements de terminal disponibles (y compris sur asciinema) se sont révélés inexploitables en raison de l’absence de synchronisation fine entre les frappes et les trames d’affichage. L’auteur a donc synthétisé ses propres données dans des conteneurs Docker. Des profils fictifs (du développeur à l’administrateur système) ont généré aléatoirement des arborescences de répertoires et des identifiants, enchaînant de 6 à 24 activités par session (édition de fichiers, scripts Python, sessions tmux). La chaîne a simulé la cadence de frappe, la complétion par tabulation, un taux d’erreur de 1,2 % et fait démarrer 35 % des sessions en cours d’exécution. Au total, 336 000 épisodes (environ 2 milliards de tokens) ont été compilés pour des grilles de 32×96, 24×80 et 40×120.
Un apprentissage supervisé classique (SFT) a vite permis au modèle de gérer la saisie, les retours arrière et les mouvements de curseur. Cependant, lors de sessions prolongées, l’ensemble déraillait : la moindre faute de frappe sur un nom de fichier se propageait et corrompait tout le contexte ultérieur. En s’inspirant de l’algorithme DAgger (Dataset Aggregation) issu de la robotique, l’auteur a bâti une chaîne d’auto-correction : à partir d’un point d’une session réelle, le modèle évolue sans guide pendant 1 à 4 étapes. Si l’affichage erroné ne diverge pas excessivement de l’état réel, une étape de « correction » artificielle est injectée pour ramener l’écran à l’état attendu lors de la frappe suivante.
Une règle absolue conditionnait cette démarche : chaque mot introduit dans l’action de correction devait impérativement être apparu dans les trames réelles antérieures ou dans l’historique de l’utilisateur. Si le modèle écorchait l’orthographe d’un fichier déjà rencontré, l’entraîner à le rectifier consolidait sa mémoire ; en revanche, s’il inventait de toutes pièces un fichier fictif, forcer sa conversion vers le fichier réel revenait à récompenser l’hallucination. Environ un tiers des sessions échantillonnées ont fourni des corrections exploitables. En trois itérations et 75 heures GPU sur une unique RTX 4090, le score du modèle quantifié en int4 sur PresetBench (une suite de 47 scripts particulièrement fragiles) est passé de 24/47 à 38/47. Le talon d’Achille des modèles de monde autorégressifs réside dans l’accumulation des erreurs ; former des mécanismes de récupération directement sur la distribution d’inférence est bien plus efficace que d’accumuler aveuglément des démonstrations.
Une persistance entre sessions quadruplée, mais un échec sur les combinaisons inédites
Pour vérifier la cohérence du monde simulé, l’auteur a mis en place trois bancs d’évaluation distincts des données d’entraînement. Le plus exigeant était le test de persistance inter-session (Memory Test) : dans 32 environnements distincts, des chaînes aléatoires étaient inscrites dans deux fichiers distincts, puis relues après réinitialisation de la session ; le test n’était validé que si les deux fichiers correspondaient scrupuleusement :
| Approche du modèle | Paramètres | ShellBench (106 commandes) | Lecture inter-session (Memory Test) |
|---|---|---|---|
| WorldTUI (modèle de monde affiné) | 360M | 80 / 106 | 9 / 13 |
| Qwen2.5-Coder-0.5B (jeu de rôle par invite) | 500M | 52 / 106 | 2 / 13 |
| Qwen3-0.6B (jeu de rôle par invite) | 600M | 60 / 106 | 3 / 13 |
Sur la mémoire inter-session, WorldTUI obtient 9/13, surclassant de 3 à 4 fois les modèles de base équivalents guidés par invites. Pourtant, la limite intrinsèque de l’architecture se lit dans ce même tableau : si le modèle maîtrise les commandes usuelles isolées, il trébuche dès que ces mêmes instructions sont agencées de manière inhabituelle. Ainsi, après avoir exécuté echo green >> colors pour ajouter une chaîne à un fichier, lancer immédiatement cat colors se solde très souvent par la disparition pure et simple de la ligne ajoutée. Ses partisans soulignent que maintenir près de 70 % d’état à travers les sessions par de simples mécanismes d’attention démontre la viabilité des « machines à états neuronales ». Les sceptiques répliquent que l’incapacité à généraliser une simple redirection démontre que la prédiction probabiliste ne saurait remplacer le déterminisme d’un noyau de système d’exploitation.
Outre les limites de généralisation, la génération autorégressive pure a failli ruiner la réactivité de l’interface. En générant token par token, la latence de frappe s’élevait à environ 38 millisecondes, un seuil acceptable. Mais lors de redessins complets provoqués par vim, man ou clear, le modèle devait produire jusqu’à 3 000 tokens d’un coup, imposant une attente de 12 secondes sur une RTX 4090. L’auteur a alors exploité une propriété fondamentale : la quasi-totalité des lignes d’une image sont indépendantes et n’ont pas besoin d’être calculées en série. En traitant chaque ligne comme un élément de lot distinct partageant le cache KV du préfixe sous un masque d’attention spécifique, toutes les lignes se décodent en parallèle, la position du curseur étant déduite dans une étape finale unique. Cette optimisation a ramené le décodage d’un écran plein de 3 000 étapes à une centaine (la longueur de la ligne la plus longue), faisant chuter la latence p95 sur les grandes trames de 6,7 secondes à 0,87 seconde (bien que sous Firefox WebGPU, l’exécution reste environ 20 fois plus lente que sous Chrome, probablement en raison des pilotes du navigateur). Retenir des caractères passés ne signifie pas comprendre la sémantique d’un système de fichiers ; sans contrainte de règles formelles, la prédiction purement neuronale bute sur le mur de la généralisation compositionnelle.
Avec un investissement modeste de 75 heures GPU, WorldTUI apporte un éclairage lucide sur l’engouement pour « l’IA en tant que logiciel » et cerne avec précision les limites d’un modèle de 360M de paramètres. Grâce à un encodage d’état compact de 333 tokens, à l’apprentissage par auto-correction DAgger et au décodage parallèle par lignes, il parvient à faire tenir un terminal virtuel capable d’éditer des fichiers, de scinder l’écran et de faire tourner Snake dans les 208 Mo de cache d’un navigateur, sans la moindre ligne de code shell. Cependant, la ligne disparue après echo green >> colors rappelle que prédire l’apparence des caractères à l’écran est une chose, et maîtriser la dynamique des transitions d’état en est une autre, qu’une simple accumulation d’exemples similaires ne suffit pas à combler. L’auteur envisage désormais d’entraîner son modèle sur des milliers de micro-applications générées procéduralement pour déterminer si des indices contextuels permettent d’assimiler la logique d’un logiciel inconnu — ce n’est qu’à cette condition que les modèles de monde passeront de la restitution d’enregistrements d’écran à la compréhension réelle de la logique logicielle.
Liens de référence :
- Blog de SimEdw : WorldTUI: A Terminal World Model
- Discussion technique sur WorldTUI sur Hacker News