웹 브라우저에서 208MB짜리 웹 애플리케이션을 열고 vim test.txt를 입력하면 화면은 즉시 익숙한 편집기 인터페이스로 전환됩니다. tmux로 화면을 분할하거나 스네이크 게임을 실행해도 커서는 부드럽게 반응합니다. 하지만 명령줄에서 일부러 오타가 난 pythoon을 입력하면 기묘한 일이 벌어집니다. 화면에 “command not found”가 뜨거나 멈추는 대신, 마치 아무 일도 없었다는 듯 파이썬 대화형 프롬프트가 매끄럽게 실행됩니다. WorldTUI라는 이름의 이 터미널 뒤에는 bash 프로세스도, 마운트된 파일 시스템도 전혀 없습니다. 화면의 모든 변화는 360M 파라미터의 언어 모델이 실시간으로 예측해 낸 결과일 뿐입니다.
360M 파라미터의 WorldTUI는 단 한 줄의 시스템 코드도 없이 자기 완결적인 터미널 환경을 유지하며, 세션을 넘나들며 파일 내용의 약 70%를 기억해 냅니다. 그러나 모델은 화면에 나타나는 글자의 변화만 예측할 뿐 내부 규칙을 이해하지 못하기 때문에, 익숙한 명령어를 새로운 방식으로 조합하는 순간 가상 세계는 여지없이 무너집니다.
브라우저에 담긴 360M 파라미터, 실행되는 실제 코드는 0줄
WorldTUI의 기반은 알리바바가 오픈소스로 공개한 Qwen2.5-Coder-0.5B입니다. 이를 가지치기하고 미세 조정하여 360M 파라미터로 줄였으며, 데스크톱 크롬이나 에지 브라우저에서 WebGPU를 통해 로컬 환경에서 직접 추론을 수행합니다. 개발자의 설명은 매우 솔직합니다. “이게 쓸모가 있을까요? 별로 없습니다.” 그가 진정으로 검증하고 싶었던 명제는 딥마인드의 Genie 3에서 출발합니다. 만약 미래의 소프트웨어가 개발자가 직접 작성한 코드로 구현되는 대신, 사용자의 입력에 따라 신경망이 다음 프레임 화면을 직접 예측하는 방식이라면 이렇게 작은 모델로도 앞뒤가 맞는 일관된 세계를 유지할 수 있을까라는 질문입니다.
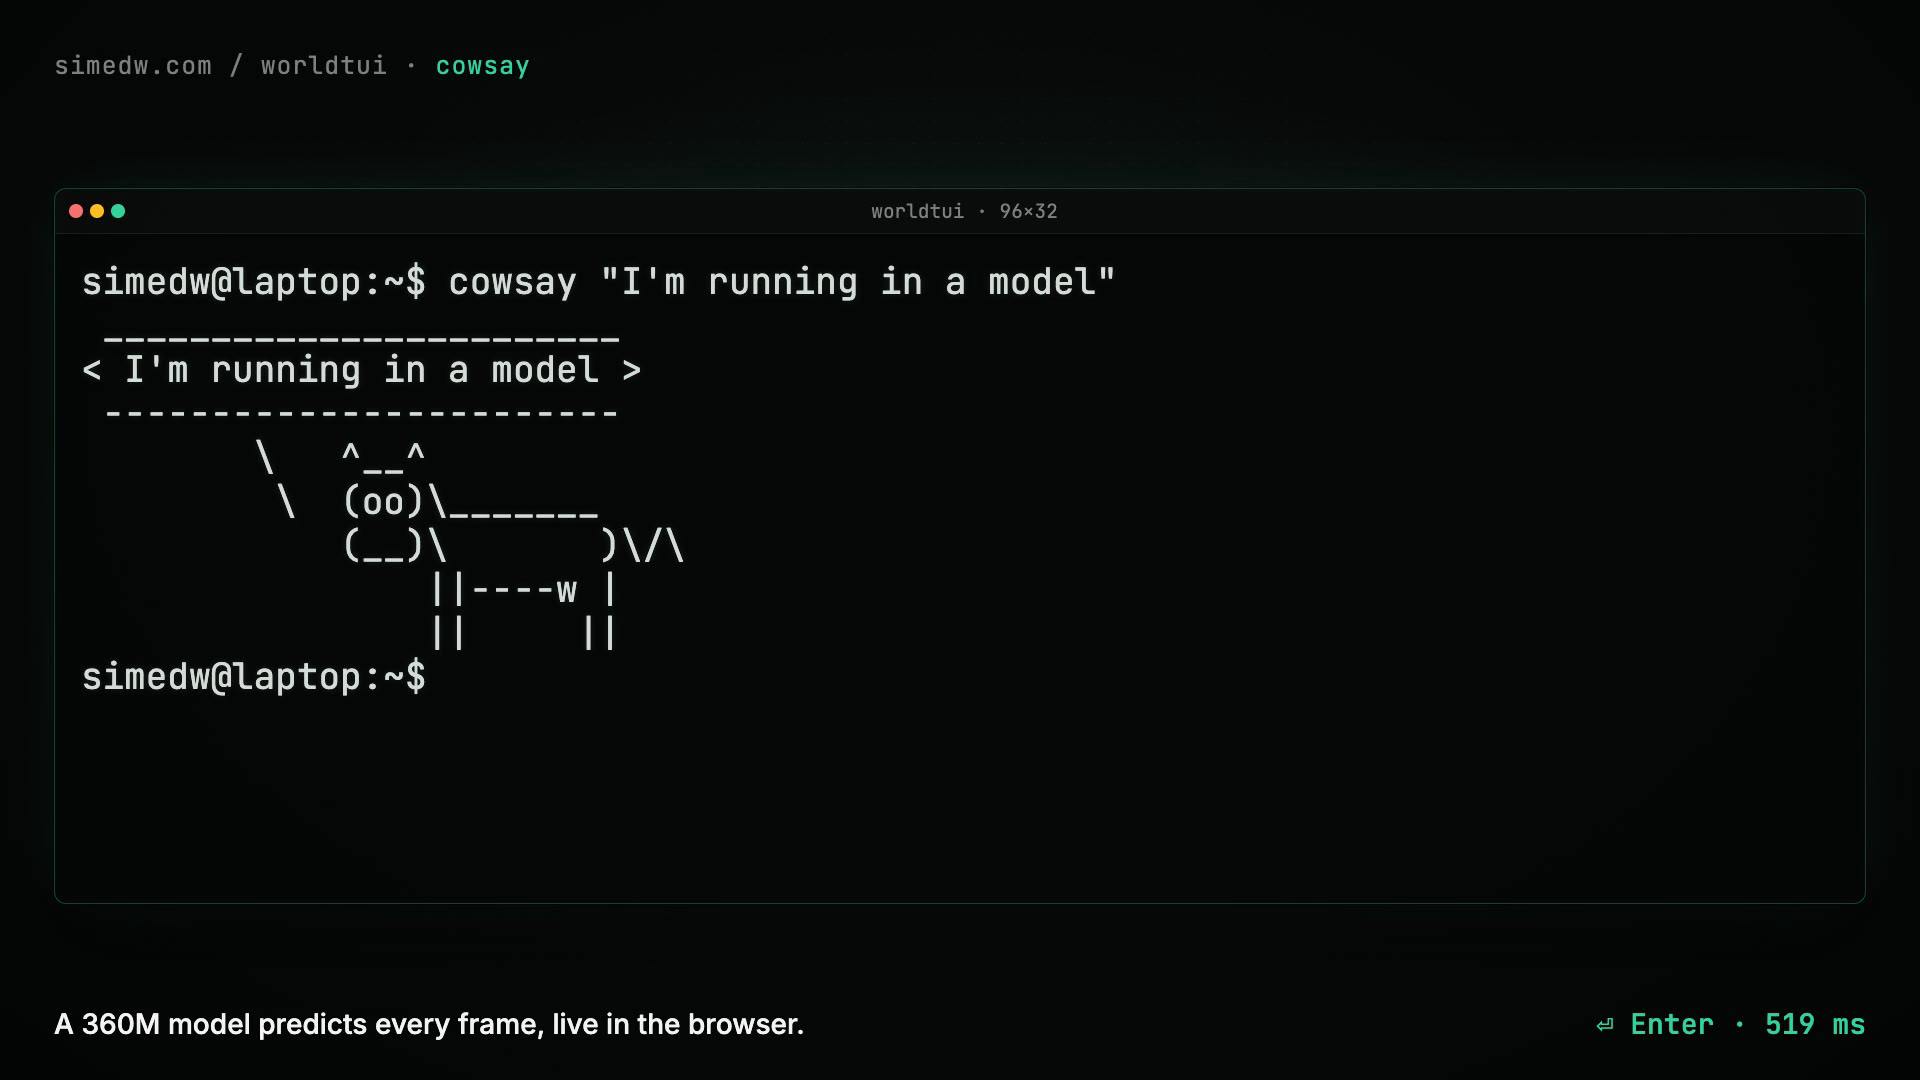 사진: WorldTUI가 브라우저 내에서 예측해 낸 cowsay 출력 및 디렉터리 탐색 화면. 상단에서 행과 열 크기를 자유롭게 조절할 수 있다. 출처: SimEdw 블로그 (프로젝트 공식 스크린샷)
이미 2022년에 개발자들이 ChatGPT에 프롬프트를 주어 리눅스 터미널을 흉내 내게 한 적이 있었고, 이후 GameNGen은 확산 모델로 둠(Doom)을 프레임 단위로 시뮬레이션했으며, NeuralOS는 그래픽 데스크톱 인터페이스(GUI) 생성을 시도했습니다. 하지만 픽셀 단위의 비디오 세계 모델은 거대한 GPU 클러스터와 방대한 비디오 데이터셋을 요구하므로 개인 개발자가 감당하기 어렵습니다. 실험 무대를 픽셀 화면에서 터미널 문자 격자로 옮겨오면서 이러한 연산 비용 장벽을 완벽하게 우회할 수 있었습니다. 실제 셸은 라벨이 완벽하게 붙은 무제한의 훈련 데이터를 무료로 생성해 주며, 사전 훈련된 코드 모델은 ls나 cat이 무엇을 출력해야 하는지 이미 직관적으로 파악하고 있기 때문입니다. 세계 모델의 무대를 픽셀에서 문자 격자로 좁힌 덕분에, 일반 소비자용 그래픽카드 한 장으로도 ‘상태 일관성’이라는 핵심 과제를 온전히 검증할 수 있었습니다.
333개 토큰과 한 줄 복사 명령어로 스크롤 연산 비용 97% 절감
일반적인 대형 언어 모델은 텍스트 끝에 토큰을 차례대로 덧붙이기만 하는데, 이러한 구조를 터미널 환경에 그대로 적용하면 즉시 한계에 부딪힙니다. vim에서 Esc 키를 눌러도 새 텍스트는 생성되지 않으며, clear를 실행하면 화면 전체가 지워지고 커서가 좌측 상단으로 이동하므로 출력 위치가 결코 아래쪽에 고정되지 않습니다. 이에 개발자는 단순 텍스트 흐름 예측을 포기하고, 모델이 ‘화면 격자의 변화량(델타)‘을 예측하도록 설계를 바꿨습니다. 각 세션 시작 시 터미널 크기(예: 32×96), 현재 문자 내용, 커서 위치를 포함한 스냅샷을 입력하고, 이후의 키 입력에 대해서는 ‘어느 행을 다시 쓸 것인지, 커서가 어디에 멈출 것인지’만 출력하게 했습니다. 격자 크기 자체가 입력값으로 들어가기 때문에 모델은 중간 상태에서도 얼마든지 이어받을 수 있으며, 진행 중이던 스네이크 게임이나 작업 중이던 vim 버퍼를 넘겨주어도 자연스럽게 다음 장면을 이어 나갑니다.
키보드 입력은 실제 터미널이 전송하는 원시 바이트를 그대로 사용합니다. 엔터는 \r, Escape는 0x1b, 왼쪽 화살표 키는 ESC [ D입니다. 사용자가 아무런 입력도 하지 않는 유휴 상태에서는 지속 시간이 포함된 WAIT 토큰을 주입하며, 스네이크 게임은 이 시간 신호 덕분에 스스로 앞으로 이동할 수 있습니다. 개발자는 좌표와 문자를 위해 새로운 토큰 어휘를 만들지 않고, 256개 전체 바이트 값을 다루는 Qwen 본래의 바이트 토큰을 그대로 재사용하여 17과 같은 행 좌표도 단 1개의 토큰으로 표현했습니다. 진짜 걸림돌은 스크롤이었습니다. 터미널이 한 줄 위로 스크롤될 때마다 화면 전체의 글자가 한 줄씩 이동하므로, 모델이 화면 전체를 매번 다시 출력하게 하면 엔터 키를 한 번 칠 때마다 약 3,000개의 토큰을 쏟아내야 했습니다.
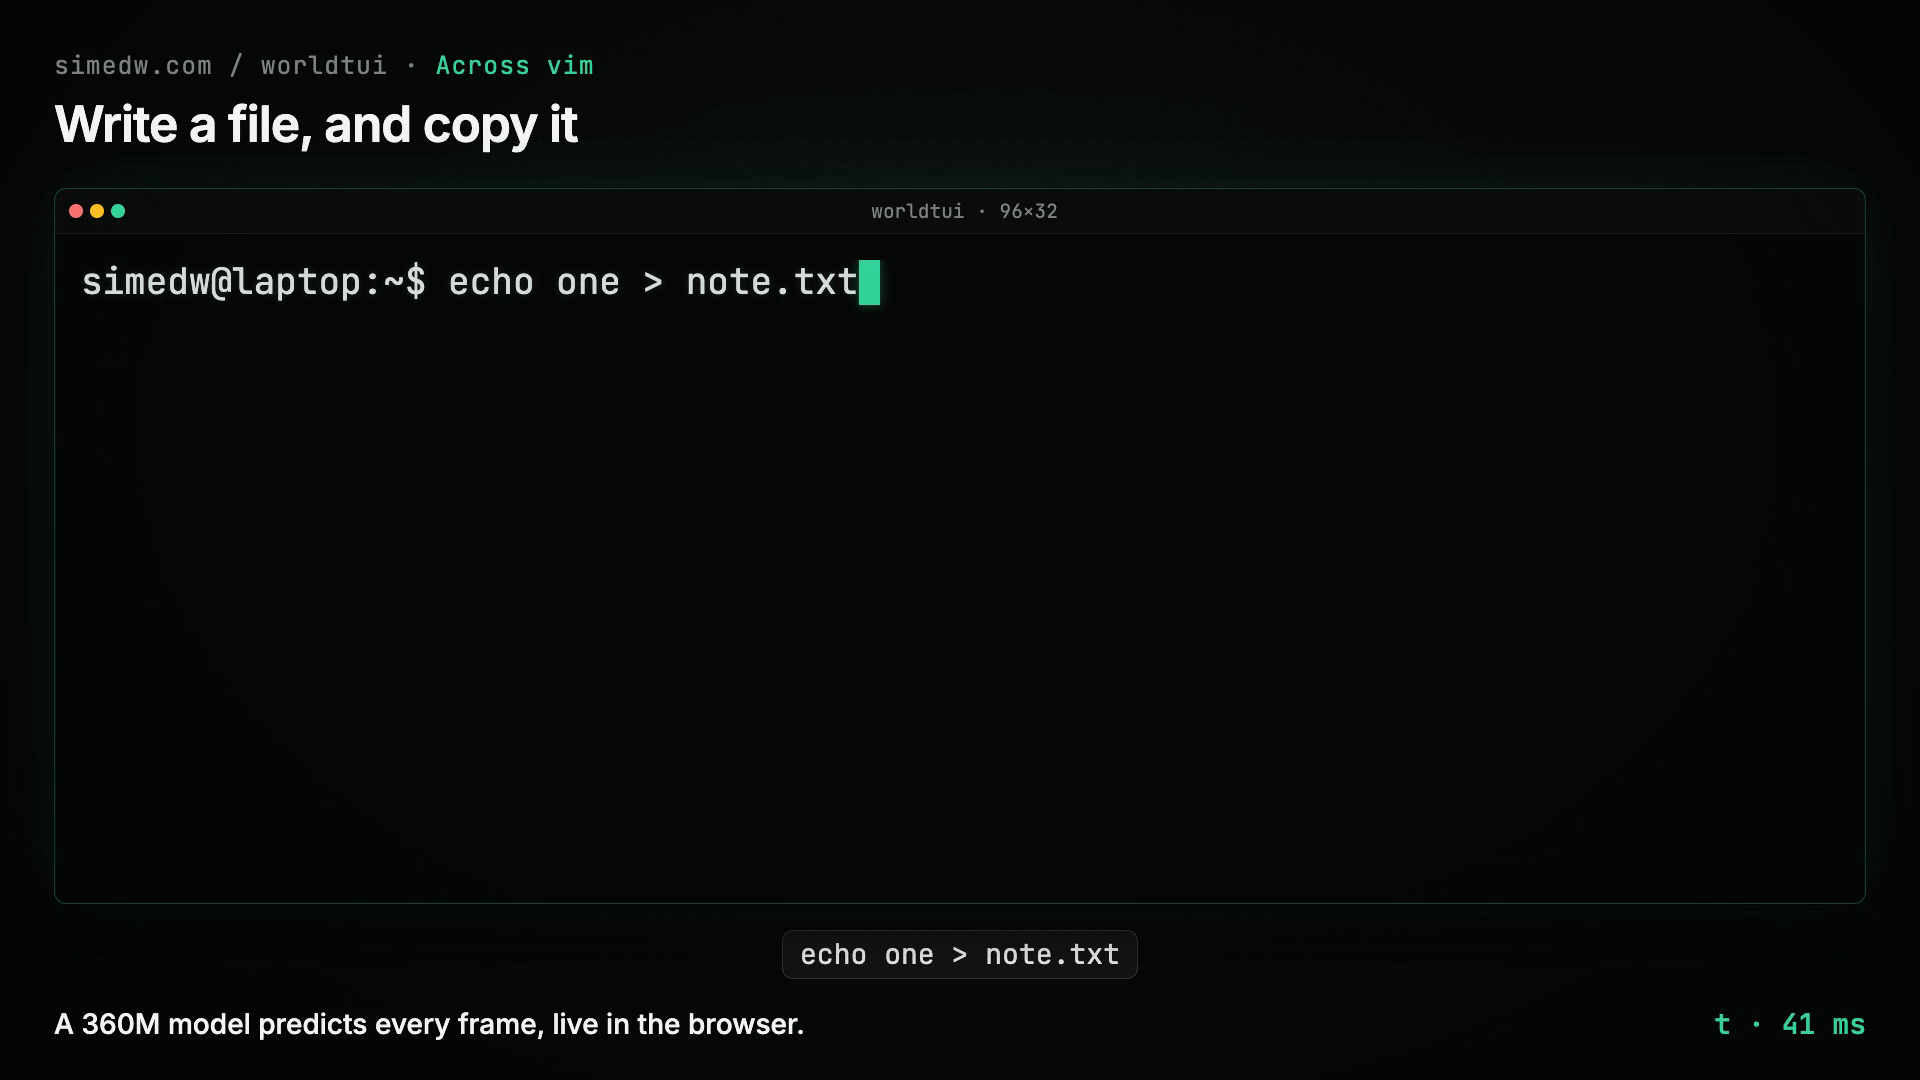 사진: vim 화면에서 여러 줄 복사를 수행하는 WorldTUI. 행 단위 COPY 명령어를 통해 전체 화면 다시 그리기를 방지한다. 출처: SimEdw 블로그 (데모 영상 캡처)
이러한 연산 낭비를 없애기 위해 개발자는 ROW_0 COPY 1, ROW_1 COPY 2와 같은 행 단위 복사 명령어를 도입했습니다. 스크롤할 때 각 행은 3개의 토큰만으로 위치를 옮길 수 있어, 기존에 행당 약 96개씩 들던 화면 재출력 비용을 대체했습니다. 이 방식은 화면 지우기, vim의 행 삽입 및 삭제, man 매뉴얼 페이지 넘김 시 발생하는 부분 갱신 문제까지 깔끔하게 해결했습니다. 최종적으로 모델의 활성 토큰 어휘는 단 333개(256개 바이트 토큰, 64개 행 토큰 및 소수의 특수 제어 토큰)로 압축되었으며, 문법 제약 디코딩과 결합하여 모든 예측이 올바른 화면 갱신 규칙을 따르도록 보장했습니다. 단말 기기 환경에서 세계 모델이 제대로 구동될 수 있는지는 신경망의 크기뿐만 아니라 상태 변화량을 얼마나 효율적으로 부호화하느냐에 절반이 달려 있습니다.
75시간 만에 길러낸 환각 억제력: 이전 실수를 스스로 교정하게 만든 훈련법
토큰 체계를 확정한 뒤, 기존의 터미널 녹화 데이터셋(asciinema 포함)에는 키 입력과 화면 프레임 간의 정밀한 대응 관계가 없다는 사실을 확인한 개발자는 도커(Docker) 컨테이너 안에서 데이터를 직접 합성했습니다. 가상의 소프트웨어 개발자나 시스템 관리자 설정을 바탕으로 디렉터리 트리와 사용자 이름을 무작위로 생성하고, 파일 수정, 파이썬 코드 작성, tmux 실행 등 6개에서 24개의 작업을 엮어 세션을 구성했습니다. 한 글자씩 타이핑하는 속도와 Tab 자동 완성을 모사했을 뿐만 아니라, 일부러 1.2%의 오타율을 섞고 전체 세션의 35%는 중간 단계부터 시작하도록 설계했습니다. 이 파이프라인을 통해 최종적으로 33만 6천 개의 세션 에피소드(약 20억 토큰)가 확보되었으며, 32×96, 24×80, 40×120 등 다양한 화면 해상도를 망라했습니다.
지도 미세 조정(SFT)만으로도 모델에게 타이핑, 백스페이스, 커서 이동을 학습시키는 것은 쉬웠지만, 긴 세션에 들어가면 여지없이 무너졌습니다. 모델이 어느 한 단계에서 파일 이름의 철자를 틀리는 순간, 그 실수가 문맥을 따라 끝없이 퍼져나갔기 때문입니다. 개발자는 로봇 제어 분야의 DAgger(Dataset Aggregation) 알고리즘에서 힌트를 얻어 자체 오류 교정 훈련 파이프라인을 구축했습니다. 실제 기록된 세션의 한 지점에서 모델이 혼자서 1~4단계를 진행하게 한 뒤, 예측된 잘못된 화면이 정답 화면과 너무 멀리 떨어져 있지 않다면 인위적인 ‘교정’ 단계를 구성하여 다음 키 입력 시 잘못된 화면을 올바른 상태로 강제로 되돌리도록 했습니다.
여기에는 성공을 가르는 엄격한 규칙이 숨어 있었습니다. 교정 동작에 등장하는 모든 단어는 반드시 이전의 올바른 화면이나 사용자의 입력 기록에 이미 존재했던 것이어야 한다는 점입니다. 모델이 이전에 보았던 파일 이름의 철자를 틀렸을 때 이를 바로잡도록 훈련하면 기억력이 향상되지만, 모델이 한 번도 본 적 없는 파일 이름을 허공에서 지어냈을 때 이를 실제 파일 이름으로 강제로 바꾸게 훈련하면 오히려 환각을 정당화하고 장려하는 꼴이 되기 때문입니다. 표본 추출된 세션 중 약 3분의 1에서 유효한 교정 표본을 얻을 수 있었고, 개발자는 단일 RTX 4090에서 75 GPU 시간을 들여 3단계 반복 학습을 마쳤습니다. 그 결과 int4 양자화 모델의 PresetBench(실제 오류가 발생하기 쉬운 47개 스크립트 평가 셋) 점수는 24/47에서 38/47로 대폭 상승했습니다. 자기회귀 세계 모델에서 가장 경계해야 할 것은 오차 누적이며, 추론 분포 위에서 교정 행동을 직접 학습시키는 것이 맹목적으로 시연 데이터를 늘리는 것보다 훨씬 효과적입니다.
기본 모델보다 4배 뛰어난 세션 간 복원력, 그러나 명령어의 낯선 조합에는 여전히 무력
모델이 과연 가상 세계의 일관성을 제대로 지켜내는지 확인하기 위해 훈련 세트에 없는 세 가지 평가 항목이 설계되었습니다. 그중 가장 가혹한 시험은 세션 간 기억력 테스트(Memory Test)였습니다. 32개의 독립된 가상 세계에서 각각 두 개의 파일에 무작위 문자열을 작성한 뒤 새 세션으로 전환하여 다시 읽어 들이고, 두 파일의 내용이 완벽하게 일치해야 합격으로 판정했습니다. 결과는 뚜렷한 격차를 드러냈습니다.
| 모델 구성 | 파라미터 수 | ShellBench (106개 명령어) | 세션 간 파일 읽기 복원 (Memory Test) |
|---|---|---|---|
| WorldTUI (미세 조정 세계 모델) | 360M | 80 / 106 | 9 / 13 |
| Qwen2.5-Coder-0.5B (프롬프트 역할극) | 500M | 52 / 106 | 2 / 13 |
| Qwen3-0.6B (프롬프트 역할극) | 600M | 60 / 106 | 3 / 13 |
세션 간 기억력에서 WorldTUI는 9/13을 기록하며, 프롬프트로 터미널을 흉내 낸 동급 기본 모델보다 3~4배 뛰어난 성능을 보였습니다. 그러나 공학적 한계 역시 동일한 성적표에서 고스란히 드러났습니다. 모델은 정형화된 단일 패턴의 명령어는 안정적으로 처리하지만, 익숙한 명령어들을 새로운 방식으로 조합하는 순간 여지없이 허점을 드러냅니다. 예를 들어 echo green >> colors로 파일 뒤에 문자열을 덧붙인 뒤 곧바로 cat colors를 실행하면, 방금 추가한 문장이 화면에서 통째로 사라지는 일이 빈번하게 발생합니다. 지지자들은 360M 모델이 순수 어텐션 메커니즘만으로 약 70%의 세션 간 상태 유지를 달성한 점을 들어 ‘신경 상태 머신’의 가능성을 입증했다고 평가합니다. 반면 회의론자들은 가장 기초적인 리다이렉션 추가조차 안정적으로 일반화하지 못한다는 사실이야말로 확률적 예측이 결정론적인 운영체제 커널을 결코 대신할 수 없음을 보여주는 증거라고 반박합니다.
일반화의 한계 외에도 순수 자기회귀 생성 방식은 반응 속도를 심각하게 떨어뜨릴 뻔했습니다. 토큰을 하나씩 순차적으로 생성할 때 일반적인 타이핑 지연 시간은 약 38밀리초로 수용할 만한 수준이었지만, vim, man, clear와 같은 전체 화면 다시 그리기 작업에서는 한 번에 최대 3,000개의 토큰을 출력해야 해 RTX 4090에서도 12초나 기다려야 했습니다. 개발자는 여기서 중요한 사실을 깨달았습니다. 한 화면 안에서 대다수의 행은 서로 독립적이므로 굳이 한 줄씩 순서대로 생성할 필요가 없다는 점입니다. 그는 각 행을 독립적인 배치 단위로 나누고, 동일한 이전 KV 캐시를 공유하면서 전용 어텐션 마스크를 결합하여 모든 행을 동시에 병렬로 디코딩한 다음, 마지막에 한 단계로 커서 위치만 예측하도록 구조를 바꿨습니다. 이를 통해 전체 화면 디코딩 단계는 3,000단계에서 가장 긴 한 행의 폭인 약 100단계로 대폭 줄어들었고, 대형 프레임의 p95 지연 시간은 6.7초에서 0.87초로 급감했습니다(다만 파이어폭스의 WebGPU 환경에서는 브라우저 드라이버 차이로 인해 크롬보다 약 20배 느린 것으로 나타났습니다). 과거의 글자를 기억하는 것과 파일 시스템의 의미론을 이해하는 것은 별개의 문제입니다. 기호 규칙의 제약이 없는 순수 신경망 예측은 조합적 일반화라는 거대한 벽 앞에서 멈춰 설 수밖에 없습니다.
WorldTUI는 75 GPU 시간이라는 적은 비용의 실험을 통해 ‘소프트웨어로서의 AI’라는 열풍에 냉철한 시각을 던져주었으며, 360M 파라미터 모델이 지닌 역량의 경계를 명확히 짚어냈습니다. 333개 토큰의 간결한 상태 표현, DAgger 오류 교정 훈련, 행 병렬 디코딩 덕분에 단 한 줄의 셸 코드 없이도 파일을 편집하고, 화면을 분할하며, 스네이크 게임을 구동할 수 있는 가상 터미널을 브라우저의 208MB 캐시 안에 담아냈습니다. 하지만 echo green >> colors 뒤에 사라져 버린 한 줄의 출력은, 화면 표면의 시각적 문자 규칙을 예측하는 것과 화면 이면의 상태 전이 규칙을 장악하는 것 사이에 단순한 시연 데이터 축적만으로는 메울 수 없는 깊은 격차가 존재함을 상기시켜 줍니다. 개발자는 앞으로 무작위로 생성된 수천 개의 마이크로 앱을 대상으로 모델을 훈련시켜 문맥 단서만으로 낯선 소프트웨어의 조작 규칙을 파악할 수 있는지 시험할 계획입니다. 그 단계까지 통과해야만 세계 모델은 비로소 ‘화면 녹화 암기’에서 ‘소프트웨어 논리 이해’로 진정한 도약을 이뤄낼 수 있을 것입니다.
참고 링크:
- SimEdw 블로그: WorldTUI 터미널 세계 모델 기술 회고
- 해커 뉴스(Hacker News): WorldTUI 관련 기술 토론