ブラウザ上で208 MBのWebアプリを開き、vim test.txt と打ち込むと、画面は瞬時に見慣れたエディタへと切り替わります。tmux で画面を分割し、さらにはヘビゲーム(Snake)を起動しても、カーソルは何の引っかかりもなく滑らかに追従します。しかし、コマンドラインであえてタイプミスの pythoon を入力した瞬間、奇妙な現象が露呈します。「command not found」と怒られることもフリーズすることもなく、何事もなかったかのようにPythonの対話型プロンプトが立ち上がるのです。この「WorldTUI」と呼ばれる端末の背後にはbashプロセスもマウントされたファイルシステムも存在しません。画面上のあらゆる変化は、360Mパラメータの言語モデルがリアルタイムに予測して描画しているに過ぎません。
360MパラメータのWorldTUIは、基盤コードを1行も実行することなく自己無撞着な端末世界を維持し、セッションをまたいで約7割のファイル内容を記憶します。しかし、モデルは画面上の文字の変化を予測しているだけで根底の規則を理解していないため、既知のコマンドを新しい組み合わせで実行した瞬間にその世界は破綻します。
ブラウザに収まる360Mパラメータ、本物のコードは1行も動かない
WorldTUIの基盤は、Alibabaがオープンソース化したQwen2.5-Coder-0.5Bを刈り込み・ファインチューニングして360Mパラメータに縮小したモデルであり、デスクトップ版ChromeやEdgeブラウザ内でWebGPUを介して直接ローカル推論されます。開発者の位置づけは極めて率直です。「これに実用性はあるか?ほぼない」。彼が本当に検証したかった問いは、DeepMindのGenie 3が提示した思想に根ざしています——もし将来のソフトウェアがエンジニアの手によるコードの積み上げではなく、ユーザー入力に応じてニューラルネットワークが次のフレームを直接予測して動くとしたら、これほど小さなモデルでも整合性のある世界を維持し続けられるのか、という問いです。
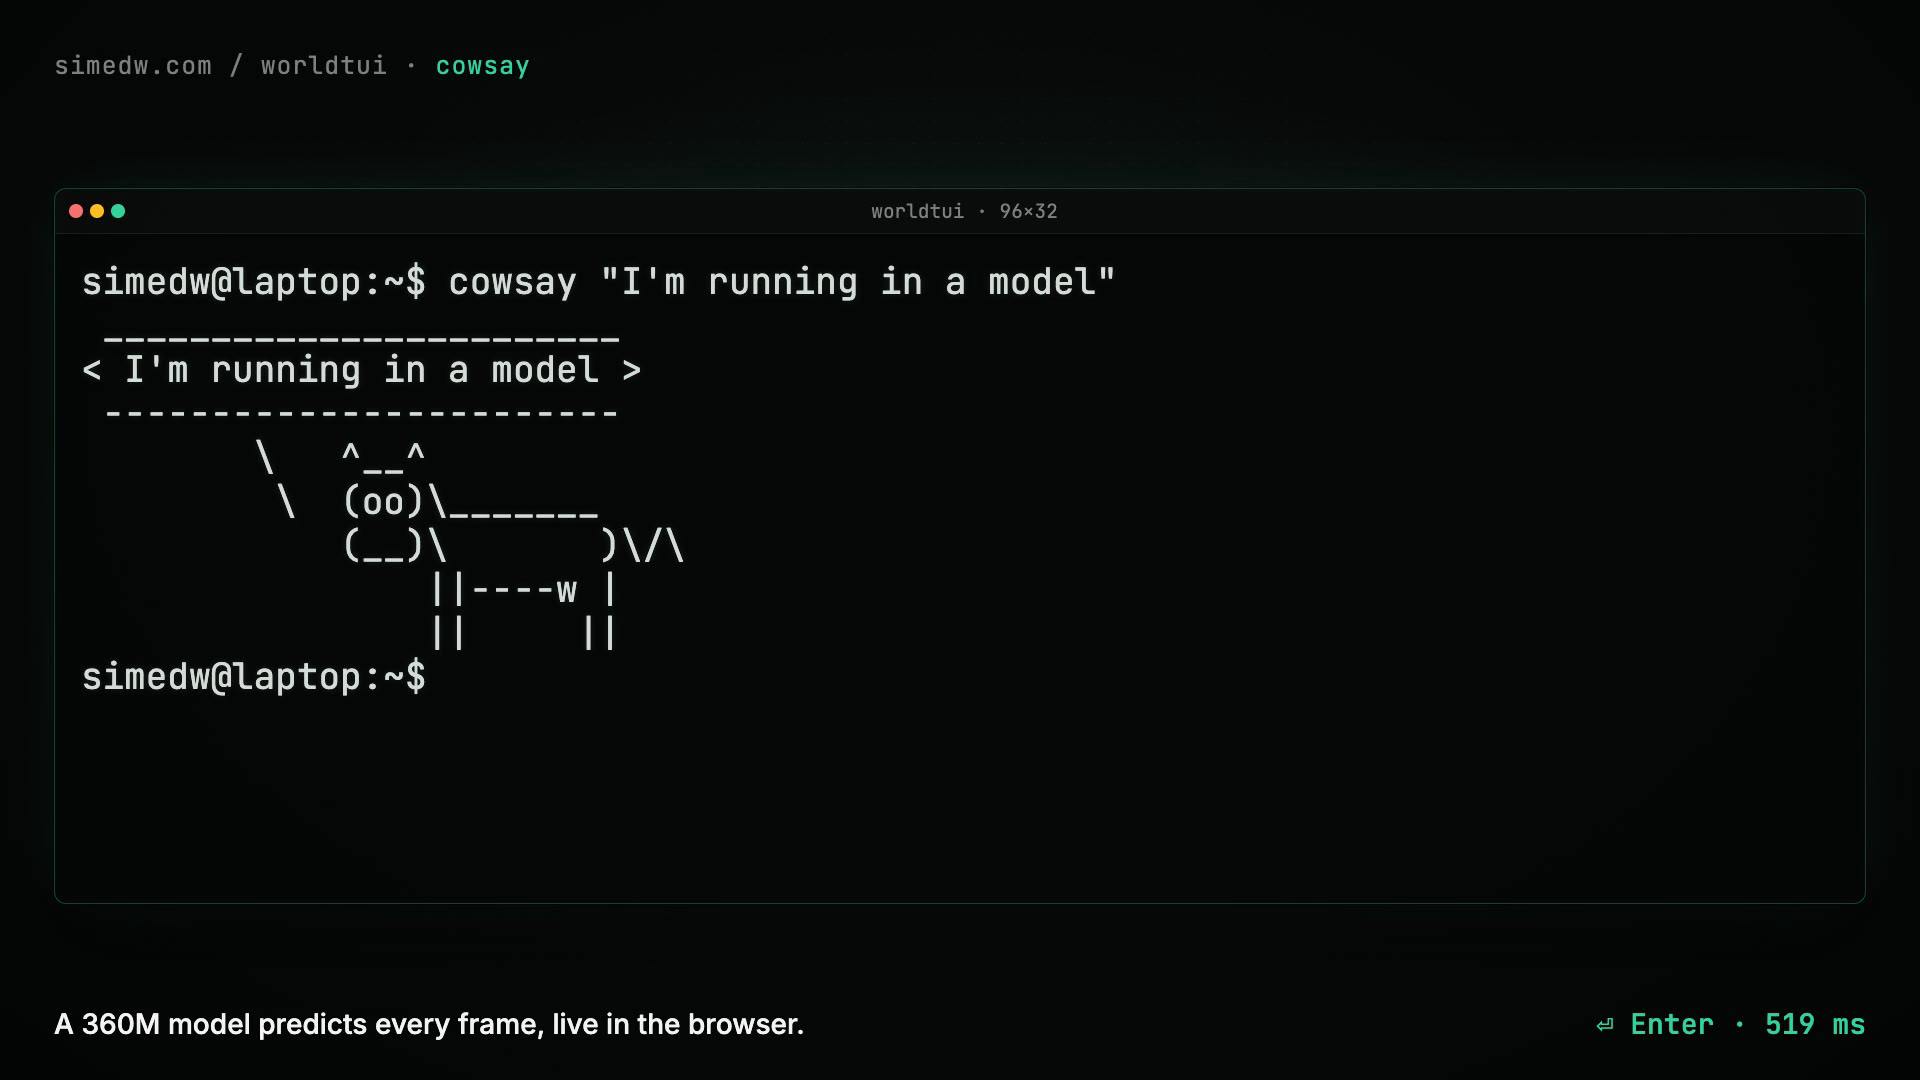 図:WorldTUIがブラウザ内で予測・出力したcowsayとディレクトリ操作画面。上部でグリッドの行・列サイズを自由に変更できる点に注目。出典:SimEdw’s Blog(プロジェクト公式の実機スクリーンショット)
2022年にはすでにChatGPTにプロンプトを与えてLinux端末を演じさせる試みがあり、その後GameNGenは拡散モデルで『Doom』をフレーム単位でシミュレートし、NeuralOSはグラフィカルデスクトップ(GUI)の生成に挑戦しました。しかし、ピクセル単位の動画世界モデルには膨大なGPUクラスタと大量の動画データセットが必須であり、個人開発者が手を出せる領域ではありません。実験場をピクセル描画から端末の文字グリッドへと退行させたことで、計算資源の壁を見事に回避できました。本物のシェルを使えば、ラベル付きの完璧な学習データを無限かつ無償で生成でき、事前学習済みコードモデルは ls や cat が何を出力すべきかをあらかじめ直感的に把握しているからです。世界モデルの対象をピクセルから文字グリッドへ凝縮したことで、市販のコンシューマ向けGPU単体でも「状態の一貫性」という核心命題を検証できるようになりました。
333トークンと1行のコピー命令で、スクロールの計算コストを97%削減
一般的な大規模言語モデルはテキストの末尾にトークンを順次追加していくだけですが、この仕組みをターミナルにそのまま持ち込むと即座に行き詰まります。vimで Esc キーを押しても新たなテキストは生成されず、clear を実行すれば画面全体が消去されてカーソルは左上へ戻るため、出力位置は決して末尾に固定されません。そこで作者はテキストストリームの予測を諦め、モデルに「画面グリッドの差分更新」を予測させる方式へと舵を切りました。各セッションの開始時に端末サイズ(例: 32×96)、現在の文字内容、カーソル位置を含むスナップショットを入力し、以降のキー入力では「どの行を書き換えるか、カーソルがどこに着地するか」のみを出力します。画面サイズ自体が入力パラメータであるため、途中の状態からでも引き継ぐことができ、プレイ途中のヘビゲームや編集途中のvimバッファを渡してもそのまま後続を演じ続けられます。
キー入力は本物の端末が送信する生バイトをそのまま採用しており、Enterは \r、Escapeは 0x1b、左矢印キーは ESC [ D です。ユーザーが何も入力しないアイドル状態では、時間幅を持った WAIT トークンが注入され、ヘビゲームはこの時間信号を頼りに自律して前進します。作者は座標や文字のために新たな語彙を発明せず、全256バイト値をカバーするQwen本来のバイトトークンを再利用し、17 といった行番号座標もわずか1トークンで表現させました。真のボトルネックとなったのはスクロールでした。端末が1行上にスクロールするたびに全画面の文字が1行分シフトするため、画面全体を最初から出力し直させると、Enterを1回押すごとに約3000トークンを消費することになります。
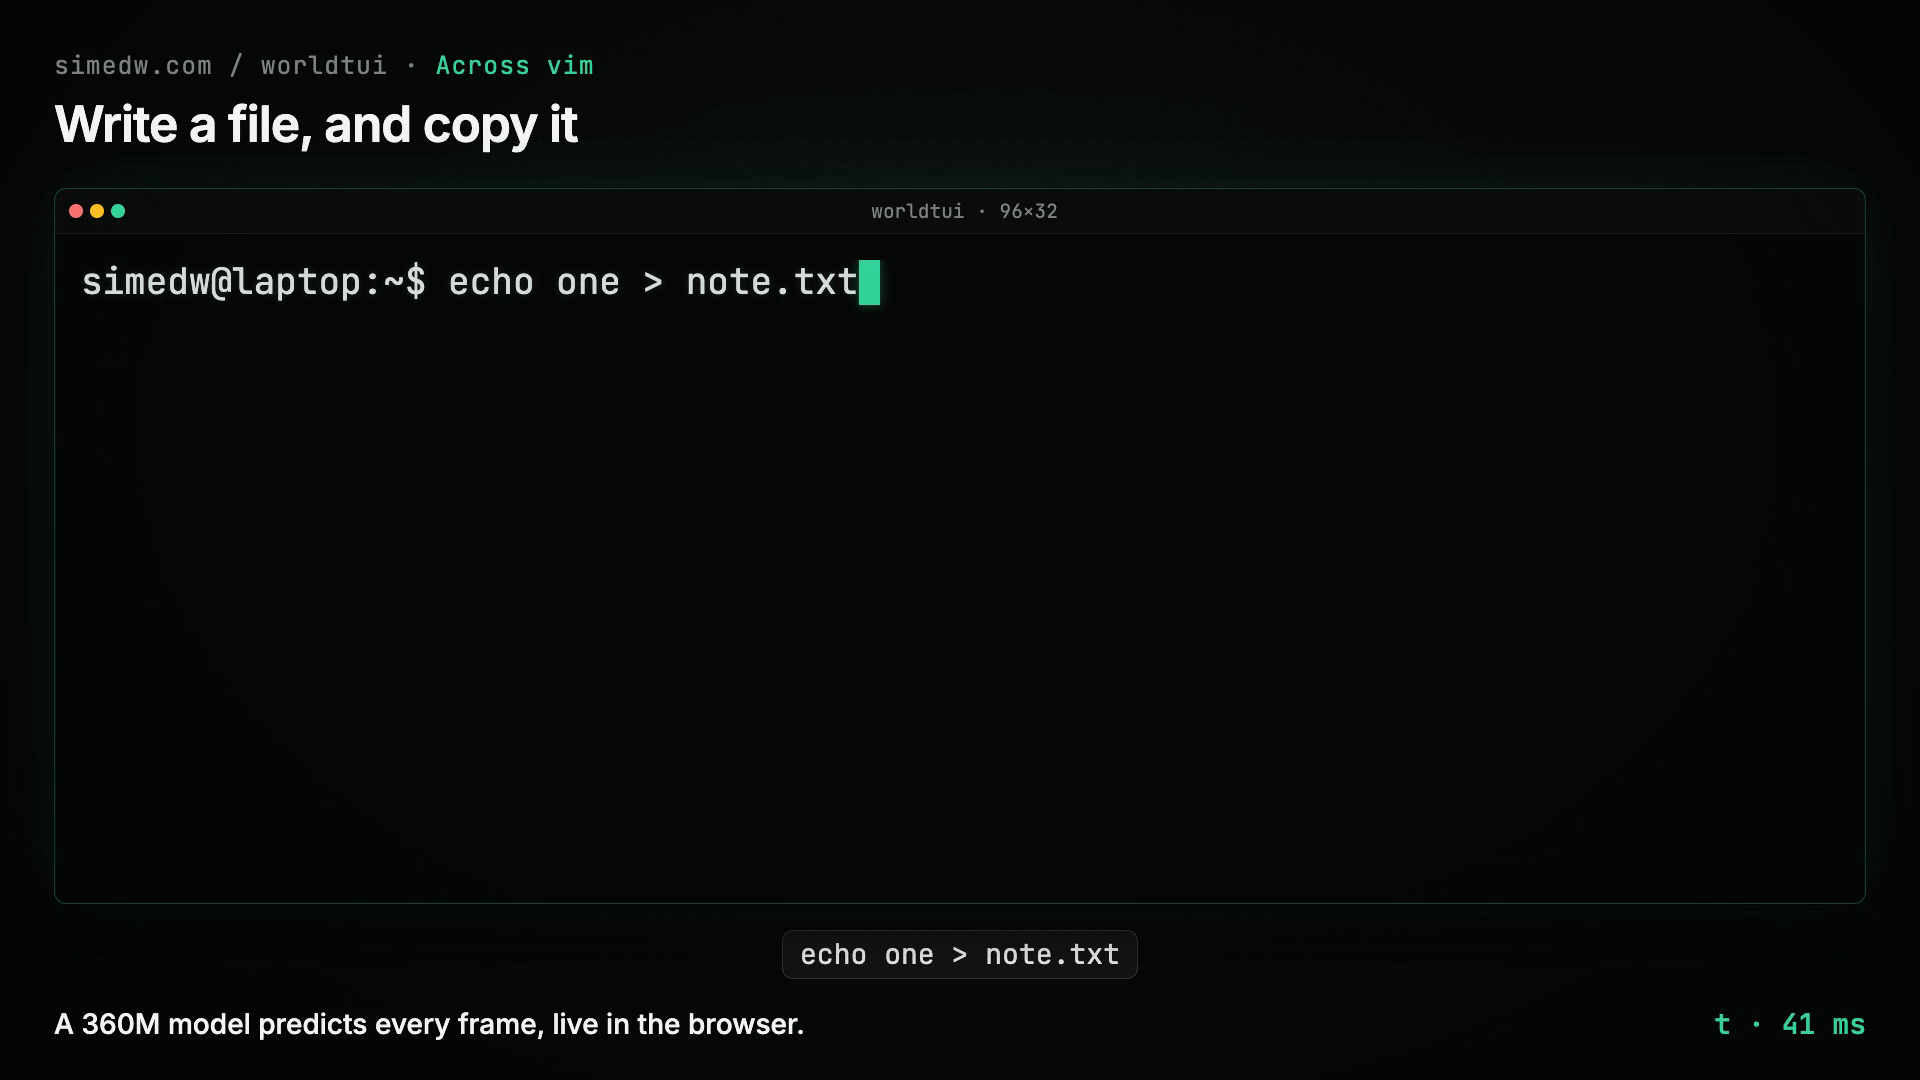 図:vim環境下で複数行コピーを実行するWorldTUI。行単位のCOPY命令により全画面の再描画を回避している。出典:SimEdw’s Blog(デモ動画キャプチャ)
この計算リソースのブラックホールを埋めるため、作者は ROW_0 COPY 1 や ROW_1 COPY 2 といった行コピー命令を導入しました。スクロール時の各行移動はわずか3トークンで完結し、従来の1行あたり約96トークンという再描画コストを置き換えました。副産物として画面消去やvimの行挿入・削除、man ページ閲覧時の局所更新も一挙に解決しました。最終的にモデルのアクティブ語彙はわずか333トークン(256個のバイトトークン、64個の行トークン、少数の特殊操作)にまで圧縮され、文法制約デコードと組み合わせることで、すべての予測が合法的な画面更新となることを保証しています。エッジ端末上で世界モデルを成立させられるかどうかは、ニューラルネットワークの規模だけでなく、状態差分のエンコード効率に半分依存しています。
75時間の学習で「幻覚への耐性」を獲得:自らの誤りを正させる仕組み
語彙が固まった後、既存のターミナル録画データセット(asciinemaを含む)にはキー入力と画面フレームの正確な対応関係が存在しないことが判明し、作者はDockerコンテナ内でデータを自作せざるを得ませんでした。合成パイプラインでは、開発者やシステム管理者といった架空のペルソナに基づきディレクトリツリーとユーザー名をランダム生成し、ファイルの編集からPythonスクリプトの実行、tmuxの起動に至る6〜24のアクティビティを組み合わせてセッションを構築しました。1文字ずつのタイピングやTab補完を忠実に模倣しただけでなく、あえて1.2%のタイプミスを混入させ、全体の35%のセッションを途中から開始させました。このパイプラインによって最終的に33万6000件のエピソード(約20億トークン分)が蓄積され、32×96、24×80、40×120など多様な画面サイズが網羅されました。
教師あり微調整(SFT)だけを行っても、タイピングやバックスペース、カーソル移動の処理は容易に学習できますが、長時間のセッションに入ると即座に崩壊します。あるステップでファイル名を一度でもスペルミスすると、その誤りがコンテキストを通じて後続の処理全体に伝播してしまうためです。作者はロボット制御分野のDAgger(Dataset Aggregation)アルゴリズムに着想を得て、自己修正型の訓練パイプラインを設計しました。実録セッションの特定の地点からモデルに自律的に1〜4ステップ進めさせ、予測された誤った画面が正解画面から乖離しすぎていなければ、人為的な「修正」アクションを構築し、次のキー入力時に誤った画面を強引に正しい状態へと引き戻します。
ここには成否を分ける厳格な制約が潜んでいます。修正アクション内に登場するあらゆる単語は、過去の正解画面やユーザーの入力履歴に現れたことのあるものでなければならないという点です。以前目にしたことのあるファイル名の綴りを間違えた場合、それを正しく修正するよう訓練することは記憶の定着を促します。しかし、一度も現れていないファイル名をモデルが勝手に捏造した場合、それを本物のファイル名に強引に直す訓練を課すことは、かえって幻覚(ハルシネーション)を肯定し報酬を与えることになってしまいます。サンプリングされたセッションの約3分の1から正当な修正サンプルが得られ、作者は単一のRTX 4090上で75 GPU時間を費やして3サイクルの反復を実行。これによりint4量子化モデルのPresetBench(47個の壊れやすい実測スクリプトケース)のスコアは24/47から38/47へと劇的に向上しました。自己回帰型世界モデルが最も恐れるべきは長期的な誤差の蓄積であり、推論分布上で修正動作を直接学習させるアプローチは、盲目的にデモデータを拡大するよりも遥かに実効性があります。
セッション越境の復元率はベースモデルの4倍、それでもコマンドの初見の組み合わせには屈する
モデルが真に世界の整合性を維持できているかを検証するため、訓練セットには含まれない3つの評価基準が用意されました。その中で最も過酷だったのが「セッション越境記憶テスト(Memory Test)」です。32個の独立した仮想世界において、それぞれ2つのファイルにランダムな文字列を書き込み、新規セッションに切り替えた後に正しく読み出せるかをテストしました。2つのファイルが完全に一致して初めて合格となります。その測定結果は歴然とした差を示しました。
| モデル構成 | パラメータ数 | ShellBench(106コマンド) | セッション越境ファイル復元(Memory Test) |
|---|---|---|---|
| WorldTUI(微調済み世界モデル) | 360M | 80 / 106 | 9 / 13 |
| Qwen2.5-Coder-0.5B(プロンプトによる模擬) | 500M | 52 / 106 | 2 / 13 |
| Qwen3-0.6B(プロンプトによる模擬) | 600M | 60 / 106 | 3 / 13 |
セッション越境記憶において、WorldTUIは9/13を叩き出し、システムプロンプトで端末を模擬させた同規模のベースモデルに3〜4倍の差をつけました。しかし、エンジニアリング上の限界点も同じスコアシートの上に露呈しました。単一パターンの定型コマンドは極めて安定して処理できる反面、見慣れたコマンドを少し新しい形で組み合わせた途端、脆くも化けの皮が剥がれてしまうのです。たとえば、echo green >> colors でファイルに文字列を追記し、直後に cat colors を実行すると、今しがた追加したはずの行が画面から綺麗に消失することが頻発します。支持者たちは、360Mのモデルが純粋なアテンション機構だけで約7割のセッション越境状態保持を達成したことは「ニューラル状態機械」の実現可能性を証明したと評価します。一方で懐疑派は、最も初歩的なリダイレクト追記すら安定して汎化できない事実は、確率的な予測が決して決定論的なOSカーネルの代用にはなり得ない証左であると指摘します。
汎化性能の壁に加え、純粋な自己回帰生成はインタラクションの快適さそのものを損ないかけました。トークン単位で生成する場合、通常のタイピング遅延は約38ミリ秒と許容範囲内でしたが、vim や man、clear のような全画面再描画を伴う操作では、1回につき最大3000トークンを吐き出す必要があり、RTX 4090上でも12秒もの待機を強いられました。そこで作者はある盲点に気づきます。同一フレーム内のほとんどの行は互いに独立しており、1行ずつシリアルに生成する必要はまったくないという点です。各行を独立したバッチ要素(Batch Element)に分割し、同一のプレフィックスKVキャッシュを共有させつつ専用のアテンションマスクを適用することで、全行を同時に並列デコードし、最後にカーソル位置だけを単一ステップで予測する構成へと変更しました。この改良により、全画面のデコードステップ数は3000ステップから最長行の約100ステップへと激減し、巨大フレームのp95レイテンシは6.7秒から0.87秒へと急激に改善されました(ただしFirefoxのWebGPU環境ではChromeより約20倍遅く、ブラウザ側のドライバ実装の差異と見られています)。過去の文字列を記憶していることとファイルシステムのセマンティクスを理解していることは同義ではありません。記号規則の制約を欠いた純ニューラル予測の前には、合成的汎化という越えられない強固な壁が立ちはだかっています。
WorldTUIが75 GPU時間の低コスト実験を通じて投げかけた問いは、「AI即ソフトウェア」という熱狂に対する冷静な冷や水であり、同時に360Mパラメータモデルの能力の境界線を明確に描き出しました。333トークンの無駄のない状態表現、DAggerによる自己修正訓練、行並列デコードの組み合わせにより、一行のシェルコードも動かすことなく、ファイルの編集、画面分割、ヘビゲームの動作が可能な仮想端末をブラウザの208 MBキャッシュへと見事に詰め込みました。しかし、echo green >> colors の後に消え去った1行の出力は、画面表面の文字の並びを予測することと、画面の背後にある状態遷移のルールを支配することとの間には、単に類似のデモデータを積み上げるだけでは埋められない深い溝が存在することを思い知らせてくれます。作者は今後、数千の自動生成されたマイクロアプリ上で学習を行い、文脈の手がかりだけで見知らぬソフトウェアの操作規則を解き明かせるかをテストする計画です。もしその道が開かれれば、世界モデルは「画面録画の暗記」から真の「ソフトウェア論理の理解」へと歩みを進めることになるでしょう。
参考リンク:
- SimEdw Blog: WorldTUI: A Terminal World Model
- Hacker News: WorldTUIに関する技術ディスカッション