Abres una aplicación web de 208 MB en el navegador, escribes vim test.txt y la pantalla pasa al instante a la interfaz habitual del editor. Divides paneles con tmux o abres una partida de Snake, y el cursor responde con total fluidez. Pero en cuanto tecleas a propósito el error pythoon en la línea de comandos, surge una anomalía: el sistema no responde con un mensaje de «command not found» ni se bloquea, sino que despliega sin titubeos el intérprete interactivo de Python. Detrás de esta terminal bautizada como WorldTUI no se ejecuta ningún proceso bash ni existe un sistema de archivos montado. Cada cambio en pantalla es el resultado de la predicción en tiempo real de un modelo de lenguaje de solo 360M de parámetros.
Con 360 millones de parámetros y sin una sola línea de código subyacente, WorldTUI sostiene un entorno de terminal autoconsistente y recuerda cerca del 70% del contenido de los archivos entre sesiones. Sin embargo, dado que el modelo solo predice cambios de caracteres en pantalla sin comprender las reglas reales del sistema, basta con combinar comandos conocidos de forma novedosa para que la ilusión se desmorone.
360M de parámetros en el navegador sin una sola línea de código real
La base de WorldTUI es el modelo de código abierto Qwen2.5-Coder-0.5B de Alibaba, podado y ajustado hasta los 360M de parámetros para ejecutarse localmente mediante WebGPU en Chrome o Edge de escritorio. El autor describe su utilidad con total franqueza: «¿Es útil? La verdad es que no». La verdadera hipótesis que buscaba poner a prueba proviene de Genie 3 de DeepMind: si el software del futuro deja de escribirse línea a línea por ingenieros y pasa a ser predicho fotograma a fotograma por una red neuronal a partir de las entradas del usuario, ¿puede un modelo tan diminuto sostener un mundo coherente y dotado de estado?
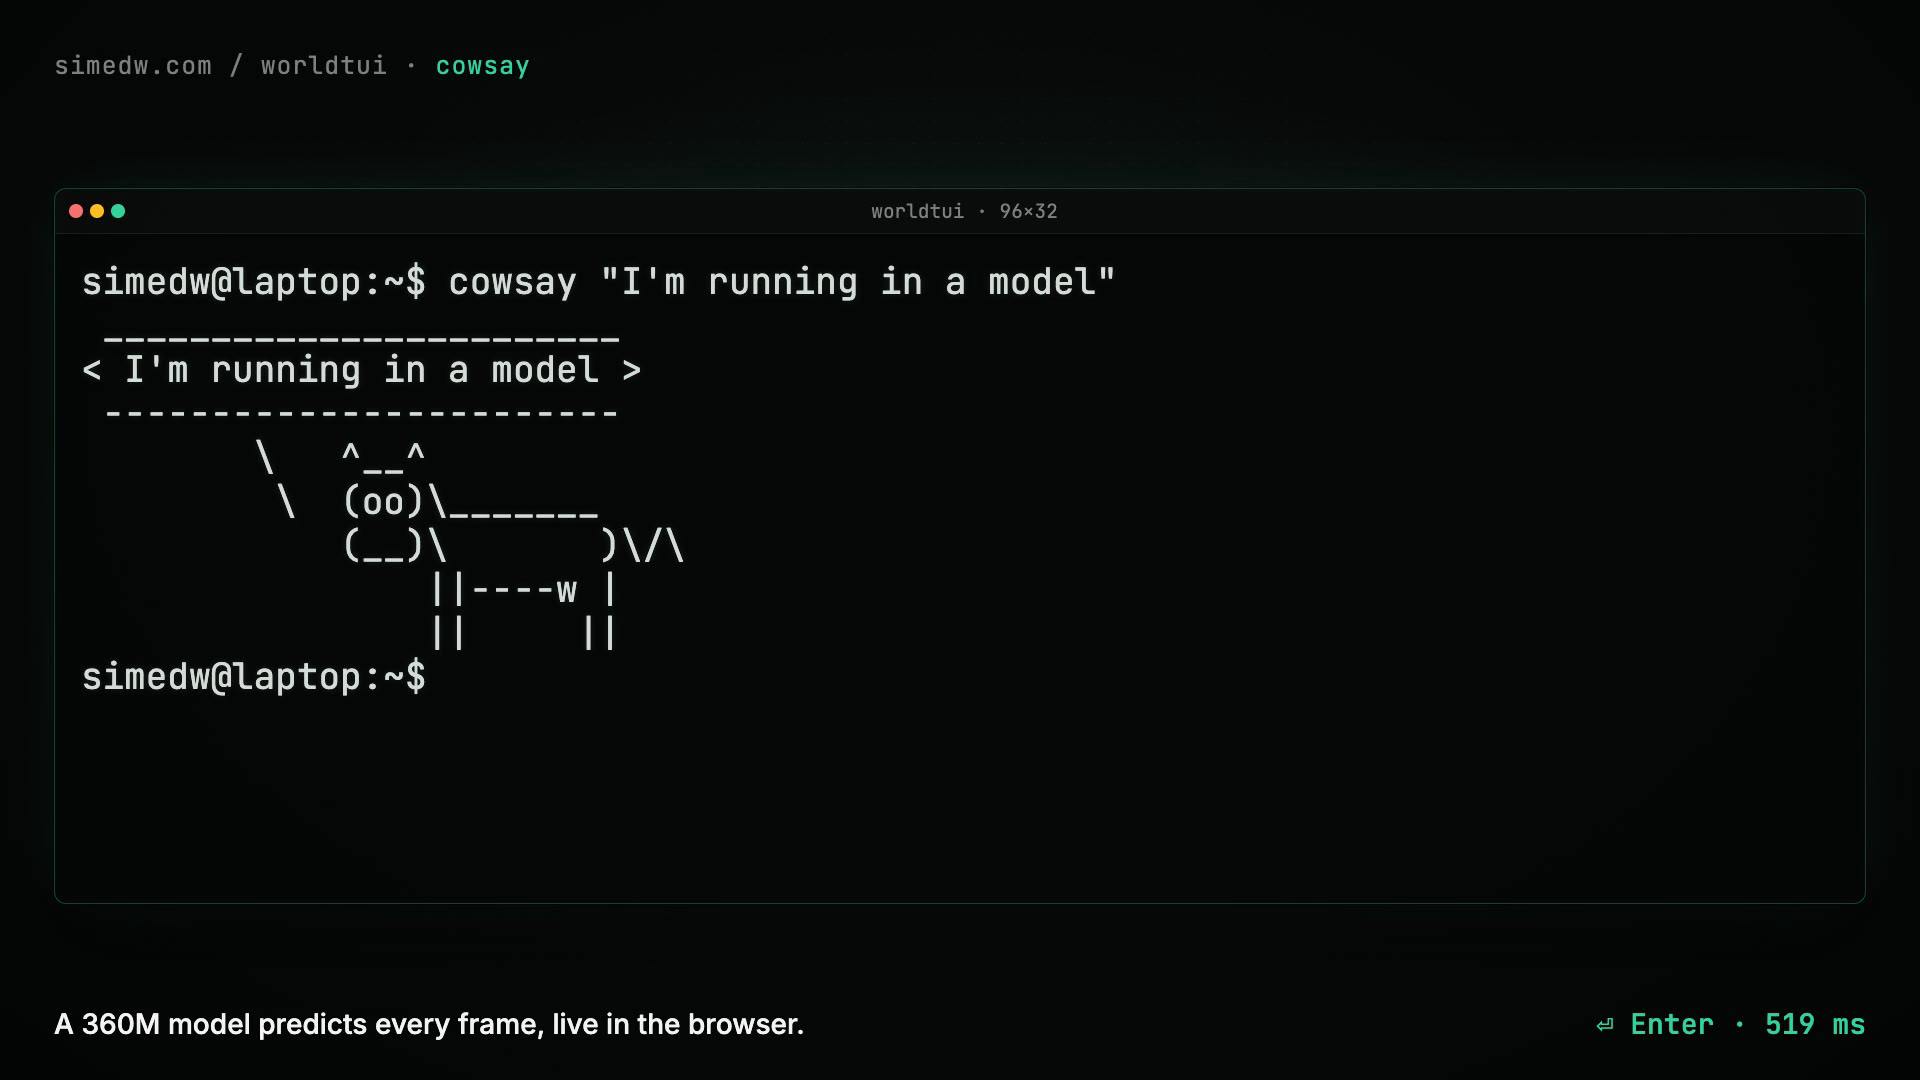 Figura: Salida de cowsay y navegación de directorios predichas por WorldTUI en el navegador. En la parte superior se aprecian las dimensiones ajustables de la cuadrícula. Fuente: SimEdw’s Blog (captura oficial del proyecto)
Ya en 2022 algunos desarrolladores creaban prompts para que ChatGPT simulara ser una terminal Linux. Más adelante, GameNGen recurrió a modelos de difusión para simular Doom fotograma a fotograma, mientras que NeuralOS intentó generar interfaces gráficas de escritorio (GUI). Sin embargo, los modelos de mundo de vídeo a nivel de píxel exigen inmensos clústeres de GPUs y conjuntos de datos gigantescos, fuera del alcance de desarrolladores independientes. Trasladar el campo de pruebas desde lienzos de píxeles a cuadrículas de caracteres de texto eludió de raíz la barrera de cómputo: las shells reales generan cantidades infinitas de datos de entrenamiento perfectamente etiquetados y sin coste, y los modelos preentrenados en código ya tienen una idea intuitiva clara de lo que deben imprimir comandos como ls o cat. Al comprimir el modelo de mundo de píxeles a caracteres de terminal, basta una única GPU de consumo para validar el dilema central de la consistencia de estado.
333 tokens y una orden de copia: reduciendo el coste de scroll un 97%
Los grandes modelos de lenguaje convencionales concatenan tokens de forma secuencial al final del texto, pero ese mecanismo fracasa en una terminal. Pulsar Esc en vim no genera texto nuevo, y ejecutar clear borra la pantalla completa y devuelve el cursor a la esquina superior izquierda: la salida casi nunca se limita a la línea inferior. Por ello, el autor descartó predecir flujos de texto continuo y programó al modelo para estimar «actualizaciones delta de la cuadrícula»: al inicio de cada sesión se introduce una instantánea con las dimensiones de la pantalla (como 32×96), los caracteres actuales y la posición del cursor. A partir de ahí, cada pulsación de tecla solo predice qué líneas reescribir y dónde se detiene el cursor. Como las dimensiones forman parte de la entrada, el modelo puede retomar el control en cualquier momento intermedio, ya sea una partida de Snake a medias o un búfer de vim a medio editar.
Las pulsaciones de teclado se alimentan directamente como los bytes crudos de una terminal real: Enter es \r, Escape es 0x1b y la flecha izquierda es ESC [ D. Si el usuario no escribe nada, el sistema introduce un token WAIT con información de duración; es precisamente esa señal temporal la que permite a la serpiente de Snake avanzar por sí misma. El autor no inventó un nuevo vocabulario para coordenadas y caracteres, sino que reutilizó los tokens nativos de Qwen que cubren los 256 valores de bytes, haciendo que una coordenada de fila como 17 ocupe solo 1 token. El auténtico cuello de botella era el desplazamiento vertical: cada vez que la terminal sube una línea, todos los caracteres de la pantalla cambian de fila. Forzar al modelo a reescribir la pantalla completa exigiría generar unos 3.000 tokens por cada pulsación de Enter.
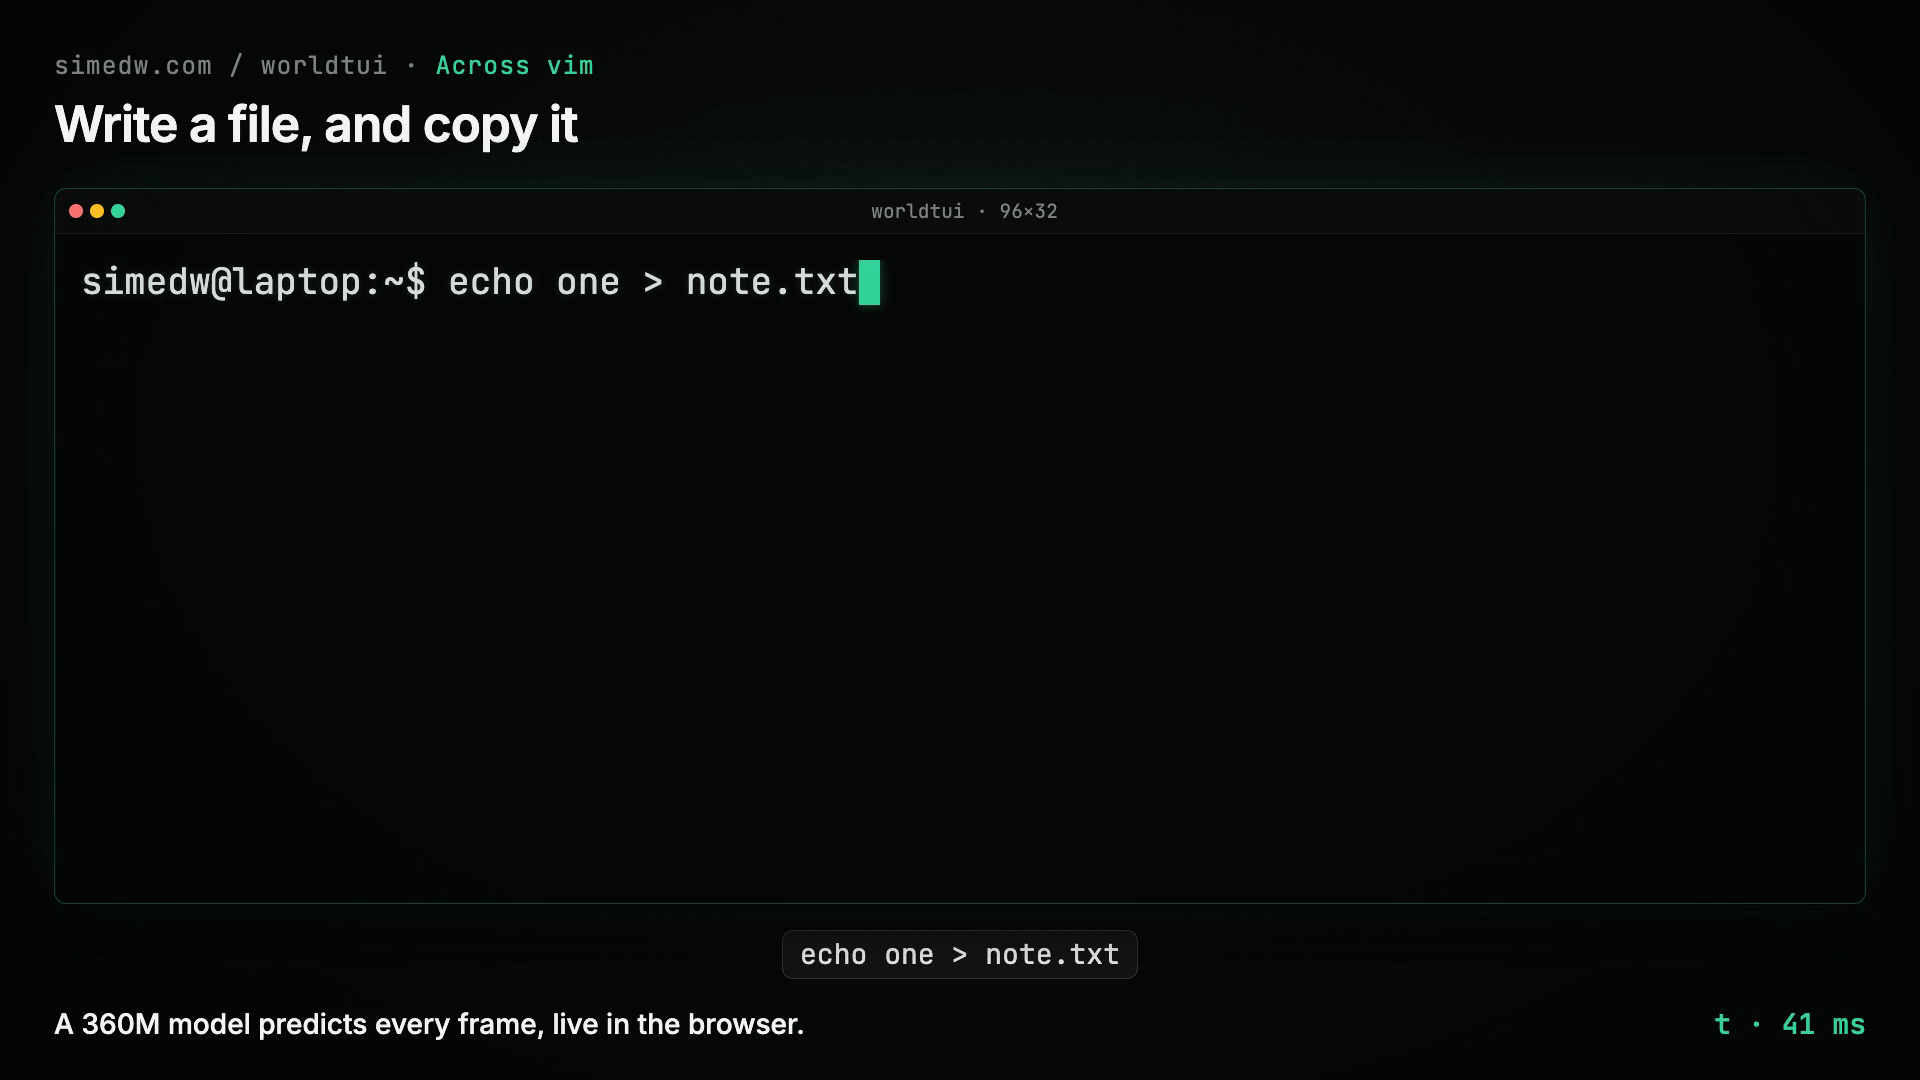 Figura: WorldTUI ejecutando una copia multilínea en vim, empleando comandos COPY a nivel de fila para evitar redibujar la pantalla entera. Fuente: SimEdw’s Blog (captura del vídeo)
Para solucionar este sumidero de cómputo, el autor incorporó primitivas de copia por filas como ROW_0 COPY 1 y ROW_1 COPY 2. Al hacer scroll, cada línea solo necesita 3 tokens para desplazarse, en lugar de los casi 96 tokens necesarios para redibujarla. Esto también resolvió las actualizaciones parciales al limpiar pantalla, insertar o borrar líneas en vim o navegar por páginas de manual man. Al final, el vocabulario activo del modelo quedó reducido a solo 333 tokens (256 tokens de bytes, 64 tokens de filas y unos pocos controles especiales). Combinado con una decodificación con restricciones gramaticales, cada predicción produce siempre una actualización de pantalla válida. Que un modelo de mundo funcione en dispositivos locales depende tanto de su tamaño como de la eficiencia con la que codifica los incrementos de estado.
75 horas de entrenamiento contra alucinaciones corrigiendo errores propios
Fijado el vocabulario, las grabaciones existentes de terminales (incluida la plataforma asciinema) resultaron inútiles por carecer de sincronización exacta entre pulsaciones de teclas y fotogramas. El autor tuvo que sintetizar los datos dentro de contenedores Docker. El flujo de generación creó perfiles simulados (desde desarrolladores hasta administradores de sistemas) con estructuras de directorios y nombres de usuario aleatorios, encadenando entre 6 y 24 actividades por sesión (editar archivos, ejecutar Python, abrir tmux). La canalización simuló cadencia de tecleo, autocompletado con Tab, un 1,2% de erratas humanas y forzó al 35% de las sesiones a comenzar a mitad de camino. Con esto se recopilaron 336.000 episodios (cerca de 2.000 millones de tokens) en formatos de 32×96, 24×80 y 40×120.
El ajuste supervisado tradicional (SFT) enseñó rápido al modelo a gestionar la escritura, el retroceso y el cursor, pero en sesiones largas colapsaba con facilidad: en cuanto el modelo cometía una errata en el nombre de un archivo, el error se propagaba en cascada por todo el contexto. Inspirándose en el algoritmo DAgger (Dataset Aggregation) de robótica, el autor diseñó una canalización de autocorrección: a partir de un punto en una sesión real, el modelo avanza sin guía de 1 a 4 pasos. Si la pantalla errónea no se desvía demasiado de la real, se construye un paso de «corrección» que, en la siguiente pulsación de tecla, devuelve la pantalla a su estado correcto.
El proceso incluía una condición indispensable: cualquier término introducido en el paso de corrección debía haber aparecido antes en pantallas reales o en el historial del usuario. Si el modelo escribía mal un nombre de archivo ya visto, entrenarlo para rectificarlo reforzaba su memoria; en cambio, si inventaba de la nada un archivo inexistente, forzarlo a corregirlo por el real habría premiado la alucinación. Alrededor de un tercio de las sesiones produjo muestras válidas de corrección. Tras tres iteraciones a lo largo de 75 horas de GPU en una sola RTX 4090, el modelo cuantizado en int4 subió su puntuación en PresetBench (una batería de 47 scripts propensos a fallos) de 24/47 a 38/47. El talón de Aquiles de los modelos de mundo autorregresivos es la acumulación de errores a largo plazo; entrenar acciones de recuperación directamente sobre la distribución de inferencia resulta mucho más eficaz que aumentar a ciegas los datos de demostración.
4 veces más retención entre sesiones que el modelo base, pero vulnerable a combinaciones nuevas
Para verificar si el modelo preservaba de verdad la consistencia del entorno, se diseñaron tres evaluaciones ajenas al conjunto de entrenamiento. La más exigente fue la prueba de memoria entre sesiones (Memory Test): en 32 entornos independientes se escribían cadenas aleatorias en dos archivos distintos, se iniciaba una nueva sesión y se leían de nuevo; superar la prueba exigía que ambos archivos coincidieran a la perfección:
| Enfoque del modelo | Parámetros | ShellBench (106 comandos) | Lectura entre sesiones (Memory Test) |
|---|---|---|---|
| WorldTUI (modelo de mundo ajustado) | 360M | 80 / 106 | 9 / 13 |
| Qwen2.5-Coder-0.5B (simulación mediante prompt) | 500M | 52 / 106 | 2 / 13 |
| Qwen3-0.6B (simulación mediante prompt) | 600M | 60 / 106 | 3 / 13 |
En la prueba de memoria entre sesiones, WorldTUI obtuvo una puntuación de 9/13, superando por 3 o 4 veces a modelos base de tamaño similar guiados por prompts. Sin embargo, el límite de la técnica quedó al descubierto en ese mismo test: el modelo es muy fiable ejecutando comandos aislados, pero en cuanto se combinan instrucciones habituales de formas no vistas, falla con rapidez. Por ejemplo, al ejecutar echo green >> colors para añadir una línea a un archivo y a continuación ejecutar cat colors, es habitual que la línea recién agregada desaparezca de la pantalla. Quienes defienden el proyecto destacan que mantener cerca del 70% del estado entre sesiones recurriendo únicamente a mecanismos de atención valida la viabilidad de las «máquinas de estado neuronales». Quienes lo critican replican que ser incapaz de generalizar una redirección tan básica evidencia que la predicción probabilística jamás podrá sustituir a un kernel determinista de sistema operativo.
Aparte de los límites de generalización, la generación autorregresiva pura estuvo a punto de arruinar la experiencia interactiva. Al generar token a token, la latencia al teclear era de unos 38 milisegundos, bastante tolerable. Pero al redibujar pantallas completas con vim, man o clear, se requerían hasta 3.000 tokens por fotograma, lo que imponía una espera de 12 segundos en una RTX 4090. El autor dio entonces con una solución clave: la mayoría de las filas de un fotograma son independientes entre sí y no necesitan generarse en serie. Al dividir cada fila en elementos de lote independientes, compartiendo la caché KV del prefijo bajo una máscara de atención personalizada, todas las filas se decodifican en paralelo, dejando solo un paso final para determinar la posición del cursor. Este ajuste redujo los pasos de decodificación de 3.000 a unos 100 (la longitud de la fila más larga), bajando la latencia p95 de 6,7 segundos a 0,87 segundos (aunque en Firefox con WebGPU sigue siendo unas 20 veces más lento que en Chrome, al parecer por diferencias en los controladores del navegador). Recordar caracteres del pasado no equivale a comprender la semántica de un sistema de archivos; la predicción puramente neuronal sin restricciones formales choca frontalmente contra la generalización compositiva.
Con un coste modesto de 75 horas de GPU, WorldTUI aporta una dosis de realismo frente al entusiasmo por la «IA como software» y acota con precisión los límites de un modelo de 360M parámetros. Gracias a una codificación compacta de 333 tokens, el entrenamiento de autocorrección con DAgger y la decodificación paralela por filas, consigue empaquetar una terminal capaz de editar archivos, dividir paneles y ejecutar Snake en los 208 MB de caché de un navegador, sin una sola línea de código shell. No obstante, esa línea que desaparece tras ejecutar echo green >> colors nos recuerda que predecir patrones visuales en pantalla dista mucho de dominar las reglas de transición de estado que operan por debajo. El autor planea ahora entrenar el modelo con miles de microaplicaciones generadas proceduralmente para comprobar si puede deducir la lógica de interacción de software desconocido solo a partir del contexto: solo entonces los modelos de mundo pasarán de memorizar grabaciones a comprender verdaderamente la lógica del software.
Enlaces de referencia:
- Blog de SimEdw: WorldTUI: A Terminal World Model
- Debate técnico sobre WorldTUI en Hacker News