在浏览器里打开一个 208 MB 的网页应用,敲下 vim test.txt,屏幕立刻切进熟悉的编辑器界面;再开 tmux 分屏,甚至启动一局贪吃蛇,光标都能丝滑响应。直到你在命令行里故意敲入拼错的 pythoon,怪事才露出来:屏幕既没有报「command not found」,也没有卡死,反而顺畅地弹出了 Python 交互式提示符。这个叫 WorldTUI 的终端背后没有 bash 进程,也没有挂载任何文件系统,所有屏幕变化全由一个 360M 参数的语言模型实时预测出来。
360M 参数的 WorldTUI 无需一行底层代码就能维持一个自洽的终端世界,跨会话记住近七成的文件内容;但模型只预测屏幕字符改动而不懂底层规则,一旦把熟悉命令做新组合,整个世界就会当场穿帮。
360M 参数装进浏览器,没跑一行真代码
WorldTUI 的底座是阿里开源的 Qwen2.5-Coder-0.5B,裁剪微调后只有 360M 参数,通过 WebGPU 直接在桌面版 Chrome 或 Edge 浏览器里做本地推理。作者给它的定位相当坦诚:「这东西有用吗?没啥用。」他真正想验证的命题来自 DeepMind 的 Genie 3——如果未来的软件不再由工程师一行行写代码实现,而是让神经网络直接根据用户输入预测下一帧画面,这么小规模的模型到底能不能撑起一个前后一致的世界。
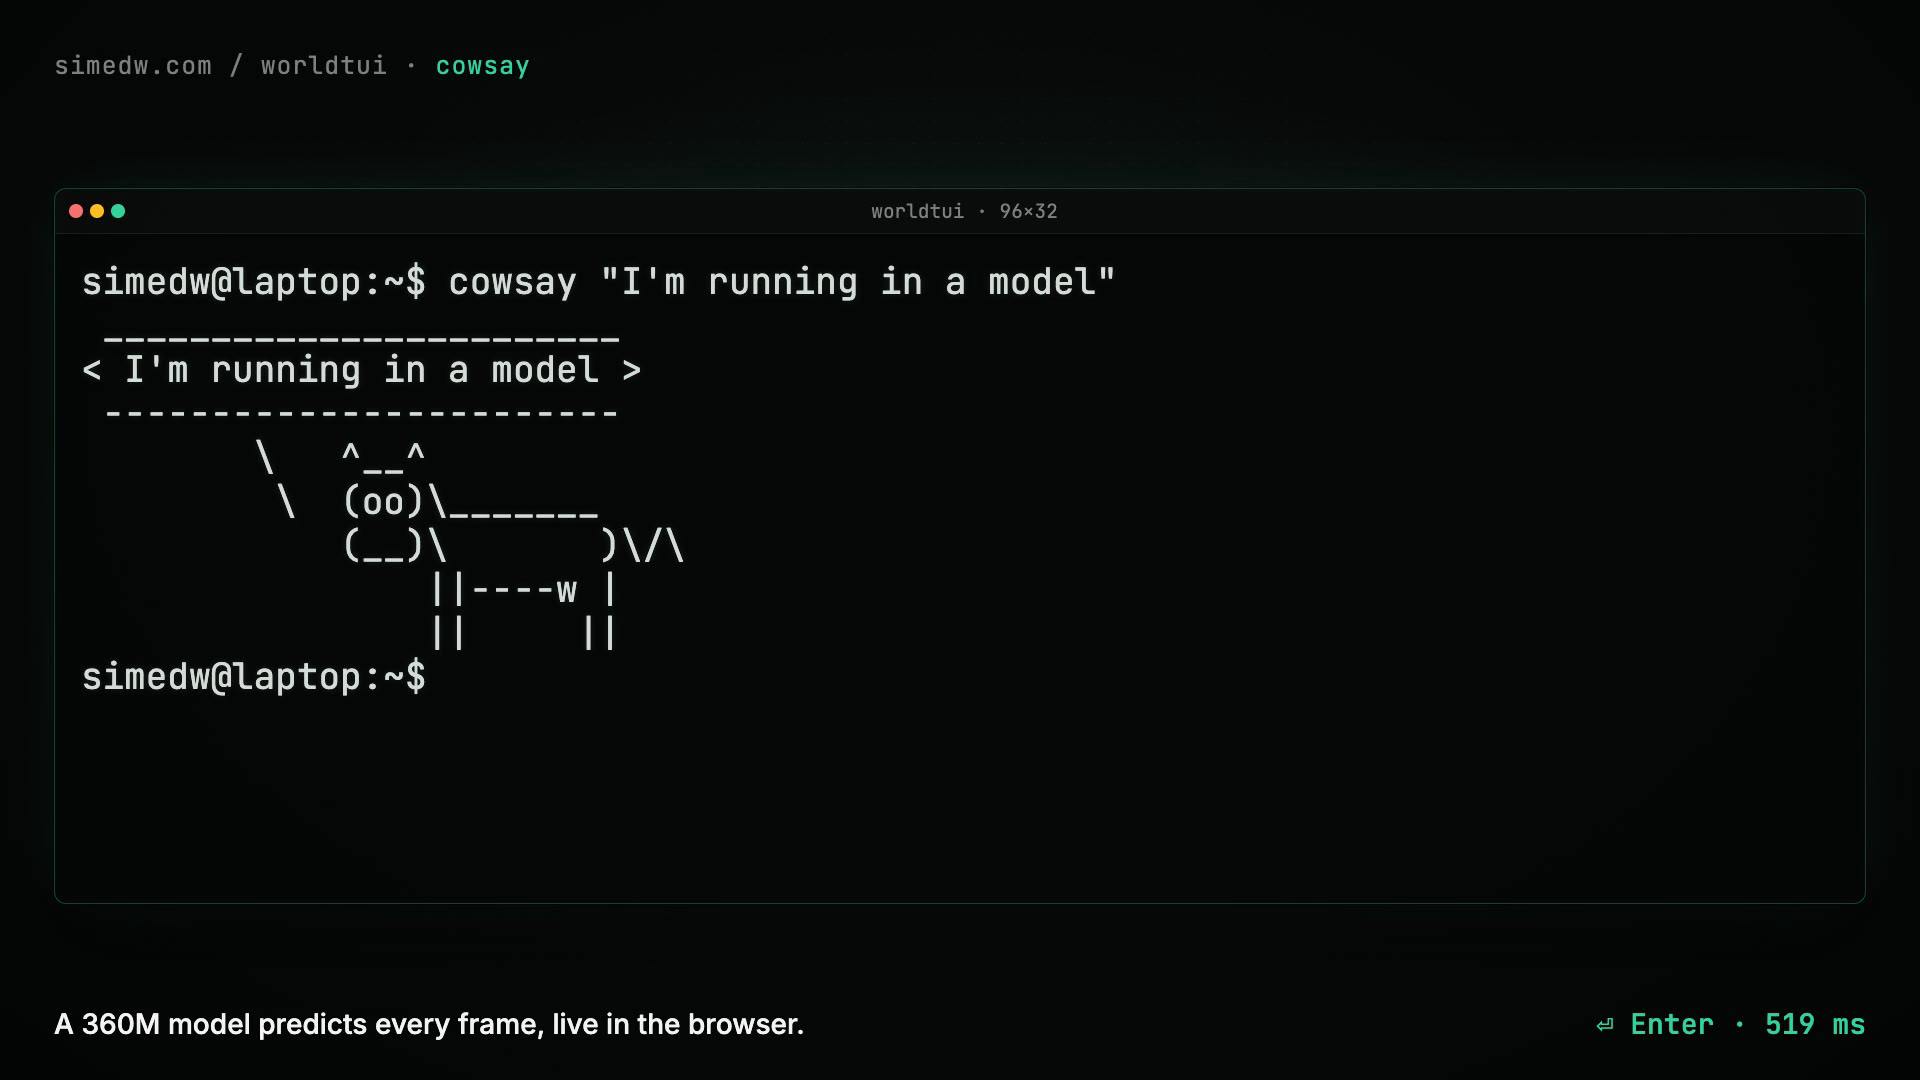 图:WorldTUI 在浏览器内预测出的 cowsay 输出与目录操作界面,注意顶部可自由调节网格行列尺寸。来源:SimEdw’s Blog(项目主页实机截图)
早在 2022 年就有开发者写提示词让 ChatGPT 扮演 Linux 终端,后来的 GameNGen 用扩散模型逐帧模拟《毁灭战士》(Doom),NeuralOS 则尝试生成桌面图形界面(GUI)。但像素级视频世界模型需要庞大的 GPU 集群和海量视频数据集,个人开发者根本玩不起。把试验场从像素画面退回到终端字符网格,恰好绕开了算力门槛:真实 shell 可以免费生成无限量、带完美标注的训练数据,而且预训练代码模型天生就对 ls 或 cat 该打印什么有概念。把世界模型从像素级收缩到字符网格后,单张消费级显卡就能验证「状态一致性」这个核心命题。
333 个 token 加一行复制指令,把滚屏开销省掉 97%
标准大语言模型只会往文本末尾一个接一个追加 token,这套机制搬到终端上立刻就会撞墙。在 vim 里按一下 esc 键不会产生新文本,执行 clear 则会清空整屏并把光标送回左上角,输出位置根本不固定在底部。作者因此放弃预测文本流,改让模型预测「屏幕网格的差量更新」:每次会话开头喂入一份包含终端尺寸(如 32×96)、当前字符内容和光标位置的快照,后续每次按键只输出「该重写哪几行、光标最后停在哪」。因为尺寸本身属于输入参数,模型随时可以从半截状态接手,给它半局贪吃蛇或打开一半的 vim 缓冲都能接着往下演。
按键输入直接采用真实终端发送的原始字节,回车是 \r,Escape 是 0x1b,左方向键是 ESC [ D;如果用户什么都没按,系统就会喂入一个带时长的 WAIT(等待)token,贪吃蛇就是靠这个时间信号自己往前爬的。作者没有为坐标和字符发明新词表,直接复用了 Qwen 原生覆盖全部 256 个字节值的 token,让 17 这样的行号坐标只占 1 个 token。真正卡脖子的是滚屏:终端每往上滚一行,整屏字符都要挪位,如果让模型把整屏重新输出一遍,敲一次回车就要吐出约 3000 个 token。
 图:WorldTUI 在 vim 界面下执行多行复制,底层通过行级 COPY 指令避免全屏重绘。来源:SimEdw’s Blog(演示视频截图)
为了填平这个算力黑洞,作者引入了 ROW_0 COPY 1、ROW_1 COPY 2 这样的行复制指令。滚屏时每行只需 3 个 token 就能完成位移,替代了原本每行约 96 个 token 的重绘开销,顺带还解决了清屏、vim 插入删除行以及翻阅 man 手册的局部刷新问题。最终整个模型的活跃词表被压缩到只有 333 个 token(256 个字节 token、64 个行 token 加少量特殊操作),配合语法约束解码,保证每次预测都是合法的屏幕更新。世界模型能不能在端侧跑通,一半取决于神经网络规模,另一半取决于状态增量的编码效率。
75 小时训出抗幻觉能力,靠让模型修正旧错
词表定型后,作者发现市面上现成的终端录屏数据集(包括 asciinema)都没有精确的按键到屏幕帧对应关系,只能自己在 Docker 容器里造数据。合成管线按开发者、系统管理员等虚构人设随机生成目录树与用户名,从改文件、写 Python 到开 tmux 挑出 6 到 24 个活动串成会话,不仅模拟了逐字敲击与 Tab 补全,还故意塞入 1.2% 的打字错字率,并让 35% 的会话从半途切入。这套管线最终攒出了 336k 个会话片段(episode),折合约 20 亿 token,涵盖 32×96、24×80 和 40×120 等多种尺寸。
只靠监督微调(SFT)很快就能教会模型处理打字、退格和光标移动,但一进长会话就会崩盘:只要模型在某一步拼错了一个文件名,这个错误就会顺着上下文一路传染下去。作者借鉴机器人控制领域的 DAgger(Dataset Aggregation,数据集聚合)算法,设计了自纠错训练管线——在真实录制会话中挑一个点让模型自己往下走 1 到 4 步,如果预测出的错误屏幕跟真实屏幕差距不算太远,就人工构造一步「修正」,在下一个按键时把错误画面强行拉回正确状态。
这里藏着一条决定成败的硬约束:修正动作里出现的任何一个词,都必须在更早的真实屏幕或用户打字历史里出现过。如果模型把之前见过的文件名拼错了,训练它改回来能增强记忆;如果模型凭空捏造了一个从没见过的文件名,强行教它改成真实文件名反而是在奖励幻觉。大约三分之一的采样会话能产出合法修正样本,作者在单张 RTX 4090 上花了 75 个 GPU 小时跑完三轮迭代,直接把 int4 量化模型在 PresetBench(47 个实测易错脚本用例)上的得分从 24/47 拉升到 38/47。自回归世界模型最怕长程误差累积,在推理分布上直接训练纠错动作,比盲目扩大演示数据规模更管用。
跨会话读回率赢过底座 4 倍,遇到命令新组合照样塌房
为了检验模型到底有没有维持住世界一致性,作者设计了三套不出现在训练集里的评测,其中最严苛的是跨会话记忆测试(memory test):在 32 个独立虚拟世界里分别往两个文件写入随机字符串,切到新会话后再读回来,两个文件全对才算通过。测试结果拉开了明显代差:
| 模型方案 | 参数量 | ShellBench(106 条命令) | 跨会话文件读回(memory test) |
|---|---|---|---|
| WorldTUI(微调终端世界模型) | 360M | 80 / 106 | 9 / 13 |
| Qwen2.5-Coder-0.5B(提示词扮演) | 500M | 52 / 106 | 2 / 13 |
| Qwen3-0.6B(提示词扮演) | 600M | 60 / 106 | 3 / 13 |
在跨会话记忆这项指标上,WorldTUI 拿到了 9/13,把同量级靠提示词扮演终端的底座模型甩开了 3 到 4 倍。但工程上的天花板也暴露在同一份成绩单里:模型处理单一套路的命令很稳,一旦把熟悉的命令用新方式组合起来就会立刻露怯。比如先执行 echo green >> colors 把字符串追加进文件,紧接着跑 cat colors,屏幕上经常看不到刚刚追加进去的那一行。支持者认为 360M 模型能靠纯注意力机制完成近七成的跨会话状态保持,已经验证了「神经状态机」的可行性;怀疑者则指出,连最基础的重定向追加都无法稳定泛化,恰恰说明概率预测永远替代不了确定性的操作系统内核。
除了泛化边界,纯自回归生成还差点毁掉交互体验。逐 token 生成时,普通打字延迟约 38 毫秒尚可接受,但遇到 vim、man 或 clear 这类全屏重绘操作,单次最多要吐 3000 个 token,在 RTX 4090 上得苦等 12 秒。作者随后看破了一个盲点:同一帧画面里绝大多数行彼此独立,根本没必要一行接一行串行生成。他把每一行拆成独立的批处理元素(batch element),共享同一份历史 KV 缓存并配合专用注意力掩码(attention mask),让所有行同时并行解码,最后单独用一步预测光标位置。这一改把全屏解码步数从 3000 步砍到最长单行的约 100 步,大帧 p95 延迟从 6.7 秒骤降到 0.87 秒(不过在 Firefox 的 WebGPU 环境下仍比 Chrome 慢约 20 倍,疑似浏览器底层实现差异所致)。记住历史字符不等于理解文件系统语义,缺少符号规则约束的纯神经预测,在组合泛化面前有一道跨不过去的硬墙。
WorldTUI 用 75 个 GPU 小时的低成本实验给整个「AI 即软件」热潮浇了一盆清醒的冷水,也探明了 360M 参数模型的能力边界。靠着 333 个 token 的紧凑状态编码、DAgger 自纠错训练和行并行解码,它确实在没有一行 shell 代码的前提下,把一个能写文件、能分屏、能贪吃蛇的虚拟终端塞进了 208 MB 的浏览器缓存里。但 echo green >> colors 之后消失的那一行输出提醒我们,预测屏幕表面的字符规律与掌握屏幕背后的状态转换规则之间,隔着一道靠堆叠相似演示跨越不了的鸿沟。作者接下来打算在几千个随机生成的微型应用上做训练,测试模型能否仅凭上下文线索摸清陌生软件的交互规则——如果那一步能走通,世界模型才算真正从「背诵屏幕录像」迈向「理解软件逻辑」。
参考链接:
- SimEdw 博客:WorldTUI 终端世界模型技术复盘
- Hacker News 社区关于 WorldTUI 的技术讨论


