Spät in der Nacht des 8. September 2026 reichte das Sicherheitsforschungsunternehmen Knostic einen Schwachstellenbericht bei Cloudflare ein. Der Bericht legte offen, dass bei Aufrufen von Modellen mit langem Kontext auf der Plattform Workers AI Nutzereingaben fremder Anwender zurückgegeben wurden – ohne dass das System irgendeinen Fehler meldete. Innerhalb von 25 Minuten nach Eingang der Meldung gelang es dem Entwicklungsteam mit zwei unabhängigen Konten, das Datenübersprechen nachzustellen. Das API-Gateway gab den regulären Statuscode HTTP 200 zurück. Der ausgegebene Text war grammatikalisch flüssig und stimmig, enthielt jedoch vertrauliche Prompt-Daten vorangegangener Anfragen anderer Mandanten.
Der Vorfall beschränkte sich strikt auf das Modell @cf/zai-org/glm-5.3. Dieses war am 27. August auf Workers AI bereitgestellt worden und die einzige betroffene Instanz auf der Plattform. GLM-5.3 selbst ist lediglich ein Satz quelloffener Modellgewichte. Die eigentliche Ursache lag im Zusammenspiel zwischen der Container-Ressourcenzuteilung des Cloud-Anbieters und einem Zustandsmaschinen-Defekt in der zugrundeliegenden Inferenz-Engine SGLang. Die physische Isolationsgrenze bei mandantenfähiger LLM-Inferenz verläuft über die GPU-Speicherseiten (VRAM). Die Gateway-Schicht kann diese Grenze prinzipbedingt nicht absichern. Sobald eine Inferenz-Engine einen Abbruch auf der einen Seite ihrer Zustandsmaschine vermerkt, der Scheduler aber von der anderen Seite liest, kollabiert die Mandantentrennung lautlos.
 Abbildung: Von Cloudflare veröffentlichter Vorfallbericht und Behebungs-Meilensteine. Das Unternehmen bestätigte, dass die Auswirkungen strikt auf ein einzelnes Modell mit langem Kontext beschränkt waren und durch Konfigurationsdiskrepanzen in einer disaggregierten Architektur ausgelöst wurden. Quelle: Cloudflare (blog.cloudflare.com).
Fehlabstimmung im Speicherpool und ein unvollständiges Scheduler-Flag
In der Produktivumgebung bestand eine erhebliche Kapazitätsdiskrepanz. Der Endpunkt war extern mit Unterstützung für ein Kontextfenster von 1.048.576 Token deklariert. Der auf den Prefill-Knoten zugewiesene KV-Cache-Pool konnte physisch jedoch lediglich 681.280 Token fassen. Die tatsächlich bereitgestellte Kapazität lag damit fast ein Drittel unter der externen Spezifikation. Während extrem lange Kontextfenster im Cloud-Geschäft als zentrales Verkaufsargument gelten, bleibt die physische VRAM-Zuteilung strikt an die Hardware-Budgets der Host-Systeme gebunden.
Die Größe des KV-Cache-Pools ist kein fester Konfigurationswert. SGLang berechnet die Poolgröße beim Start dynamisch auf Basis des verfügbaren VRAMs. Die Plattform-Infrastruktur prüfte jedoch nicht, ob dieser dynamisch ermittelte Wert mit dem deklarierten Kontextfenster übereinstimmte. Da beide Parameter über voneinander getrennte Betriebsabläufe gepflegt wurden, entstand unbemerkt eine Kapazitätsinversion. Die unvalidierte statische Angabe legte damit den Grundstein für fehlerhafte Grenzbehandlungen.
Überschritt eine Benutzereingabe den Schwellenwert von 681.280 Token, stellte der Prefill-Scheduler unzureichenden Speicher fest und leitete die Ablehnungslogik ein. Der Scheduler rief die interne Methode Req.set_finish_with_abort auf. Diese Routine ersetzte die übergroße Eingabe durch einen Platzhalter von lediglich 1 Token – ein Mechanismus, der eigentlich dazu diente, Ressourcen kontrolliert freizugeben, ohne den Worker-Prozess zum Absturz zu bringen.
Genau an dieser Schnittstelle geriet die Zustandsmaschine von SGLang aus dem Takt. Die Abbruchmarkierung wurde zwar im internen Wörterbuch to_finish hinterlegt, die zentrale Zustandsmethode finished_reason wurde jedoch nicht synchronisiert. Folglich lieferte der interne Methodenaufruf req.finished() weiterhin False zurück. Eine Anfrage, die das System längst verworfen hatte, behielt bei internen Abfragen ihren aktiven Status.
8 Seiten reserviert, nur 1 geschrieben: Ungereinigter Speicher wandert in Attention
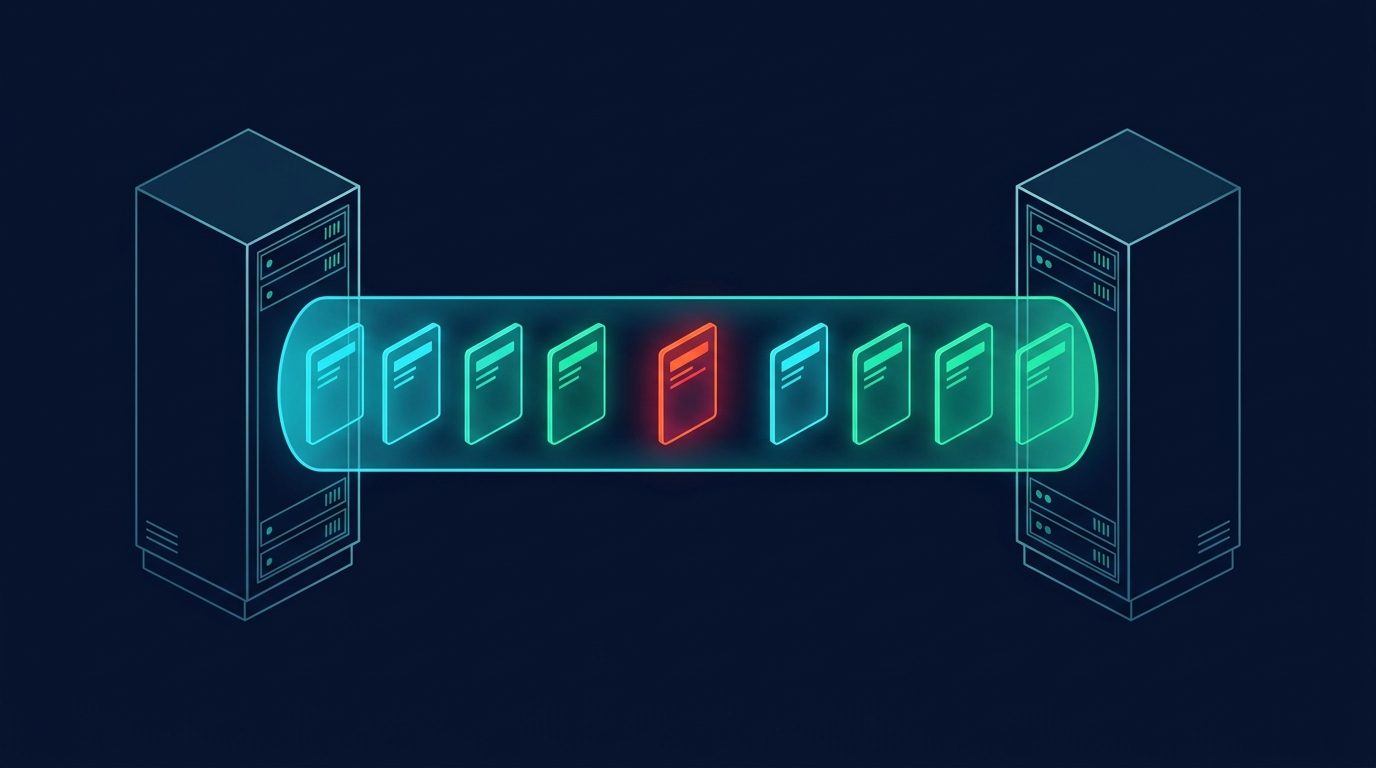
In einem klassischen, monolithischen Single-Host-Inferenzsystem hätte diese Statusdiskrepanz zu keinem Datenleck geführt. Die lokale Scheduler-Schleife hätte den Abbruch nachfolgend abgefangen und die Fehlermeldung direkt an den Client übermittelt. In den Produktionsclustern von Workers AI kam jedoch eine disaggregierte Architektur (Disaggregated Prefill and Decode) zum Einsatz. Prefill- und Decode-Knoten waren entkoppelt, und der KV-Cache wurde über RDMA-Netzwerke mithilfe des Mooncake-Frameworks übertragen.
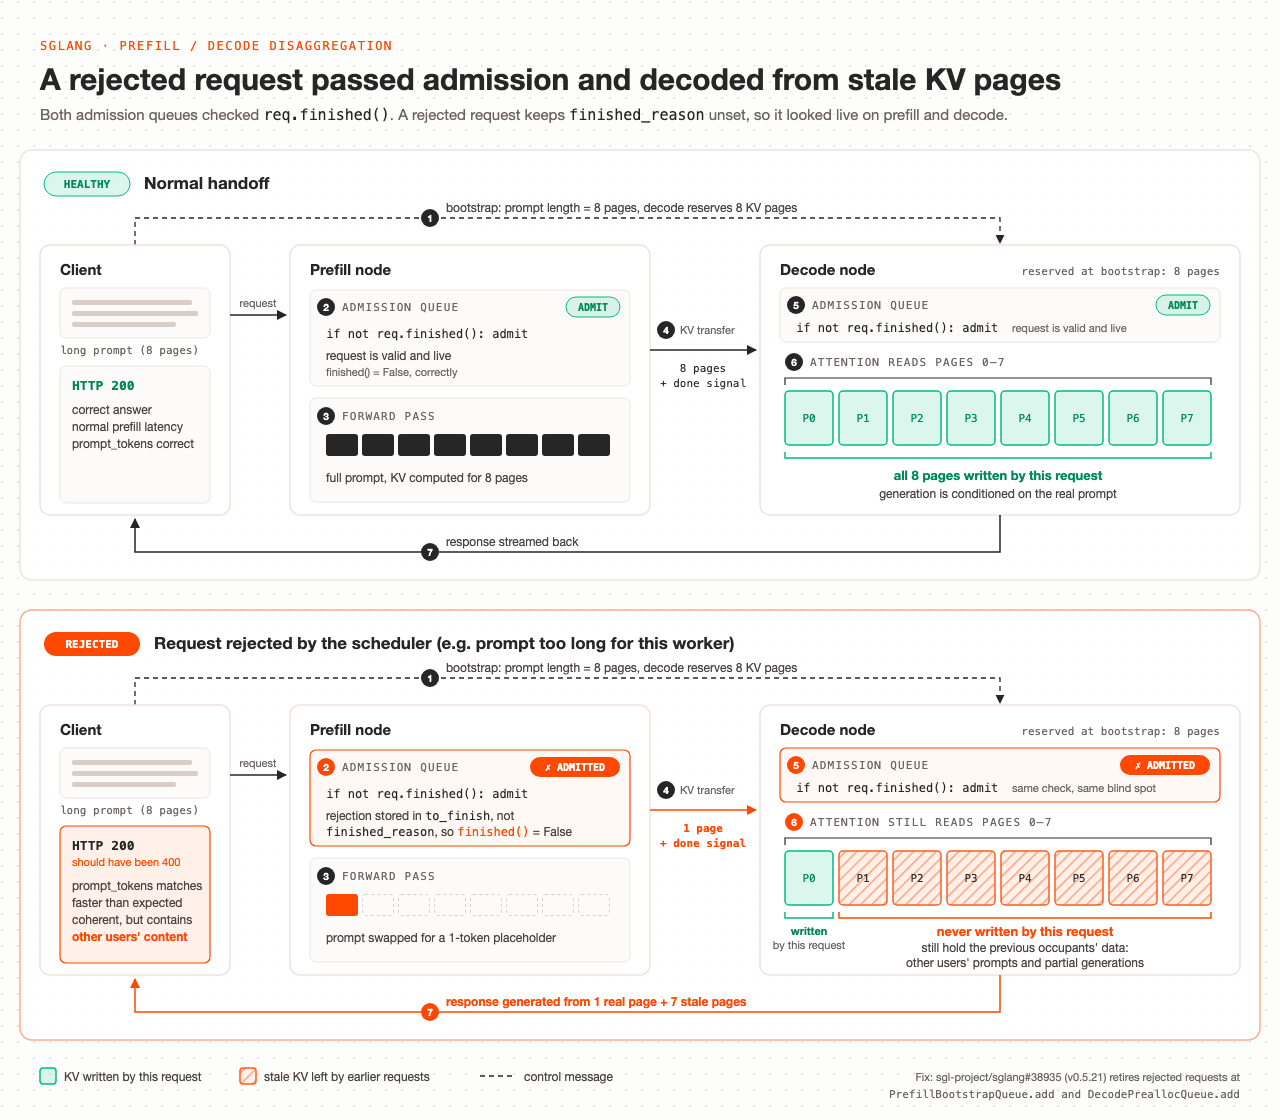 Abbildung: Pfad des Speicherlecks in der disaggregierten Inferenzarchitektur. Nach dem Abbruch einer überlangen Anfrage in der Prefill-Phase unterblieb die Weitergabe des Abbruchstatus. Der Decode-Knoten band ungereinigte historische Speicherseiten in die Attention-Berechnung ein, was zum Datenabfluss führte. Quelle: Cloudflare (blog.cloudflare.com).
Um einen hohen Durchsatz bei massiver Parallelität zu gewährleisten, werden physische GPU-Speicherseiten bei der Zuweisung an eine neue Anfrage nicht mit Nullen überschrieben. Ein vollständiges Bereinigen jeder Seite würde die Schreibbandbreite drastisch reduzieren und die Latenz inakzeptabel erhöhen. Das System vertraut stattdessen darauf, dass der Scheduler den Lebenszyklus der physischen Seiten über Metadaten korrekt steuert. Die Mandantensicherheit hing somit vollständig an der Integrität dieser Metadaten-Flags.
Bei der knotenübergreifenden Übergabe prüfte die Zulassungswarteschlange die Methode finished() anstelle des internen Abbruch-Dictionarys. Die Anfrage wurde irrtümlich als regulärer Auftrag eingestuft und vom Scheduler freigegeben. Der Prefill-Knoten wies dem 1-Token-Platzhalter eine einzelne physische Seite zu, schrieb die Daten und meldete dem Decode-Knoten den Abschluss der Übertragung.
Auf Empfängerseite fehlte ein entscheidender Abgleich. Der Decode-Knoten hatte auf Basis der gigantischen Originallänge der Anfrage vorab 8 physische Seiten reserviert, erhielt jedoch nur 1 neu beschriebene Seite. Das Rechenmodul leitete daraufhin sämtliche 8 reservierten Seiten ungeprüft an den Attention-Kernel weiter. Die verbleibenden 7 Seiten enthielten noch die unveränderten Restdaten des vorangegangenen Nutzers. Diese ungelöschten Speicherinhalte flossen unmittelbar in die nachfolgenden Matrixmultiplikationen ein.
155 Antworten mit HTTP 200: Grüne Dashboards verdecken den Durchgriff
Der Speicherübergriff vollzog sich in der Produktivumgebung vollkommen geräuschlos. Eine nachträgliche Auswertung sämtlicher Protokolldaten ergab, dass insgesamt 155 Antworten fremde Kontextdaten an Nutzer auslieferten. Sämtliche betroffenen Anfragen wiesen Eingabelängen auf, die den Schwellenwert von 681.280 Token überschritten. Die fehlerhafte Grenzbehandlung machte genau diese extrem langen Prompts zu Opfern der Speicherlücke.
Ein gezielter externer Angriff konnte ausgeschlossen werden. Cloudflare bereinigte die Logs um interne Debugging-Aufrufe und die Reproduktionsversuche der Sicherheitsforscher. Dabei bestätigte sich, dass Häufigkeit und Zeitpunkte der betroffenen Aufrufe präzise den realen Nutzungsmustern regulärer Workloads mit langem Kontext entsprachen. Auslöser war gewöhnlicher Produktivverkehr, kein geplanter Exploit.
Kein Überwachungssystem schlug Alarm. Das API-Gateway registrierte durchgängig den Statuscode HTTP 200. Die Antwortzeiten lagen im normalen Rahmen, und die abgerechneten Token-Metriken entsprachen den Spezifikationen. Sämtliche Infrastruktur-Dashboards blieben grün, während sich das Datenleck hinter makellosen Metriken unbemerkt fortsetzte.
Die sprachliche Vervollständigungskompetenz des neuronalen Netzes verschleierte die Anomalie zusätzlich. Das Sprachmodell generierte auch aus den fehlerhaft zusammengesetzten Attention-Vektoren flüssige Texte, da es die semantische Herkunft seiner Eingaben nicht bewertet. Herkömmliche Fehlermeldungen und Exception-Handler griffen ins Leere – ein klassisches Beispiel für lautlose Datenlecks.
Statuscodes prüfen statt Ausgaben validieren: Sicherheitsgrenzen an die Engine ausgelagert
Ähnliche Risiken waren in der Open-Source-Community nicht gänzlich unbekannt. Bereits am 6. Juli 2026 diskutierte Issue #30233 im SGLang-Repository über Fehler bei der Behandlung abgebrochener Zustände im Prefill-Scheduler. Auch Cloudflare hatte seit dem Rollout von v0.5.10 intern vereinzelte Anomalien beobachtet, diese jedoch als vorübergehendes Netzwerkrauschen abgetan. Warnsignale gingen im alltäglichen Betriebsrauschen unter.
Cloudflare legte im Post-Mortem einen weit verbreiteten blinden Fleck der gesamten Branche offen. Die gängige Qualitätssicherung vor dem Rollout konzentriert sich typischerweise auf API-Statuscodes, Durchsatz und Lasttests mit langen Texten. Es existierten keine automatisierten Tests, um die semantische Übereinstimmung zwischen generierter Ausgabe und eingegebenem Prompt zu prüfen. Cloud-Anbieter gingen stillschweigend davon aus, dass die interne Ressourcenverwaltung zuverlässig arbeitet, solange die Inferenz-Engine keine unbehandelten Ausnahmen wirft.
Die eigentliche Sicherheitslinie der Mandantentrennung liegt jedoch in der lückenlosen Verfolgung der Speicherseiten-Eigentümerschaft. Da API-Gateways Anfragen lediglich weiterleiten und Berechtigungen prüfen, können sie nicht in die internen VRAM-Mapping-Tabellen der GPUs blicken. Fehlt Cloud-Anbietern ein unabhängiger Kontrollmechanismus für den Engine-Status, wird die Mandantentrennung faktisch an eine einzelne Codezeile des Inferenz-Frameworks ausgelagert.
Doppelte Sicherheitsmargen und obligatorischer Knotenabgleich
Das Vorfallmanagement von Cloudflare reagierte beachtlich schnell. Am 9. September um 13:22 Uhr wurde der Vorfall offiziell priorisiert und der Fehler innerhalb von 25 Minuten nachgestellt. Um 14:00 Uhr wurde das Modell offline genommen, um 14:52 Uhr wurden sämtliche Prefill-Knoten im Rolling-Restart neu gestartet, um den Speicher zu bereinigen, und um 19:40 Uhr ging der Dienst nach Einspielen eines Hotfix-Patches wieder in Betrieb. In enger Abstimmung mit dem SGLang-Kernteam wurde zwischen dem 11. und 19. September die gesamte Produktivumgebung gehärtet.
Auf Konfigurationsebene wurden stringente Sicherheitsreserven geschaffen. Cloudflare verdoppelte den Prefill-KV-Cache-Pool auf rund 2,04 Millionen Token – das Doppelte des deklarierten Kontextfensters. Dies entspricht dem bewährten Puffer, der zuvor bereits bei GLM 5.2 eingesetzt wurde. In die Deployment-Pipeline wurde ein verpflichtendes Validierungstor integriert: Vor dem Start eines Containers liest das System die physische KV-Poolgröße direkt aus der laufenden Engine aus und gleicht sie mit dem deklarierten Fenster ab, um eine Kapazitätsinversion strukturell auszuschließen.
Die Fehlerbehebungen auf Engine-Ebene wurden zügig in das Upstream-Projekt überführt. Die Betreuer von SGLang mergten die Pull Requests #38704, #36988 und #38935. Anfragen mit Abbruch-Flag werden nun direkt in der Zulassungswarteschlange verworfen; jegliche Speicherallokation oder Knotenübertragung wird strikt unterbunden. Gleichzeitig erzwingen die Decode-Knoten eine strenge Validierung, die sofort eine Exception auslöst, falls die übertragene Seitenzahl von der Reservierung abweicht. Die Patches sind in den Versionen SGLang v0.5.21 und v0.5.22 enthalten.
Die technische Analyse von Cloudflare verdeutlicht den hohen Preis, den moderne Inferenzarchitekturen für extreme Effizienz zahlen. Um Durchsatz und Speicherauslastung zu maximieren, trennt man Prefill von Decode, transferiert KV-Caches über Hochgeschwindigkeitsnetzwerke und verzichtet auf das Nullen freigegebener Speicherseiten. Diese Optimierung übertrug die Verantwortung für die Mandantensicherheit jedoch einer einzigen, unscheinbaren booleschen Prüfung. Solange sich Infrastrukturtests auf oberflächliche HTTP-Statuscodes beschränken, bleiben lautlose Datenlecks in den Tiefen des GPU-Speichers eine reale Gefahr.
Referenzen:
- Offizieller Analyse- und Behebungsbericht von Cloudflare (KV Cache Exposure Remediation)
- SGLang PR #38704: Validierung übertragener vs. reservierter Tokenmengen in disaggregierter Inferenz
- SGLang PR #38935: Frühes Abfangen abgebrochener Anfragen in der Zulassungswarteschlange
- SGLang Issue #30233: Dokumentation zur Abbruchbehandlung im Prefill-Scheduler