Tard dans la nuit du 8 septembre 2026, l’entreprise de recherche en cybersécurité Knostic a soumis un rapport de vulnérabilité à Cloudflare. Le document révélait que lors de l’appel de modèles à long contexte sur la plateforme Workers AI, le service renvoyait des entrées appartenant à d’autres utilisateurs sans générer la moindre erreur. En moins de 25 minutes après la réception du signalement, l’équipe d’ingénierie a reproduit la fuite croisée entre locataires à l’aide de deux comptes distincts. La passerelle API renvoyait un code HTTP 200 standard. Bien que le texte généré fût parfaitement fluide et cohérent sur le plan syntaxique, il intégrait des invites confidentielles issues de requêtes antérieures.
L’incident a été strictement circonscrit au modèle @cf/zai-org/glm-5.3. Mis en ligne sur Workers AI le 27 août, il s’agissait du seul déploiement hébergé affecté sur l’ensemble de la plateforme. GLM-5.3 n’est en soi qu’un ensemble de poids open source. L’origine du problème résidait dans l’allocation des ressources de conteneur par le fournisseur cloud, combinée à une anomalie au sein de la machine à états du moteur d’inférence sous-jacent, SGLang. La frontière d’isolation physique dans l’inférence mutualisée de modèles de langage repose sur les pages mémoire du GPU (VRAM). La couche passerelle ne peut protéger cette frontière : dès lors que le moteur enregistre un abandon d’un côté de sa machine à états tandis que le planificateur lit de l’autre, le mécanisme d’isolation s’effondre en silence.
 Figure : Calendrier officiel de l’incident et étapes de remédiation publiées par Cloudflare. L’entreprise a confirmé que l’impact était strictement limité à un déploiement de modèle à long contexte, provoqué par un décalage de configuration dans une architecture désagrégée. Source : Cloudflare (blog.cloudflare.com).
Inadéquation du pool mémoire et anomalie d’état du planificateur
Le déploiement en production présentait une discordance critique de capacité. Le service annonçait une fenêtre de contexte de 1 048 576 tokens, mais le pool de KV cache alloué aux nœuds de prefill ne pouvait en accueillir physiquement que 681 280. L’allocation réelle était inférieure de près d’un tiers à la spécification affichée. Alors que les contextes ultra-longs constituent un argument marketing majeur, l’allocation effective de mémoire VRAM reste tributaire du budget matériel de chaque machine.
La taille du pool de KV cache n’est pas un paramètre de configuration figé. Au démarrage, SGLang calcule dynamiquement la taille du pool en fonction de la VRAM disponible. La plateforme n’imposait aucun contrôle pour vérifier la concordance entre cette valeur dynamique et la fenêtre de contexte annoncée. Ces deux paramètres étant gérés par des flux opérationnels distincts, une inversion de capacité s’est discrètement installée. Cette limite statique non vérifiée a pavé la voie à un traitement anormal des requêtes hors limites.
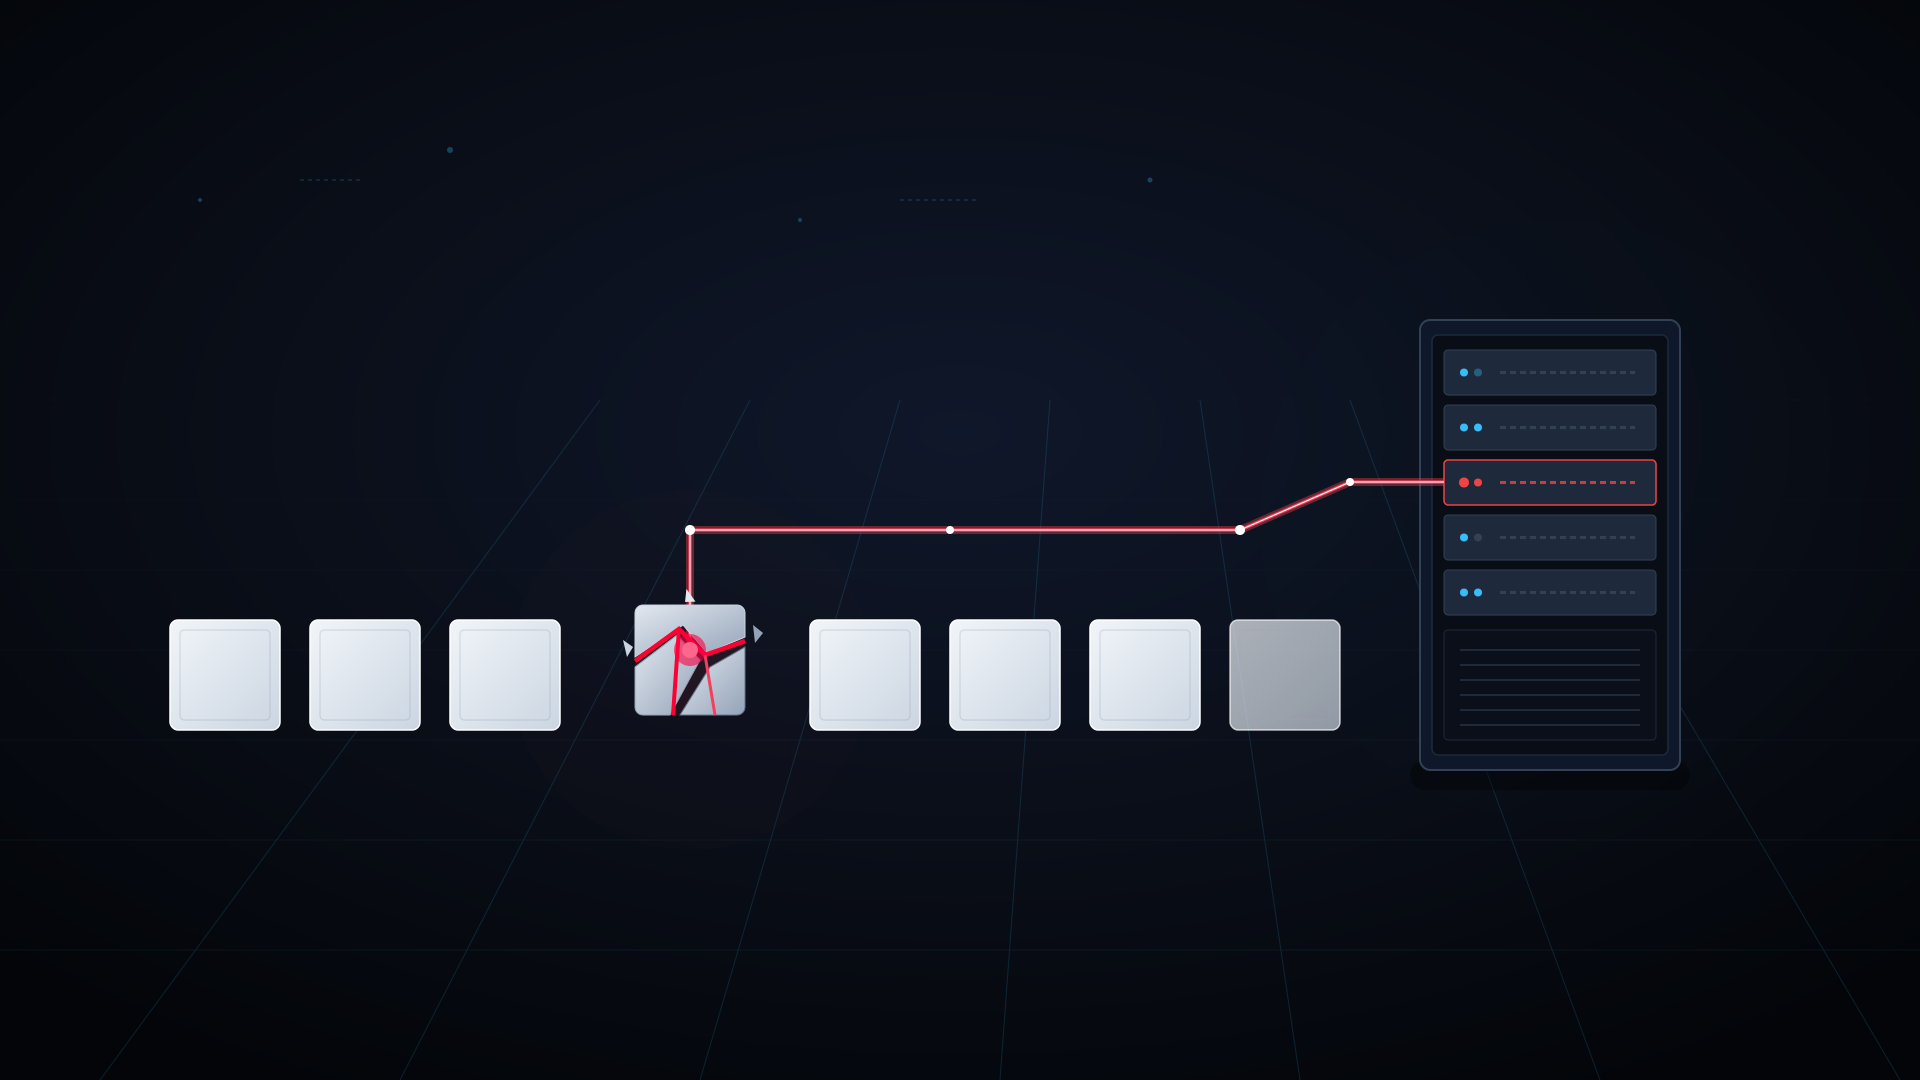
Lorsqu’une invite dépassait 681 280 tokens, le planificateur de prefill détectait un manque de mémoire et déclenchait une logique de rejet. Il invoquait la méthode interne Req.set_finish_with_abort, qui remplaçait la volumineuse requête par un simple token de substitution. Ce mécanisme avait été conçu pour libérer proprement les ressources sans faire planter le processus de travail.
C’est précisément là que la machine à états de SGLang a divergé. Le marqueur d’abandon a été consigné dans le dictionnaire interne to_finish, mais la méthode d’état centrale finished_reason n’a pas été synchronisée. Par conséquent, l’appel interne req.finished() continuait de renvoyer False. Une requête que le système avait décidé d’annuler conservait un statut actif lors des requêtes d’état ultérieures.
Huit pages réservées, une seule écrite : la mémoire résiduelle entre dans l’Attention
Dans une architecture monolithique sur une seule machine, cette incohérence d’état n’aurait entraîné aucune fuite. La boucle de planification locale aurait intercepté l’interruption et renvoyé immédiatement un code d’abandon au client. Cependant, les clusters de production de Workers AI exploitaient une architecture d’inférence désagrégée (Disaggregated Prefill and Decode). Les nœuds de prefill et de decode y étaient découplés, et le KV cache était transféré à haut débit sur un réseau RDMA via le framework Mooncake.
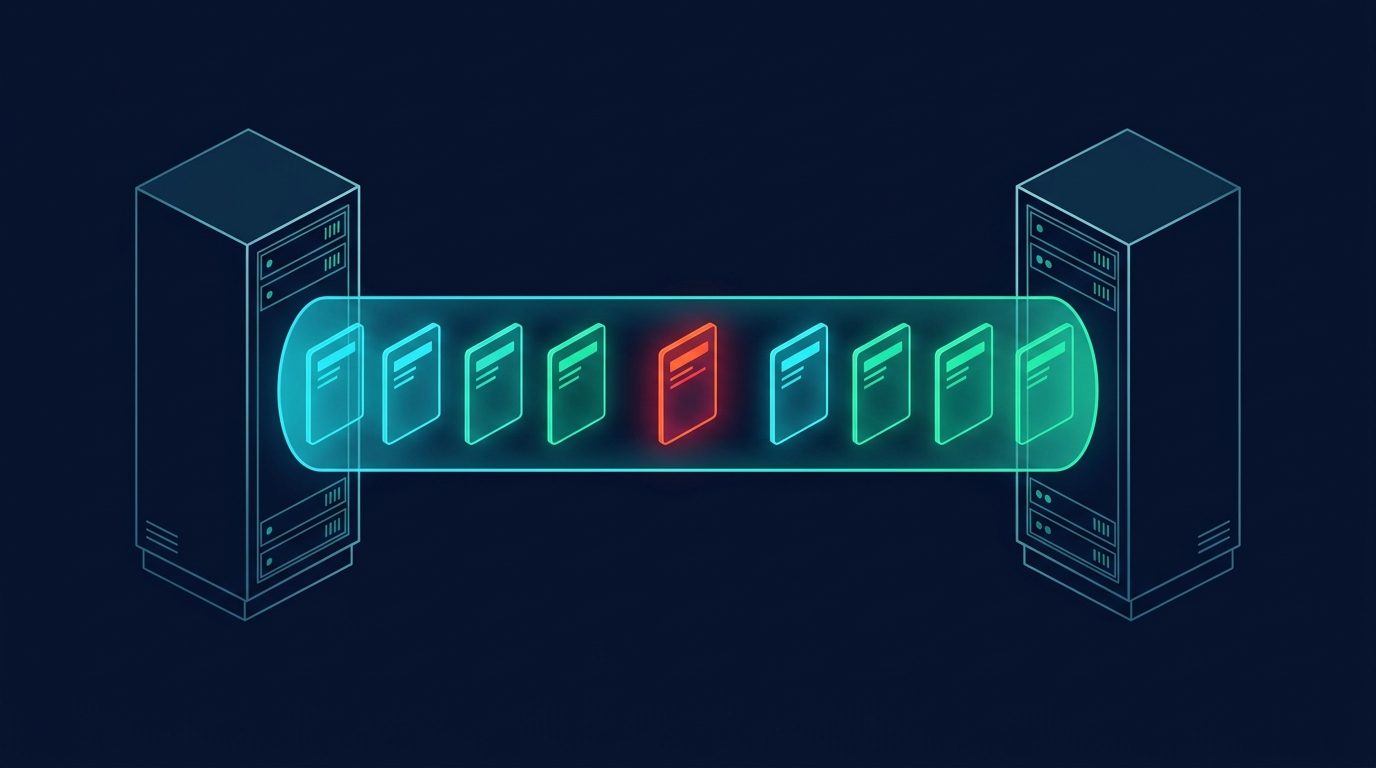
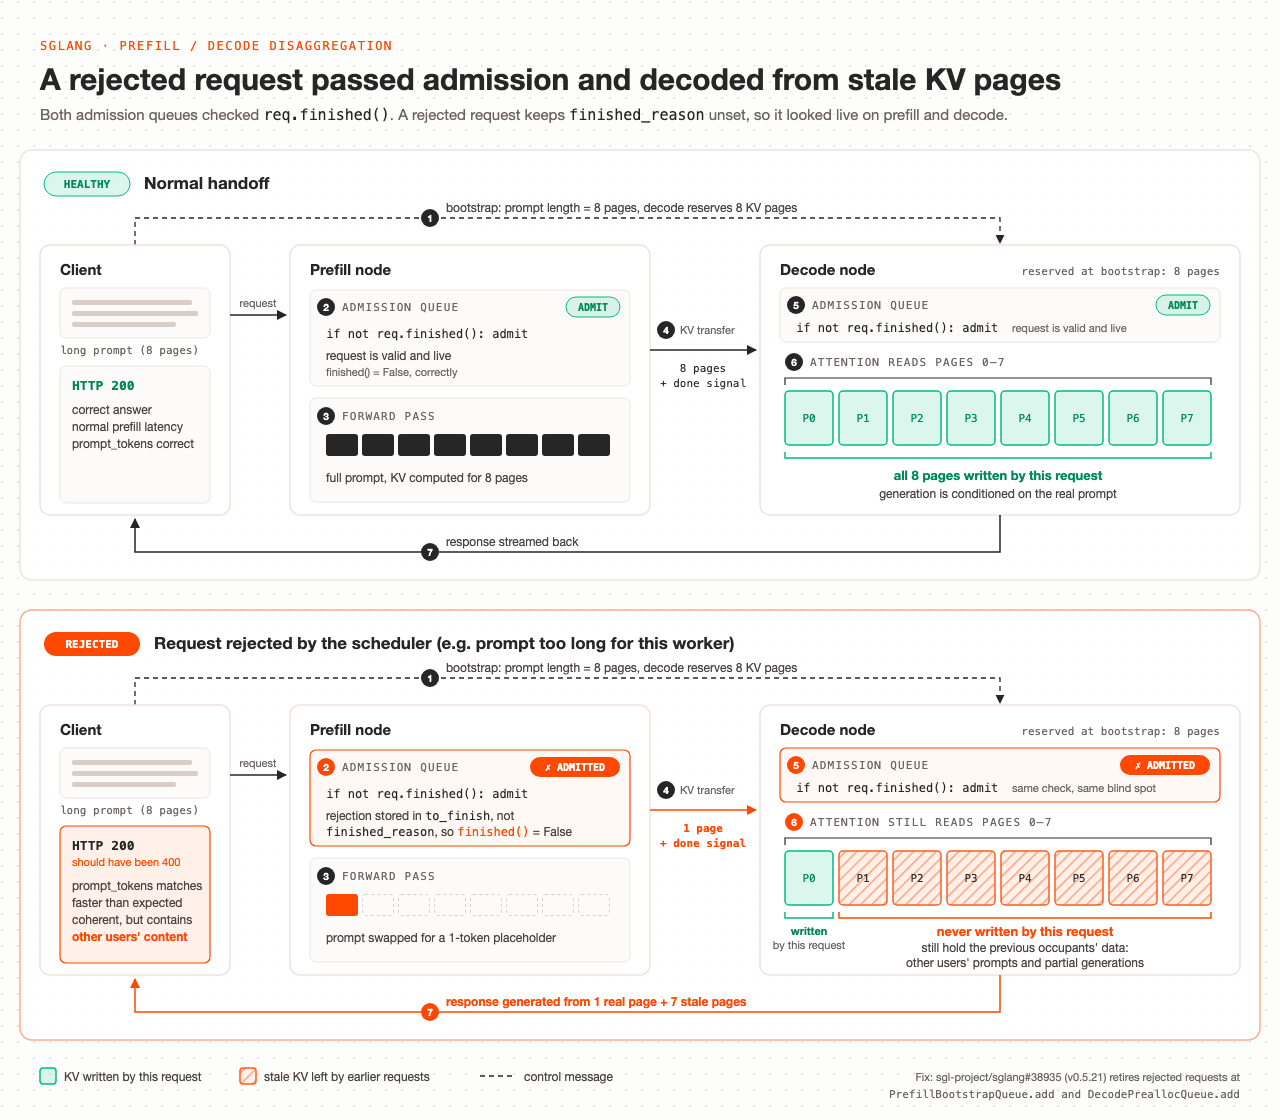 Figure : Schéma de la fuite mémoire dans l’architecture d’inférence désagrégée. Après l’abandon d’une requête surdimensionnée lors du prefill, l’indicateur d’état n’a pas été transmis. Le nœud de decode a intégré des pages mémoire historiques non effacées dans le calcul d’attention, entraînant une fuite de données. Source : Cloudflare (blog.cloudflare.com).
Pour préserver un débit massif, les pages physiques de mémoire GPU ne sont pas remises à zéro lors de leur réallocation. Effacer chaque page dégraderait lourdement la bande passante d’écriture et la latence des requêtes. Le système s’en remet entièrement aux métadonnées du planificateur pour gérer le cycle de vie des pages. La sécurité multi-locataire repose donc intégralement sur l’exactitude de ces indicateurs.
Lors de la transmission entre nœuds, la file d’admission a interrogé la méthode finished() au lieu du dictionnaire d’abandon. Le planificateur a ainsi considéré la requête comme valide et l’a autorisée à poursuivre. Le nœud de prefill a alloué une unique page physique pour le token de substitution, a écrit la donnée, puis a notifié le nœud de decode de la fin du transfert.
Le nœud récepteur manquait d’un contrôle de réconciliation fondamental. Sur la base de la taille initiale annoncée, le nœud de decode avait réservé 8 pages physiques, mais n’en a reçu qu’une seule nouvellement écrite. Le module de calcul a alors injecté l’intégralité des 8 pages réservées dans l’opérateur d’Attention. Les 7 pages restantes contenaient encore les données non écrasées du locataire précédent. Ce contenu résiduel de la VRAM s’est retrouvé directement incorporé dans les multiplications matricielles subséquentes.
155 réponses avec code HTTP 200 : les métriques au vert masquent la fuite
Cette fuite de mémoire s’est opérée dans un silence absolu en production. L’audit rétrospectif des journaux a révélé que 155 réponses avaient restitué des données contenant le contexte d’autres utilisateurs. Toutes les requêtes affectées dépassaient strictement le seuil critique de 681 280 tokens. La rupture dans la gestion des requêtes volumineuses a transformé ces entrées en victimes de la faille de mémoire sous-jacente.
L’hypothèse d’une attaque externe ciblée a été écartée. Cloudflare a filtré ses propres journaux d’investigation ainsi que les requêtes de reproduction des chercheurs en sécurité, confirmant que la chronologie et le volume des appels correspondaient aux habitudes d’utilisation normales des contextes longs. L’incident a été provoqué par un trafic de production légitime, et non par une tentative de piratage.
Les sondes de surveillance réparties sur la chaîne n’ont déclenché aucune alerte. La passerelle API a enregistré des codes HTTP 200 continus. Les temps de réponse s’inscrivaient dans les plages attendues et le décompte des tokens correspondait aux spécifications de facturation. Tous les voyants d’infrastructure sont restés au vert, dissimulant la fuite derrière des indicateurs impeccables.
La capacité d’extrapolation des réseaux de neurones a encore atténué l’anomalie. En traitant les vecteurs d’Attention composites, les modèles de langage ont continué de générer des textes parfaitement cohérents. Le modèle lui-même ne valide pas l’appartenance sémantique de ses données. Les mécanismes traditionnels de journalisation des erreurs et de capture d’exceptions ont été contournés, provoquant une fuite de données totalement silencieuse.
Valider les codes de statut sans auditer les sorties : la sécurité sous-traitée au moteur
Ce type de signal d’alarme n’était pas inédit au sein de la communauté open source. Dès le 6 juillet 2026, l’issue #30233 du projet SGLang documentait des anomalies dans le traitement des requêtes abandonnées par le planificateur de prefill. Cloudflare avait également constaté des symptômes sporadiques depuis le déploiement de la version 0.5.10, mais ces événements isolés avaient été interprétés comme des instabilités réseau passagères. Les signes précurseurs avaient été noyés dans le bruit de fond opérationnel.
Dans son retour d’expérience, Cloudflare a mis en lumière un angle mort partagé par l’ensemble de l’industrie. Les démarches classiques d’assurance qualité avant mise en production se focalisent sur les codes de statut API, le débit global et les tests de charge en contexte long. Aucun pipeline automatisé ne vérifiait la cohérence sémantique entre les sorties générées et les requêtes en entrée. Les fournisseurs cloud partaient du principe que tant que le moteur d’inférence ne levait pas d’exception, sa gestion interne d’état était fiable.
La ligne rouge de l’isolation multi-locataire réside dans le suivi de la propriété des pages mémoire GPU. Puisque la passerelle API ne fait qu’acheminer le trafic et gérer les droits et la facturation, elle ne peut examiner les tables internes d’allocation de la VRAM. En l’absence de vérification indépendante de l’état du moteur, la frontière d’isolation se retrouve concrètement déléguée à une seule ligne de code du framework d’inférence.
Marge doublée et réconciliation obligatoire entre nœuds
La gestion de l’incident s’est distinguée par sa réactivité. Le 9 septembre à 13h22, le dossier a été formellement ouvert et la panne reproduite en 25 minutes. Le modèle a été désactivé à 14h00, tous les nœuds de prefill ont été redémarrés de manière séquentielle à 14h52 pour purger la VRAM, et le service a été rétabli à 19h40 après l’application d’un correctif. En collaboration étroite avec l’équipe de SGLang, le durcissement complet des clusters de production a été finalisé entre le 11 et le 19 septembre.
Côté configuration, une marge de sécurité robuste a été instaurée. Cloudflare a porté la capacité du pool de KV cache en prefill à environ 2,04 millions de tokens, soit le double de la fenêtre annoncée, s’alignant sur le dimensionnement éprouvé de GLM 5.2. La chaîne de déploiement a intégré un contrôle bloquant : avant le démarrage de tout conteneur, le système lit directement la taille physique du pool KV dans le moteur en cours d’exécution et la compare à la fenêtre déclarée, excluant toute inversion de capacité.
Au niveau du moteur, les correctifs ont été rapidement intégrés dans le code source de SGLang via les pull requests #38704, #36988 et #38935. Les requêtes marquées pour abandon sont désormais bloquées dès la file d’admission, interdisant toute allocation mémoire ou transfert entre nœuds. Parallèlement, les nœuds de decode effectuent une vérification stricte, déclenchant une exception si le nombre de pages reçues ne correspond pas aux réservations. Ces correctifs sont officiellement intégrés dans SGLang v0.5.21 et v0.5.22.
L’autopsie technique de Cloudflare illustre le coût en ingénierie qu’exige l’évolution vers l’inférence désagrégée. Pour maximiser le débit et l’utilisation de la mémoire, les architectures actuelles séparent prefill et decode, font transiter le KV cache sur des réseaux ultra-rapides et réutilisent des pages mémoire non purgées. Mais cette optimisation a fait reposer l’édifice de l’isolation multi-locataire sur une unique vérification d’état booléenne. Tant que les tests d’infrastructure se limiteront à la surface des codes HTTP, le risque de fuite silencieuse au cœur de la mémoire GPU demeurera entier.
Liens de référence :
- Rapport d’incident et de remédiation officiel de Cloudflare (KV Cache Exposure Remediation)
- SGLang PR #38704 : Vérification de cohérence entre le volume de tokens transmis et réservés dans l’inférence désagrégée
- SGLang PR #38935 : Interception précoce des requêtes interrompues dans la file d’admission
- SGLang Issue #30233 : Suivi du traitement des abandons dans le planificateur de prefill