2026년 9월 8일 늦은 밤, 보안 연구 기관 Knostic이 클라우드플레어에 취약점 리포트를 전달했다. Workers AI 플랫폼에서 긴 문맥 모델을 호출할 때 아무런 오류 없이 다른 사용자의 프롬프트 입력 데이터가 결과에 섞여 반환된다는 내용이었다. 제보 접수 25분 만에 엔지니어링 팀은 두 개의 독립 계정을 사용해 테넌트 간 데이터 혼선을 재현하는 데 성공했다. API 게이트웨이는 정상적인 HTTP 200 상태 코드를 반환했다. 생성된 문장은 문법적으로 매우 자연스러웠으나, 직전 다른 요청의 비공개 프롬프트 데이터가 그대로 노출되어 있었다.
영향을 받은 서비스는 @cf/zai-org/glm-5.3 모델로 한정되었다. 8월 27일 Workers AI에 배포된 모델로, 해당 플랫폼에서 영향을 받은 유일한 호스팅 인스턴스였다. GLM-5.3 자체는 오픈소스 가중치일 뿐이다. 문제의 근원은 클라우드 제공업체의 컨테이너 자원 할당 오류와 하부 SGLang 추론 엔진의 상태 머신 결함이 결합된 데 있었다. 멀티 테넌트 대규모 언어 모델 추론의 물리적 격리 경계는 GPU 메모리(VRAM) 페이지에 존재한다. 게이트웨이 계층은 이 경계를 보호할 수 없다. 추론 엔진이 상태 머신의 한쪽에서 요청 중단을 기록하고 스케줄러가 다른 쪽을 확인한다면, 격리 메커니즘은 아무런 경고 없이 무너져 내린다.
 그림: 클라우드플레어가 공개한 공식 사고 타임라인 및 조치 경과. 영향 범위는 단일 긴 문맥 모델 배포로 제한되었으며, 노드 간 분리 아키텍처 환경의 구성 불일치가 사고 원인으로 확인되었다. 출처: Cloudflare (blog.cloudflare.com).
메모리 풀 용량 불일치와 스케줄러 상태 플래그 오류
프로덕션 배포에는 심각한 용량 불일치가 존재했다. 해당 엔드포인트는 외부에 1,048,576 토큰의 문맥 길이를 지원한다고 명시했으나, prefill 노드에 할당된 KV 캐시 풀의 실제 물리 용량은 681,280 토큰에 불과했다. 실제 할당량과 외부 공시 스펙 사이에 거의 3분의 1에 달하는 괴리가 있었다. 대규모 문맥 지원은 서비스 제공자의 핵심 마케팅 포인트였지만, 실제 메모리 할당은 단일 머신의 하드웨어 예산 한계에 묶여 있었다.
KV 캐시 풀 크기는 고정된 정적 설정값이 아니다. SGLang은 기동 시 가용 GPU 메모리에 따라 풀 크기를 동적으로 계산한다. 플랫폼 인프라는 이 동적 수치와 외부에 공시된 창 크기가 일치하는지 강제 검증하지 않았다. 두 설정값이 서로 다른 운영 파이프라인에서 관리되면서 용량 역전 현상이 조용히 발생했다. 정적 공시치가 동적 메모리 제약을 받지 않으면서 비정상적인 경계 처리의 뇌관이 되었다.
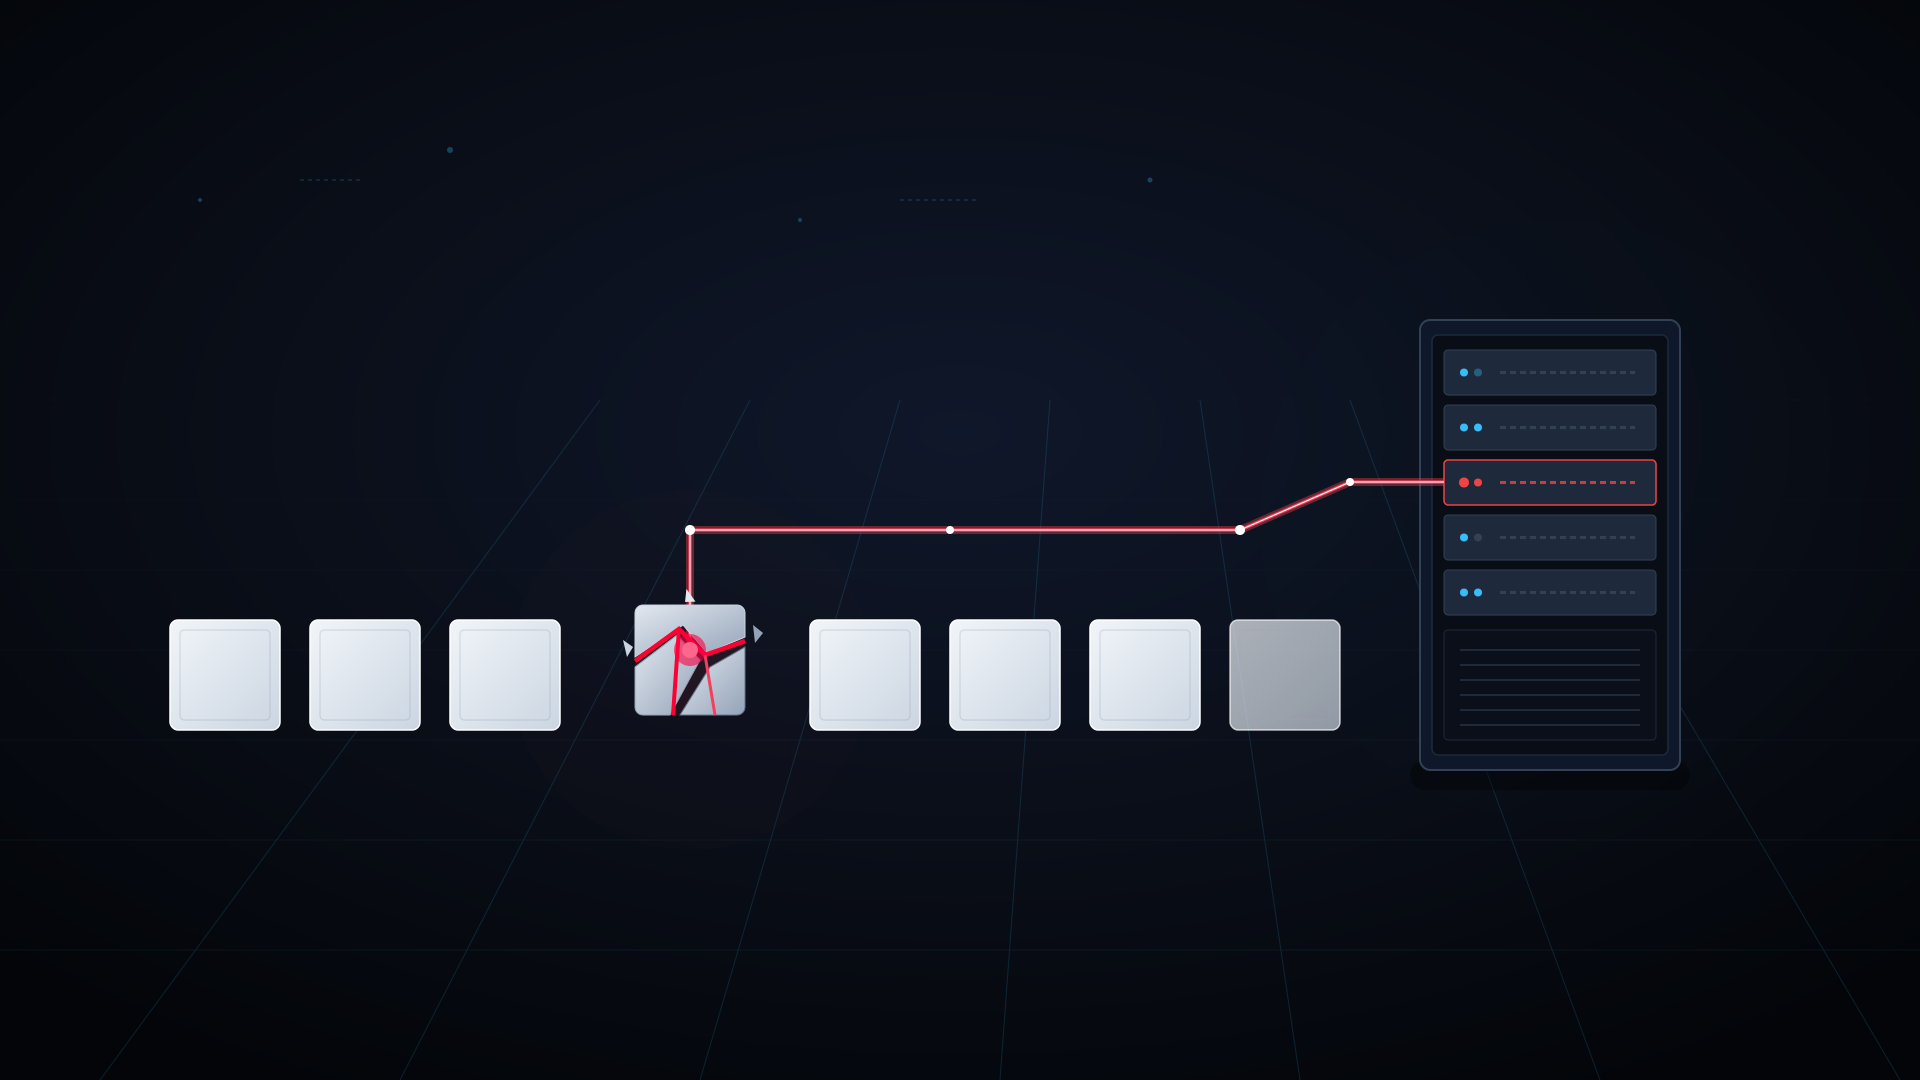
사용자 입력이 681,280 토큰을 초과하자 prefill 스케줄러는 메모리 부족을 감지하고 거절 로직을 실행했다. 스케줄러는 내부 함수인 Req.set_finish_with_abort를 호출했다. 이 함수는 초과 입력을 단 1개의 토큰을 가진 플레이스홀더로 교체했다. 이는 작업자 프로세스 전체의 비정상 종료 없이 요청 자원을 안전하게 반환하기 위해 설계된 장치였다.
그러나 바로 이 지점에서 SGLang 엔진의 내부 상태 머신에 불일치가 발생했다. 거절 플래그는 내부 딕셔너리인 to_finish에 기록되었지만, 핵심 상태 조회 메서드인 finished_reason은 동기화되지 않았다. 엔진 내부 메서드 req.finished()는 여전히 False를 반환했다. 시스템이 이미 중단을 결정한 요청이 핵심 수명주기 조회에서는 여전히 활성 작업으로 남아 있었던 것이다.
8페이지를 예약하고 1페이지 머무름: 미소거 메모리가 어텐션 연산으로 직행
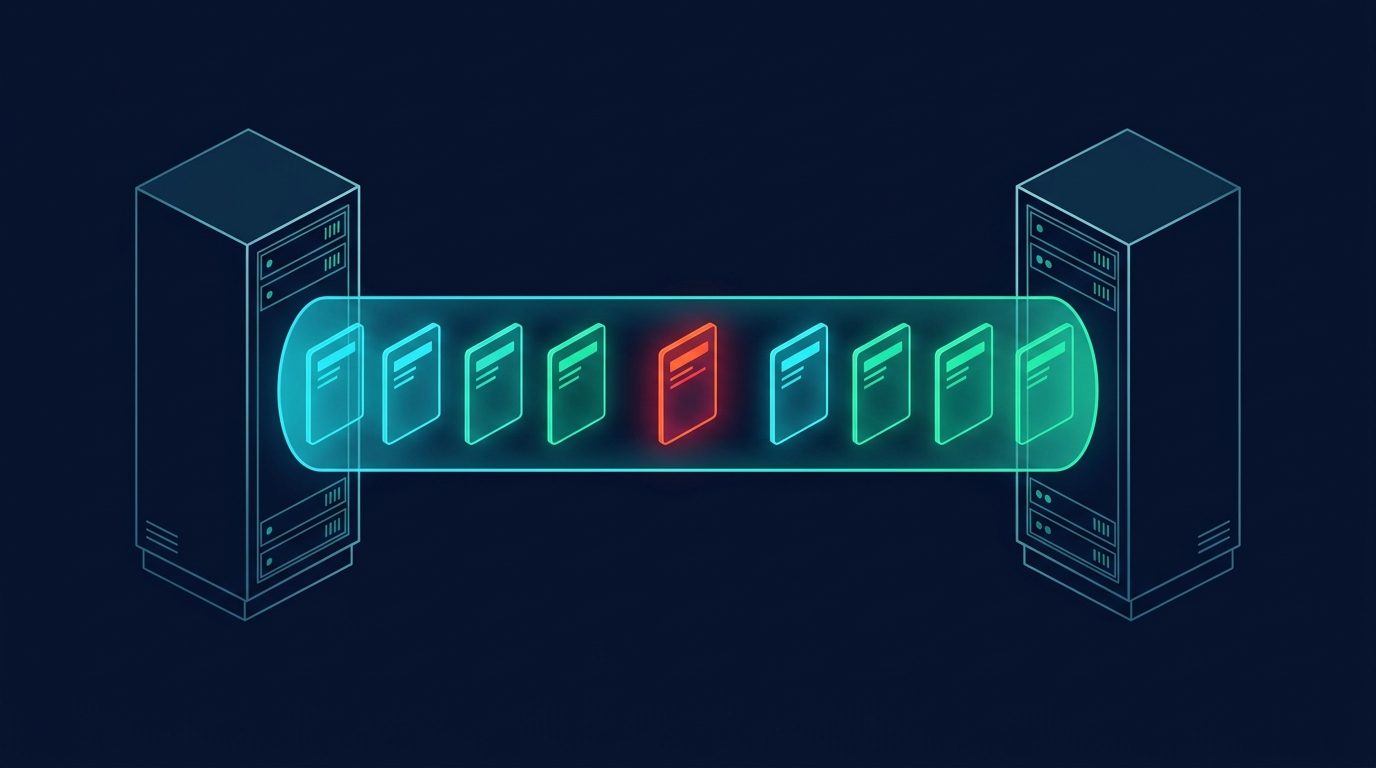
단일 머신 기반의 모놀리식 추론 환경이었다면 이 상태 불일치가 데이터 유출로 이어지지는 않았을 것이다. 단일 노드의 스케줄링 루프가 후속 단계에서 이상을 포착하고 클라이언트에 즉시 중단 오류를 반환했을 것이기 때문이다. 그러나 Workers AI 프로덕션 클러스터는 prefill과 decode를 분리한 ‘분리 추론(Disaggregated Prefill and Decode)’ 아키텍처를 채택하고 있었다. prefill 노드와 decode 노드가 분리 배포되고, KV 캐시는 Mooncake 프레임워크를 통해 초고속 RDMA 네트워크로 전송되는 구조였다.
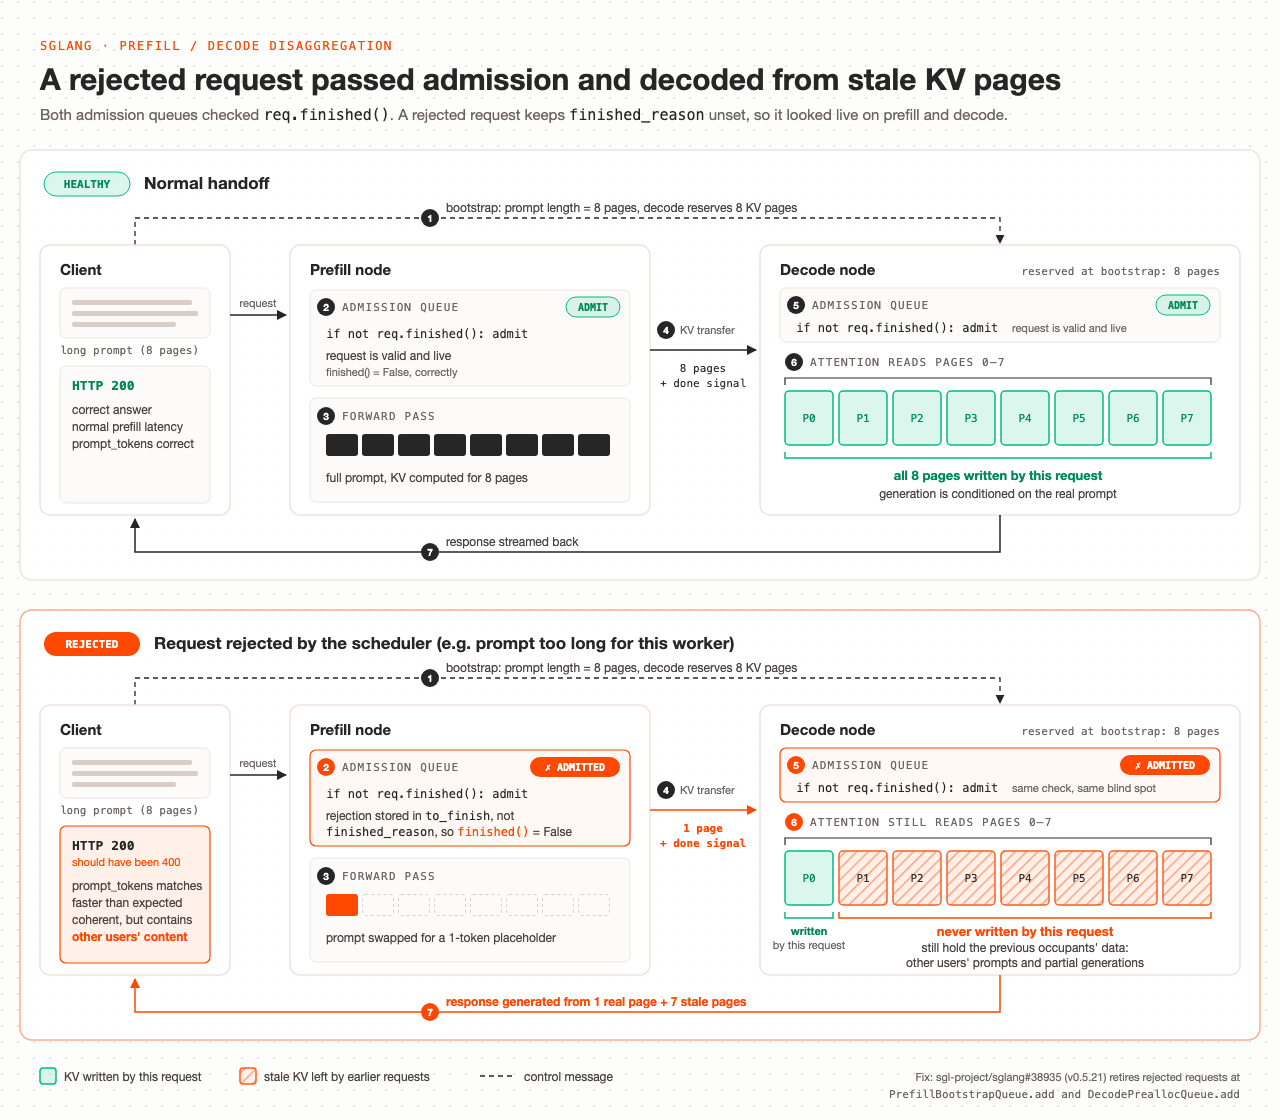 그림: 분리 추론 아키텍처 환경의 메모리 누수 경로. prefill 단계에서 중단된 요청의 상태 플래그 전달이 누락되어, decode 노드가 0으로 초기화되지 않은 과거 메모리 페이지를 어텐션 계산에 연결하면서 데이터가 유출되었다. 출처: Cloudflare (blog.cloudflare.com).
높은 동시 처리량을 유지하기 위해 GPU 물리 메모리 페이지는 새로운 요청에 할당될 때 0으로 초기화되지 않는다. 매 페이지를 0으로 덮어쓰는 작업은 메모리 대역폭과 응답 지연 시간을 심각하게 저하시킨다. 시스템은 스케줄러가 관리하는 메타데이터를 전적으로 신뢰하며, 멀티 테넌트 보안은 메타데이터 플래그의 정확성에 완전히 의존하고 있었다.
노드 간 작업 전달 시 진입 큐는 명시적 중단 플래그 대신 finished() 메서드를 호출했다. 해당 요청은 정상적인 작업으로 오인되어 스케줄러를 통과했다. prefill 노드는 1토큰 플레이스홀더를 위해 1개의 물리 페이지만 할당해 데이터를 작성한 후 decode 노드에 전송 완료를 통보했다.
수신 측에는 결정적인 검증 과정이 누락되어 있었다. decode 노드는 원래 요청의 거대한 길이에 맞춰 8개의 물리 페이지를 미리 예약해 두었지만, 실제로 전달받은 새 데이터는 1개 페이지뿐이었다. 그럼에도 계산 모듈은 예약된 8개 물리 페이지 전체를 Attention 연산기에 그대로 투입했다. 나머지 7개 물리 페이지에는 직전 테넌트가 남긴 덮어쓰이지 않은 데이터가 잔존해 있었고, 소거되지 않은 메모리 데이터가 그대로 행렬 곱셈 연산에 포함되었다.
155번의 HTTP 200 응답: 정상 모니터링 뒤에 숨겨진 유출
이 메모리 유출은 프로덕션 환경에서 아무런 경고음 없이 진행되었다. 사후 전체 로그 감사 결과, 총 155건의 응답이 다른 사용자의 컨텍스트를 포함한 채 반환된 것으로 확인되었다. 영향을 받은 모든 요청은 입력 길이가 681,280 토큰 임계값을 정확히 초과한 경우였다. 긴 문맥 경계에서의 처리 결함으로 인해 해당 요청들이 고스란히 메모리 취약점의 대상이 되었다.
외부의 악의적인 공격 가능성은 배제되었다. 클라우드플레어는 자체 엔지니어링 디버깅 기록과 보안 연구원의 재현 요청을 제외하고 분석했다. 그 결과 영향받은 호출의 발생 시점과 요청량이 실제 긴 문맥 워크로드 패턴과 정확히 일치함을 확인했다. 계획된 침투 공격이 아닌 정상적인 프로덕션 트래픽이 트리거한 사고였다.
전체 파이프라인의 모니터링 프로브는 어떤 경보도 울리지 않았다. 게이트웨이가 수신한 HTTP 상태 코드는 정상적인 200이었다. 요청 지연 시간도 정상 범위 내에 있었고, 토큰 과금 통계도 요청 스펙과 부합했다. 인프라 대시보드는 온통 정상 신호뿐이었으며, 장애는 건강해 보이는 지표 아래에서 조용히 지속되었다.
신경망 모델 특유의 텍스트 생성 능력도 이상 징후 포착을 방해했다. 대규모 언어 모델은 조합된 Attention 벡터를 처리하면서도 문법적으로 매끄러운 텍스트를 생성할 수 있다. 언어 모델 자체는 생성된 내용의 의미론적 소유권을 검증하지 않는다. 기존의 에러 로그와 예외 처리 체계가 무력화되면서 전형적인 무경고 데이터 유출이 발생했다.
상태 코드만 확인하고 출력은 불문: 엔진에 외주 맡긴 보안 경계
유사한 위험 신호는 오픈소스 커뮤니티에서 처음 등장한 것이 아니었다. 이미 2026년 7월 6일, SGLang 커뮤니티 Issue #30233에서 prefill 스케줄러의 중단 상태 처리에 관한 이상 현상이 논의된 바 있었다. 클라우드플레어도 v0.5.10을 도입한 이래 내부적으로 유사한 징후를 관찰했으나, 산발적인 오류를 일시적인 네트워크 지연 정도로 치부했다. 사전 경고 신호가 일상의 잡음 속에 묻힌 것이다.
클라우드플레어는 사후 분석에서 업계 전반에 퍼진 테스트 사각지대를 지적했다. 기존의 배포 검증은 API 상태 코드, 시스템 처리량, 긴 문맥 부하 테스트에만 집중해 왔다. 생성된 출력과 입력 프롬프트 사이의 의미론적 일관성을 자동으로 검증하는 파이프라인은 부재했다. 클라우드 제공업체들은 추론 엔진이 예외를 던지지 않는 한 내부 상태 머신의 자원 할당이 신뢰할 수 있다고 가정해 왔다.
멀티 테넌트 격리의 안전선은 GPU 메모리 페이지 소유권 추적에 달려 있다. API 게이트웨이 계층은 요청 라우팅과 과금 인증만을 담당할 뿐, GPU 내부의 메모리 매핑 테이블을 들여다볼 수 없다. 클라우드 인프라가 엔진 내부 상태에 대한 독립적 검증 메커니즘을 갖추지 못하면, 데이터 격리 방어선은 사실상 추론 프레임워크의 코드 한 줄에 외주를 준 셈이 된다.
2배 여유 마진 확보와 노드 간 정합성 검증 의무화
사고 대응 과정은 신속하게 진행되었다. 9월 9일 13시 22분에 정식 대응에 착수해 25분 만에 장애를 재현했다. 14시 00분에 해당 모델을 오프라인으로 전환했고, 14시 52분에는 모든 prefill 노드를 순차 재부팅해 잔여 메모리를 초기화했으며, 19시 40분 핫픽스를 배포하여 서비스를 정상화했다. 이어 SGLang 코어 팀과 협력해 9월 11일부터 19일까지 프로덕션 클러스터 전반에 대한 강화 작업을 완료했다.
구성 측면에서는 엄격한 안전 여유폭이 도입되었다. 클라우드플레어는 prefill KV 캐시 풀을 공시 문맥 창 크기의 2배에 달하는 약 204만 토큰으로 확장했다. 이는 기존에 안정적으로 운용되던 GLM 5.2 환경과 동일한 수준이다. 아울러 배포 파이프라인에 필수 검증 단계를 추가했다. 컨테이너 기동 전 구동 중인 엔진의 물리적 KV 풀 크기를 직접 읽어 공시 문맥 창 크기와 대조함으로써 용량 역전 발생을 원천 차단했다.
엔진 계층의 수정 사항도 신속하게 상위 저장소에 반영되었다. SGLang 메인테이너들은 PR #38704, PR #36988, PR #38935를 잇달아 병합했다. 이제 중단 플래그가 붙은 요청은 진입 큐 단계에서 즉각 차단되며, 메모리 할당 및 노드 간 전송이 전면 금지된다. 동시에 decode 노드에 검증 로직이 추가되어, 수신된 페이지 수가 예약된 페이지 수와 일치하지 않을 경우 즉시 오류를 발생시킨다. 해당 패치는 SGLang v0.5.21 및 v0.5.22 버전에 정식 반영되었다.
클라우드플레어의 이번 기술 분석은 분리 추론 발전 과정에서 지불해야 했던 엔지니어링 대가를 보여준다. 처리량과 메모리 활용도를 극대화하기 위해 현대의 추론 아키텍처는 prefill과 decode를 분리하고, 초고속 네트워크를 통해 KV 캐시를 전송하며, 초기화되지 않은 메모리 페이지를 재사용한다. 그러나 이러한 최적화는 멀티 테넌트 격리라는 근본적인 안전장치를 단 하나의 미세한 플래그 검사에 의존하게 만들었다. 클라우드 인프라 검증이 표면적인 HTTP 상태 코드 확인에 머무는 한, 메모리 깊숙한 곳에서 일어나는 조용한 데이터 유출은 언제든 재현될 수 있다.
참고 링크:
- 클라우드플레어 공식 사고 분석 및 복구 보고서 (KV Cache Exposure Remediation)
- SGLang PR #38704: 분리 추론 환경에서 전송 및 예약 토큰 수 일치성 검증
- SGLang PR #38935: 진입 큐 단계에서 비정상 중단 요청 조기 차단
- SGLang Issue #30233: Prefill 스케줄러 중단 처리 기록