2026年9月8日深夜、セキュリティ研究組織KnosticからCloudflareへ1件の脆弱性報告が寄せられた。Workers AIプラットフォームで長文コンテキストモデルを呼び出した際、エラーを一切返さずに他ユーザーの入力データが混入して応答されるというものだった。報告受領から25分以内、エンジニアリングチームは2つの独立したアカウントを用いてデータ混入の再現に成功した。APIゲートウェイは正常なHTTP 200ステータスコードを返しており、出力テキストは文法的に極めて自然でありながら、直前の別リクエストのプライベートな入力内容が紛れ込んでいた。
影響を受けたサービスは @cf/zai-org/glm-5.3 モデルに限定されていた。このモデルは8月27日にWorkers AIにデプロイされたもので、同プラットフォーム上で唯一影響を受けたホストインスタンスであった。GLM-5.3自体はオープンソースの重みデータに過ぎない。問題の根底にあったのは、クラウド事業者のコンテナリソース設定と、基盤となるSGLang推論エンジンのステートマシン欠陥の複合要因だった。マルチテナントLLM推論における物理的な隔離境界はGPUメモリ(VRAM)ページにある。ゲートウェイ層ではこの境界を保護できない。推論エンジンが状態管理の一方で中断を記録し、スケジューラがもう一方を参照してしまえば、隔離機構は何の警告もなく破綻する。
 図:Cloudflareが公開したインシデント報告と対処タイムライン。影響範囲は単一の長文コンテキストモデルのデプロイに限定されており、ノード間分離アーキテクチャにおける設定の乖離が誘因となったことが確認された。出典:Cloudflare(blog.cloudflare.com)。
メモリプールの容量乖離とスケジューラのステータス不一致
本番デプロイには深刻な容量の不整合が存在していた。このサービスは外部向けに1,048,576トークンのコンテキスト長を公称していたが、prefillノードに割り当てられたKVキャッシュプールの実容量はわずか681,280トークン分しかなかった。実割り当てと公称値の間には約3分の1ものギャップがあった。長文コンテキストはサービス事業者にとって主要な訴求点であるが、実際のVRAM割り当ては物理ホストのハードウェア予算に縛られる。
KVキャッシュプールの容量は静的設定パラメータではない。SGLangは起動時に空きVRAMに応じて動的にプールサイズを算出する。プラットフォーム側では、この動的な値と公称ウィンドウが整合しているかを強制検証していなかった。2つのパラメータが別々の運用フローで管理されていたため、容量の逆転が静かに進行した。静的公称値が動的メモリ制約に紐付いていなかったことが、その後の境界外処理の引き金となった。
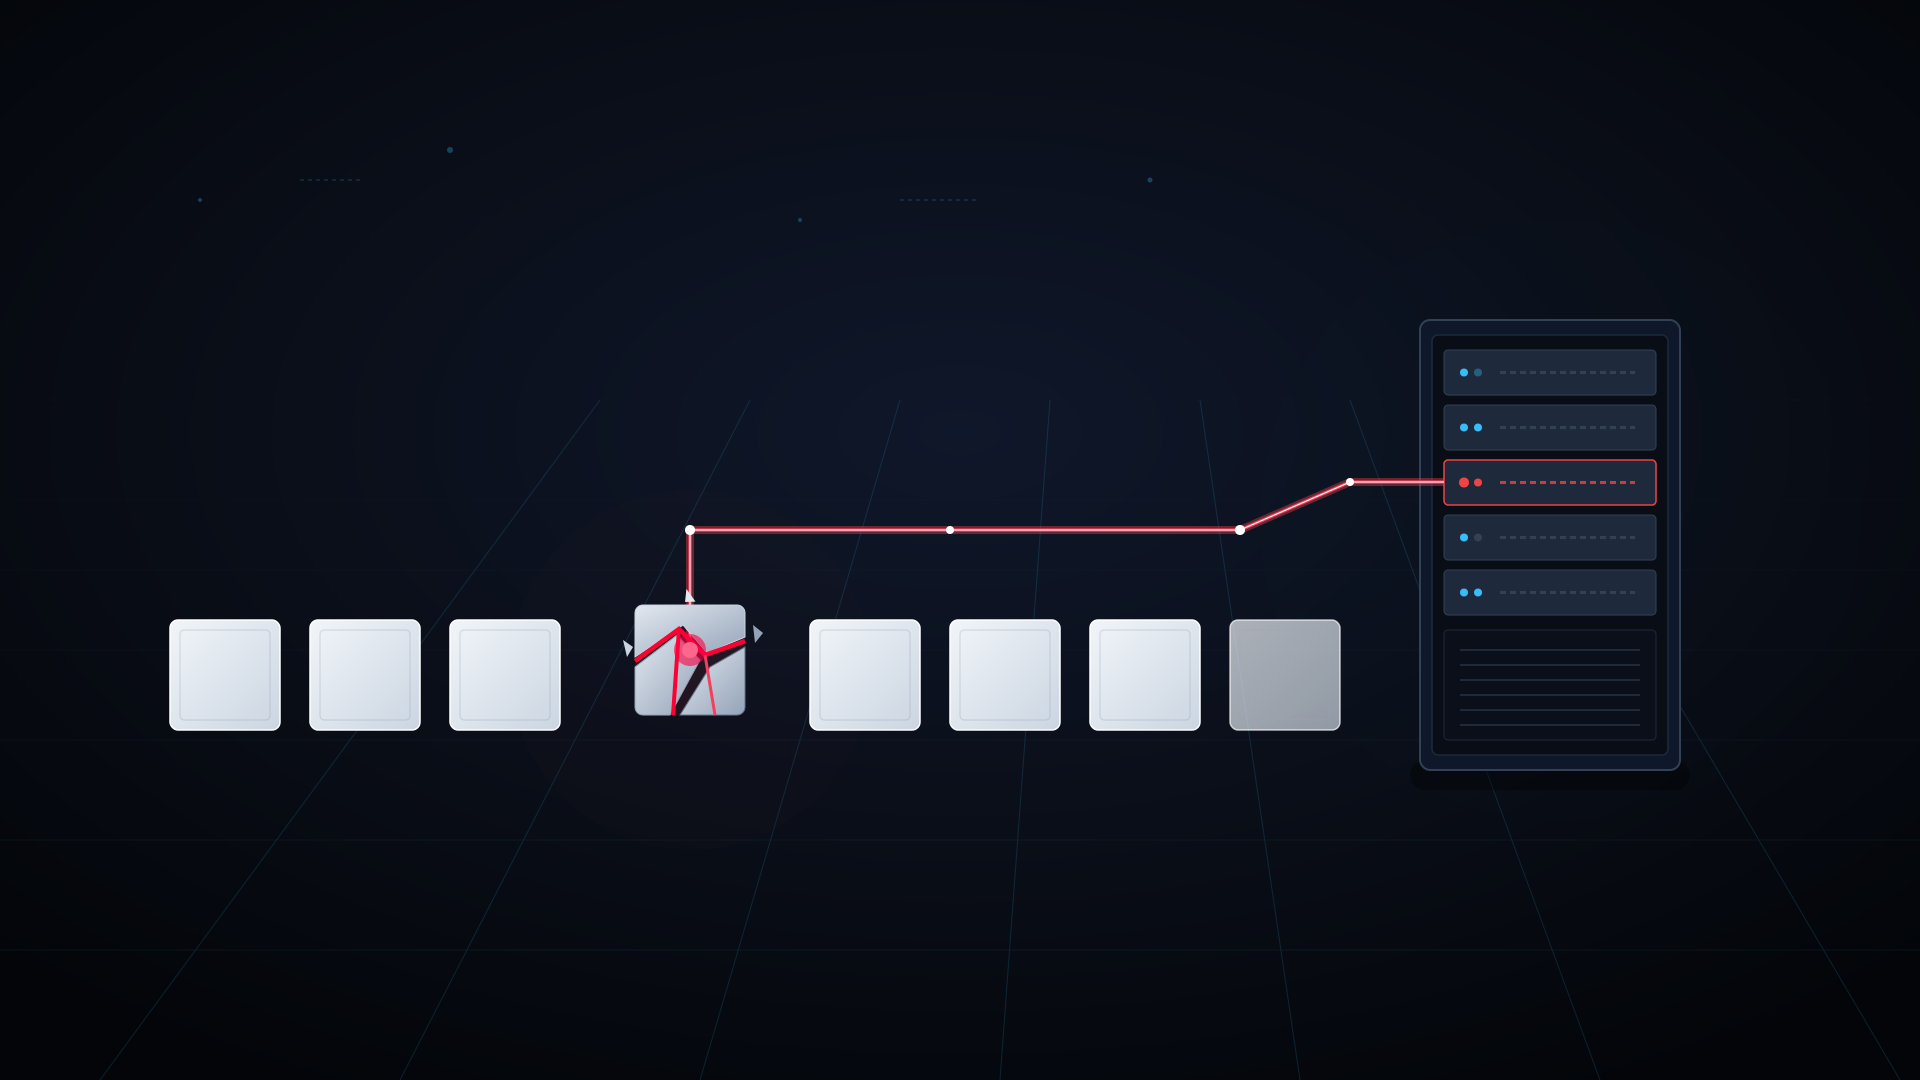
ユーザー入力が681,280トークンを超えると、prefillスケジューラはメモリ不足を検知し拒否ロジックを発動する。スケジューラは内部メソッド Req.set_finish_with_abort を呼び出し、超過した入力をわずか1トークンのプレースホルダーに置き換えた。これは本来、ワーカープロセス全体をクラッシュさせずにリソースを安全に解放するための仕組みだった。
しかし、SGLangエンジンの内部ステートマシンで状態の食い違いが生じた。中断フラグは内部辞書 to_finish に書き込まれたものの、コア状態メソッド finished_reason は同期更新されなかった。その結果、エンジン内部メソッド req.finished() は依然として False を返し続けた。システムが破棄を決めたはずのリクエストが、主要な状態判定において依然としてアクティブなタスクとして認識されていたのである。
8ページ確保して1ページのみ書き込み、未消去メモリがアテンション計算へ直行
単一ノードによるモノリシックな推論デプロイであれば、この状態不一致がデータ漏洩に発展することはなかった。単一マシンのスケジューリングループが異常を検知し、呼び出し元に直接中断を通知できたからだ。しかしWorkers AIの本番クラスタでは、prefillとdecodeを分離する「分離型推論(Disaggregated Prefill and Decode)」アーキテクチャが採用されていた。prefillノードとdecodeノードは疎結合され、KVキャッシュはMooncakeフレームワークを介してRDMAネットワーク上を高速転送されていた。
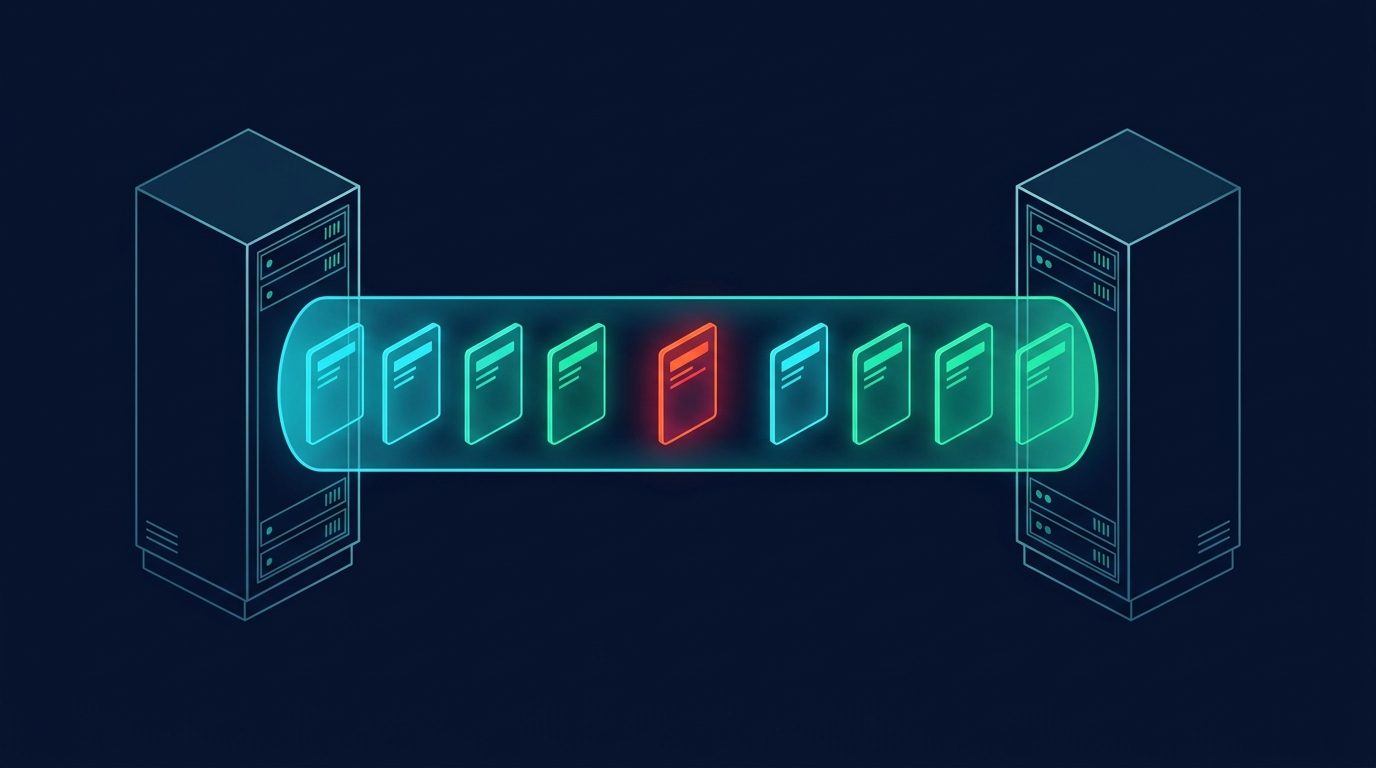
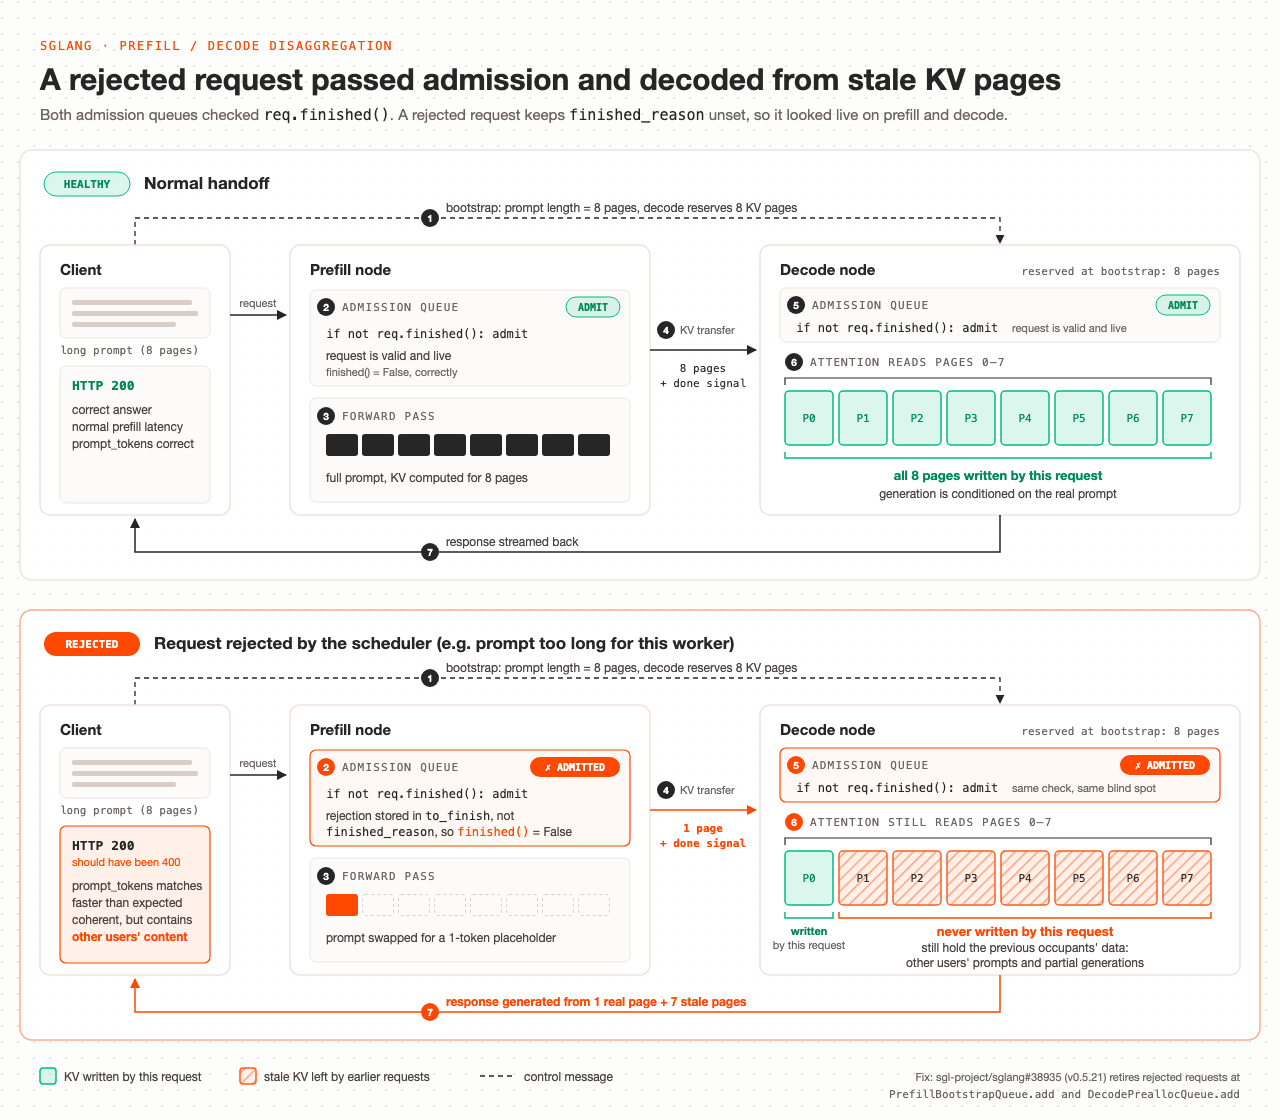 図:分離型推論アーキテクチャにおけるメモリ漏洩経路。prefill段階で中断された長文リクエストのステータス伝達が欠落し、decodeノードがゼロクリアされていない過去のメモリページをアテンション計算に組み込んだことでデータ漏洩が発生した。出典:Cloudflare(blog.cloudflare.com)。
高い並行スループットを維持するため、GPUメモリの物理ページは新規リクエストへ再割り当てされる際にゼロクリアされない。毎ページをゼロ消去するとVRAM書き込み帯域と応答レイテンシが著しく悪化するからだ。システムは物理ページのライフサイクル管理においてスケジューラのメタデータを暗黙に信頼しており、マルチテナントの安全性はメタデータフラグの整合性に完全に依存していた。
ノード間の受け渡しにおいて、受付キューは明示的な中断フラグではなく finished() メソッドを参照していた。そのため該当リクエストは正常タスクと誤認されて通過した。prefillノードは1トークンのプレースホルダーに対して1物理ページを割り当てて書き込み、decodeノードへ転送完了を通知した。
だが受信側には決定的な検証が欠落していた。decodeノードは元リクエストの長大な公称サイズに基づきあらかじめ8物理ページを確保していたが、実際に転送されてきた新規データは1物理ページ分だけだった。それにもかかわらず、計算モジュールは確保済みの8ページすべてをそのままAttention演算器へと渡してしまった。残る7ページには直前の他テナントの未上書きデータが残存しており、消去されていないメモリ内容がそのまま行列積計算へと組み込まれてしまったのである。
155件のレスポンスが200を返却、グリーンの監視指標が隠したデータ貫通
このメモリリークは本番環境において一切の警告を発することなく進行した。事後の全ログ監査によると、他人のコンテキストが混入したレスポンスは計155件に達した。影響を受けたすべてのリクエストは、入力長が681,280トークンの閾値を明確に超過していた。長文境界での処理不全が、特定の大規模入力リクエストをこのメモリ脆弱性の被害者に仕立て上げた。
外部からの悪意ある探索の可能性は否定された。Cloudflareは社内の調査ログやセキュリティ研究者の再現リクエストを除外した上で、該当アクセスの発生日時と頻度が正規ユーザーの長文コンテキスト利用パターンと完全に一致していることを確認した。組織的なサイバー攻撃ではなく、通常の長文トラフィックによって引き起こされた事故だった。
パイプライン全体の監視システムは警報を鳴らさなかった。ゲートウェイ側が受け取ったHTTPステータスコードは正常な200であり、リクエスト所要時間も適正範囲内に収まり、トークン課金メトリクスも仕様通りだった。インフラ監視指標はすべてグリーンのままであり、健全な数値の陰で静かに漏洩が継続していた。
ニューラルネットワークの高い補完能力も異常の察知を遅らせた。大規模言語モデルは結合されたAttentionベクトルを処理しても文脈の通った文章を出力できる。言語モデル自身はコンテンツの意味論的な帰属先を検証しない。従来のエラーログや例外キャッチ機構は完全にすり抜けられ、典型的なサイレント・データリークが引き起こされた。
ステータスコードのみに依存し出力を不問にする、エンジンのブラックボックス化
類似の火種はオープンソースコミュニティでも今回が初出ではなかった。2026年7月6日の時点で、SGLangコミュニティのIssue #30233においてprefillスケジューラの中断処理に関する議論が記録されていた。Cloudflare自身もv0.5.10の導入以降、内部で同様の兆候を散見していたが、当時は一時的なネットワークの揺らぎとして片付けられていた。日常のノイズの中に予兆が埋もれてしまったのである。
Cloudflareは振り返りの中で、業界全体に広がるテストの死角を指摘している。従来の品質保証はAPIステータスコード、スループット、長文負荷耐性にリソースを集中させてきた。生成されたテキストと入力プロンプトの意味的一貫性を自動検証するパイプラインは存在しなかった。推論エンジンが例外をスローしない限り、内部ステートマシンのリソース割り当ては正常であると無条件に信じられていた。
マルチテナント分離の安全基準は、GPUメモリページの所有権追跡にある。APIゲートウェイ層はルーティングと課金認証を担うのみであり、GPU内部のページマップを直接監視することはできない。クラウド事業者が推論エンジン内部の状態検証を怠れば、データ分離の防御線は実質的に推論フレームワークのわずか1行のコードに外部委託された状態となってしまう。
2倍の安全マージンとノード間検証の義務化
インシデントへの初動対応は迅速だった。9月9日13:22に正式に対策チームが立ち上げられ、25分で事象を再現。14:00には対象モデルをオフライン化し、14:52には全prefillノードをローリング再起動して残存メモリを一掃、19:40には修正パッチを投入してサービスを再開した。その後SGLangコアチームと連携し、9月11日から19日にかけて本番クラスタ全体の抜本的改修を完了させた。
設定面では厳格な安全マージンが設けられた。Cloudflareはprefill KVキャッシュプールを約204万トークン(公称コンテキスト長の2倍)へと拡張した。これは安定稼働実績のあったGLM 5.2と同水準である。さらにデプロイパイプラインに強制ゲートを追加し、コンテナ起動時に稼働中エンジンの物理KVプール容量を直接読み取って公称ウィンドウと比較し、容量の逆転を物理的に阻止する体制を整えた。
エンジン層の修正も上流リポジトリへ速やかにマージされた。SGLangメンテナーはPR #38704、PR #36988、PR #38935を順次マージした。中断フラグが付与されたリクエストは受付キューの段階で即座に遮断され、メモリ割り当てやノード間転送が一切禁止された。同時にdecodeノードに厳格なアサーションが追加され、実転送ページ数と予約ページ数が一致しない場合は即座にエラーをスローするようになった。これらの修正はSGLang v0.5.21およびv0.5.22に正式収録されている。
Cloudflareの技術報告は、分離型推論の進化に伴うエンジニアリング上の代償を浮き彫りにした。スループットとメモリ効率を極限まで追求するため、現代の推論基盤はprefillとdecodeを切り離し、未消去のメモリページを使い回しながらKVキャッシュを高速ネットワーク上に行き交わせる。しかしその最適化は、マルチテナント隔離という最も重要な防壁を、わずか1つのステータスフラグ検査の上に危うく成り立たせていた。インフラの検証がHTTPステータスコードの表層に留まる限り、メモリの深淵で生じる静かな漏洩はいつでも再来し得る。
参考文献:
- Cloudflare 公式インシデント分析・修正報告(KV Cache Exposure Remediation)
- SGLang PR #38704:分離型推論における転送トークン数と予約トークン数の整合性検証
- SGLang PR #38935:受付キューでの異常中断リクエストの事前インターセプト
- SGLang Issue #30233:Prefillスケジューラ中断処理の記録