A altas horas de la noche del 8 de septiembre de 2026, la firma de investigación de seguridad Knostic envió un informe de vulnerabilidad a Cloudflare. El reporte revelaba que al realizar peticiones a modelos de contexto largo en la plataforma Workers AI, el servicio devolvía entradas pertenecientes a otros usuarios sin generar error alguno. Apenas 25 minutos después de recibir el aviso, el equipo de ingeniería reprodujo la fuga cruzada entre inquilinos utilizando dos cuentas independientes. La pasarela API devolvía un código de estado HTTP 200 impecable. Aunque el texto generado era gramaticalmente coherente y fluido, contenía datos privados de peticiones previas de otros usuarios.
El problema afectó de forma exclusiva al modelo @cf/zai-org/glm-5.3. Desplegado en Workers AI el 27 de agosto, fue la única instancia alojada en la plataforma que sufrió este fallo. GLM-5.3 en sí mismo es solo un conjunto de pesos de código abierto. La raíz radicaba en una mala configuración de recursos en los contenedores del proveedor en la nube y en un defecto en la máquina de estados del motor de inferencia subyacente, SGLang. El límite de aislamiento físico en la inferencia multiinquilino de modelos de lenguaje reside en las páginas de memoria de la GPU (VRAM). La capa de la pasarela no puede proteger este límite: si el motor anota una cancelación en un extremo de su máquina de estados y el planificador consulta el otro, el aislamiento entre inquilinos se desmorona en silencio.
 Figura: Notificación oficial del incidente e hitos de resolución publicados por Cloudflare. La compañía confirmó que el impacto se limitó a un único despliegue de modelo de contexto largo, desencadenado por una desconexión de configuración en una arquitectura desagregada. Fuente: Cloudflare (blog.cloudflare.com).
Desajuste en el grupo de memoria y un indicador de estado fallido
El despliegue en producción albergaba un grave desajuste de capacidad. El servicio anunciaba compatibilidad con una ventana de contexto de 1.048.576 tokens, pero el grupo de KV cache asignado a los nodos de prefill solo podía albergar físicamente 681.280 tokens. La cuota asignada era casi un tercio inferior a la especificación pública. Aunque las ventanas de contexto gigantes son un argumento comercial habitual, la asignación de VRAM está sujeta a los límites presupuestarios de hardware de cada servidor.
La capacidad del grupo de KV cache no es un parámetro estático de configuración. Al arrancar, SGLang calcula dinámicamente el tamaño del grupo según la VRAM disponible. La plataforma no comprobó si ese cálculo dinámico coincidía con la ventana anunciada. Al gestionarse ambos parámetros mediante procesos operativos independientes, se produjo una discrepancia inadvertida. La falta de validación de este límite estático frente a la memoria dinámica preparó el terreno para un manejo anómalo de las peticiones fuera de rango.
Cuando un usuario enviaba una entrada superior a 681.280 tokens, el planificador de prefill detectaba falta de memoria y activaba la lógica de rechazo. El planificador invocaba el método interno Req.set_finish_with_abort, que sustituía la entrada excesiva por un marcador de posición de apenas 1 token. Este mecanismo se diseñó originalmente para liberar recursos de forma ordenada sin provocar la caída del proceso de trabajo.
Fue en este punto exacto donde la máquina de estados de SGLang se desajustó. El indicador de cancelación se escribió en el diccionario interno to_finish, pero el método de estado principal finished_reason no se actualizó en sincronía. Como consecuencia, el método interno req.finished() siguió devolviendo False. Una petición que el sistema ya había decidido descartar mantuvo su estado como activa en las comprobaciones del ciclo de vida.
Ocho páginas reservadas, una escrita: memoria residual sin limpiar entra en Attention
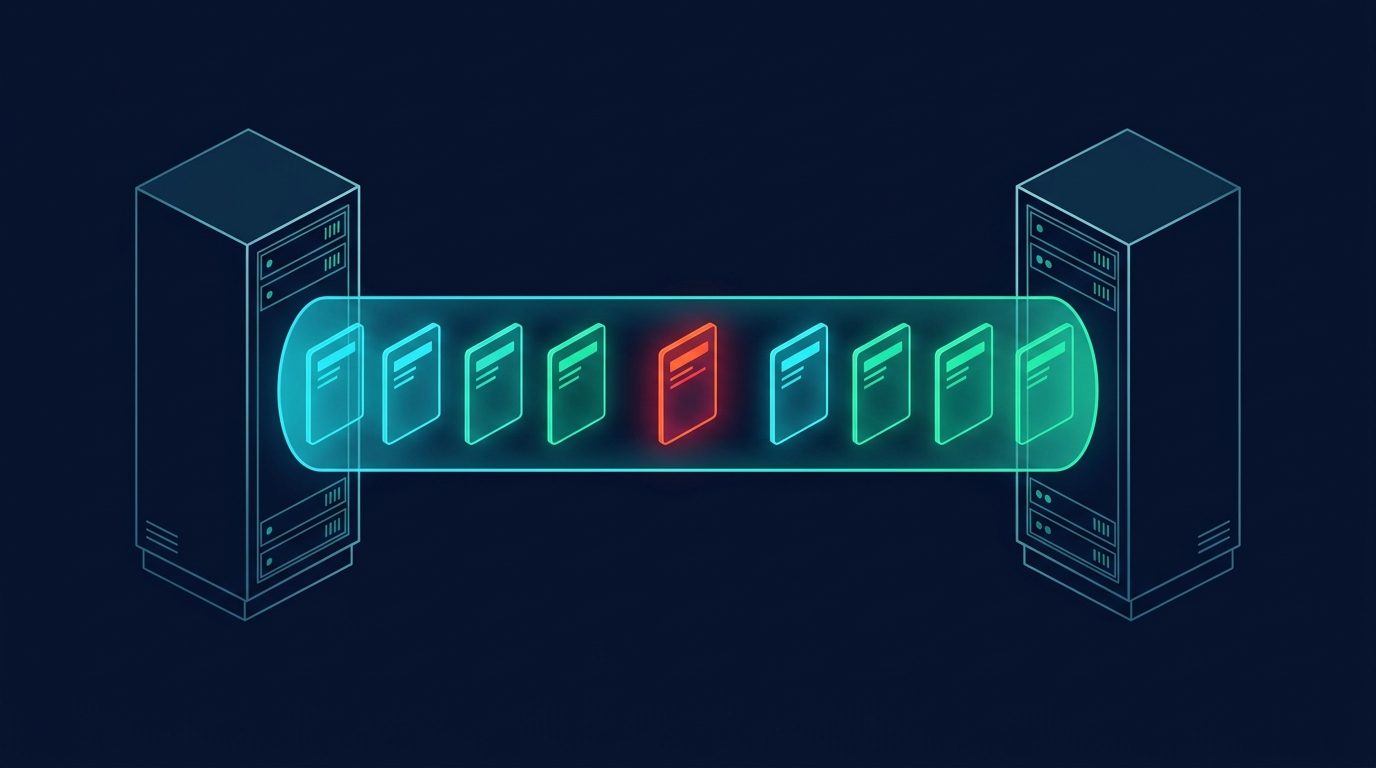
En un despliegue de inferencia monolítico convencional en un único servidor, esta discrepancia de estado no habría derivado en una fuga de datos. El bucle de planificación local habría detectado la anomalía y devuelto el error de interrupción directamente al cliente. Sin embargo, en los clústeres de producción de Workers AI se utilizaba una arquitectura de inferencia desagregada (Disaggregated Prefill and Decode). En este esquema, los nodos de prefill y decode están desacoplados, y la KV cache se transfiere a gran velocidad por redes RDMA mediante el framework Mooncake.
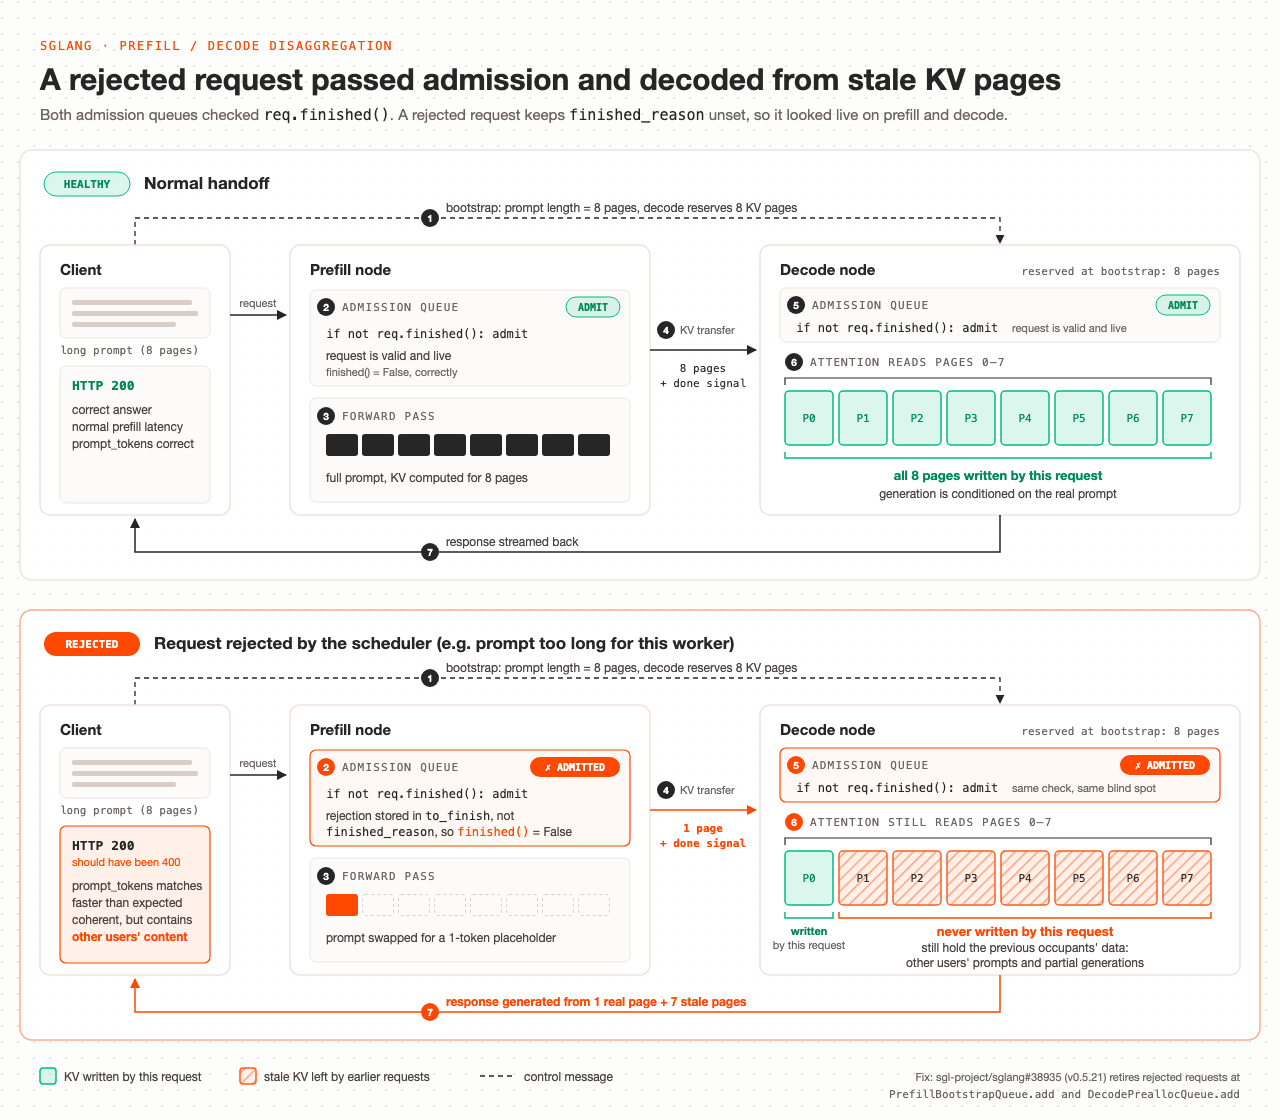 Figura: Ruta de fuga de memoria en la arquitectura de inferencia desagregada. Al cancelarse una petición excesiva en prefill, el estado no se transmitió correctamente. El nodo de decode incorporó páginas de memoria residuales sin borrar en el cálculo de atención, provocando la fuga de datos. Fuente: Cloudflare (blog.cloudflare.com).
Para garantizar un alto rendimiento concurrente, las páginas físicas de memoria de la GPU no se borran ni se rellenan con ceros antes de reasignarse. Poner a cero cada página penalizaría gravemente el ancho de banda y la latencia del sistema. Por diseño, la plataforma confía en que los metadatos del planificador gestionen adecuadamente el ciclo de vida de las páginas. Por tanto, la seguridad multiinquilino depende por completo de la exactitud de estos indicadores de estado.
Durante la transferencia entre nodos, la cola de admisión consultó el método finished() en lugar del diccionario de cancelaciones. El planificador interpretó erróneamente la petición como válida y la autorizó. El nodo de prefill asignó 1 página física al marcador de 1 token, escribió los datos y notificó al nodo de decode que la transmisión había finalizado.
El extremo receptor carecía de una validación crucial de longitud. Basándose en el tamaño original anunciado, el nodo de decode había reservado 8 páginas físicas, pero en la práctica solo recibió 1 página recién escrita. El motor de cómputo introdujo las 8 páginas reservadas directamente en el operador de Attention. Las 7 páginas restantes aún contenían datos residuales sin sobrescribir del inquilino anterior, por lo que esa información no purgada de la VRAM pasó directamente a las operaciones de multiplicación matricial.
155 respuestas con HTTP 200: la monitorización en verde ocultó la fuga
La fuga de memoria se produjo en absoluto silencio en producción. Tras una auditoría exhaustiva de los registros, se determinó que 155 respuestas devolvieron datos mezclados de otros usuarios. Todas las peticiones afectadas superaban con exactitud el umbral de 681.280 tokens. El desajuste en los límites de contexto convirtió estas peticiones en víctimas de la vulnerabilidad de memoria subyacente.
Se descartó cualquier ataque deliberado desde el exterior. Cloudflare aisló sus propios registros de depuración y las pruebas de los investigadores, confirmando que las fechas y el volumen de las llamadas afectadas coincidían con los patrones reales de uso de contexto largo. El incidente fue provocado por tráfico legítimo y normal, no por una intrusión maliciosa.
Las sondas de monitorización a lo largo de toda la infraestructura no detectaron nada. La pasarela recibió códigos de estado HTTP 200 de forma continua. La latencia de las respuestas se mantuvo dentro de los parámetros habituales y el recuento de tokens facturados coincidía con las especificaciones. Los paneles de métricas permanecieron completamente en verde, ocultando la fuga tras una aparente normalidad operativa.
La capacidad de completar texto de las redes neuronales mitigó aún más cualquier sospecha. Al procesar los vectores de Attention combinados, los grandes modelos de lenguaje generaron texto coherente y fluido. El modelo en sí no verifica la pertenencia semántica de sus datos. Los mecanismos tradicionales de captura de excepciones y registros de errores quedaron inutilizados, dando lugar a una fuga de datos totalmente silenciosa.
Verificar códigos de estado sin auditar la salida: la seguridad delegada en el motor
Este riesgo no era inédito en la comunidad de código abierto. El 6 de julio de 2026, el issue #30233 del repositorio de SGLang ya recogía debates sobre anomalías en el manejo de estados cancelados en el planificador de prefill. Cloudflare también había observado síntomas esporádicos internamente desde el despliegue de la versión 0.5.10, pero se atribuyeron a fluctuaciones transitorias de red. Las señales de advertencia se perdieron en el ruido operativo del día a día.
Cloudflare señaló en su autopsia un punto ciego extendido en toda la industria. Las pruebas de control de calidad previas al despliegue se centran habitualmente en los códigos de estado de la API, el rendimiento global y el estrés con textos largos. No existían mecanismos automatizados para validar la coherencia semántica entre el texto generado y el prompt de entrada. Los proveedores en la nube daban por sentado que, mientras el motor de inferencia no arrojara excepciones, la gestión de su máquina de estados era de total confianza.
La línea roja del aislamiento multiinquilino reside en el seguimiento de la propiedad de las páginas de GPU. Dado que las pasarelas API solo enrutan peticiones y gestionan autenticación y facturación, no pueden inspeccionar las tablas internas de asignación de memoria VRAM. Si los proveedores en la nube no auditan el estado interno del motor, la defensa del aislamiento de datos queda delegada a una simple línea de código del framework de inferencia.
Doble margen de seguridad y reconciliación obligatoria entre nodos
La respuesta al incidente fue rápida y resolutiva. El 9 de septiembre a las 13:22 se abrió formalmente la incidencia y en 25 minutos se reprodujo el fallo. A las 14:00 se retiró el modelo de producción, a las 14:52 se completó un reinicio progresivo de todos los nodos de prefill para purgar la memoria VRAM y a las 19:40 se restableció el servicio tras desplegar un parche de corrección. Posteriormente, en colaboración con el equipo principal de SGLang, se completó el blindaje de todos los clústeres de producción entre el 11 y el 19 de septiembre.
En la configuración se estableció un margen de seguridad riguroso. Cloudflare duplicó la capacidad del grupo de KV cache en prefill hasta aproximadamente 2,04 millones de tokens, el doble de la ventana de contexto anunciada. Esta proporción coincide con el estándar empleado con éxito en GLM 5.2. Asimismo, la cadena de despliegue incorporó una validación obligatoria: antes de iniciar un contenedor, se lee directamente el tamaño físico del grupo de KV cache en el motor y se compara con la ventana anunciada, evitando cualquier discrepancia de capacidad.
Las correcciones en el motor se incorporaron rápidamente al código principal de SGLang mediante los pull requests #38704, #36988 y #38935. Ahora, cualquier petición con marca de cancelación se bloquea de inmediato en la cola de admisión, impidiendo la asignación de memoria y la transferencia entre nodos. Al mismo tiempo, los nodos de decode validan estrictamente que las páginas recibidas coincidan con las reservadas, arrojando una excepción en caso de discordancia. Estas correcciones están disponibles en SGLang v0.5.21 y v0.5.22.
La autopsia técnica de Cloudflare pone de manifiesto el coste de ingeniería que conlleva la evolución hacia la inferencia desagregada. En pos del rendimiento y la optimización de memoria, las arquitecturas modernas separan prefill y decode, transfieren la KV cache a través de redes ultrarrápidas y reutilizan páginas de memoria sin borrarlas. Sin embargo, esta optimización dejó el pilar del aislamiento multiinquilino a merced de una única y frágil comprobación booleana. Mientras las pruebas de infraestructura sigan quedándose en la superficie de los códigos HTTP, las fugas silenciosas en lo más profundo de la memoria GPU seguirán siendo una amenaza latente.
Enlaces de referencia:
- Informe oficial de incidente y corrección de Cloudflare (KV Cache Exposure Remediation)
- SGLang PR #38704: Validación de coherencia entre tokens transmitidos y reservados en inferencia desagregada
- SGLang PR #38935: Intercepción temprana de peticiones canceladas en la cola de admisión
- SGLang Issue #30233: Registro de incidencias en el manejo de cancelaciones del planificador de prefill