2026 年 9 月 8 日深夜,安全研究机构 Knostic 向 Cloudflare 递交了一份漏洞报告。报告显示在 Workers AI 平台调用长上下文模型时,服务在未产生报错的情况下返回了其他用户的输入内容。接报 25 分钟内,工程团队使用两个独立账号成功复现了数据串扰。网关返回了标准的 HTTP 200 状态码。返回文本在语法上连贯自然,但内容中赫然夹杂着前序请求的私密数据。
受影响服务被锁定在 @cf/zai-org/glm-5.3 模型上。该模型于 8 月 27 日上线 Workers AI,属于该平台唯一受波及的托管实例。GLM-5.3 本身只是一套开源权重。问题源于云厂商的容器资源配置,以及底层 SGLang 推理引擎的状态机缺陷。多租户大模型推理的物理隔离边界落在 GPU 显存页上。网关层对此无法设防。只要引擎将拒绝记录写在状态机的一侧,而调度器从另一侧读取,隔离机制就会在静默中失效。
 图:Cloudflare 官方发布的事件通报与处置节点。官方确认受影响范围仅限单一长上下文模型部署,跨节点分离架构下的配置脱节成为故障诱因。来源:Cloudflare(blog.cloudflare.com)。
显存池容量错配,调度器写错状态位
上线部署中存在严重的容量错配。该服务对外声明支持 1,048,576 token 上下文,但 prefill 节点分配的 KV cache 池实际仅能容纳 681,280 token。显存池配额与外部声明之间相差了将近三分之一。长文本往往被服务商视为核心卖点,但显存分配直接受制于单机硬件预算。
KV cache 池容量并非固定配置项。SGLang 在启动时会根据剩余显存动态计算池大小。平台并未强制校验该数值与对外声明窗口的吻合度。当两个参数由不同运维流程分别维护时,容量倒挂便悄然发生。静态声明未能受到动态显存约束,为后续的越界处理埋下了伏笔。
当用户输入超过 681,280 token 时,prefill 调度器检测到显存不足并触发拒绝逻辑。调度器调用了内部函数 Req.set_finish_with_abort。该函数将超长输入替换为仅含 1 个 token 的占位符。这一机制原本用于优雅释放请求资源,避免直接崩溃影响整个工作节点。
SGLang 引擎的状态位在此处发生了分歧。拒绝标记被写入了内部字典 to_finish,但核心状态方法 finished_reason 却未被同步更新。引擎内部方法 req.finished() 依然返回 False。一个已经被系统决意丢弃的请求,在核心状态查询中依然保留着活跃身份。
预留8页只写1页,未清零显存直接进入计算
如果是单机推理部署,这一状态位分歧不会演变为数据泄漏。单机调度循环随后会捕获异常,将中止信息直接抛回给调用方。但在 Workers AI 生产集群中,系统采用了分离式推理(Disaggregated Prefill and Decode)架构。架构将 prefill 节点与 decode 节点解耦部署,KV cache 通过 RDMA 网络由 Mooncake 框架进行高速传输。
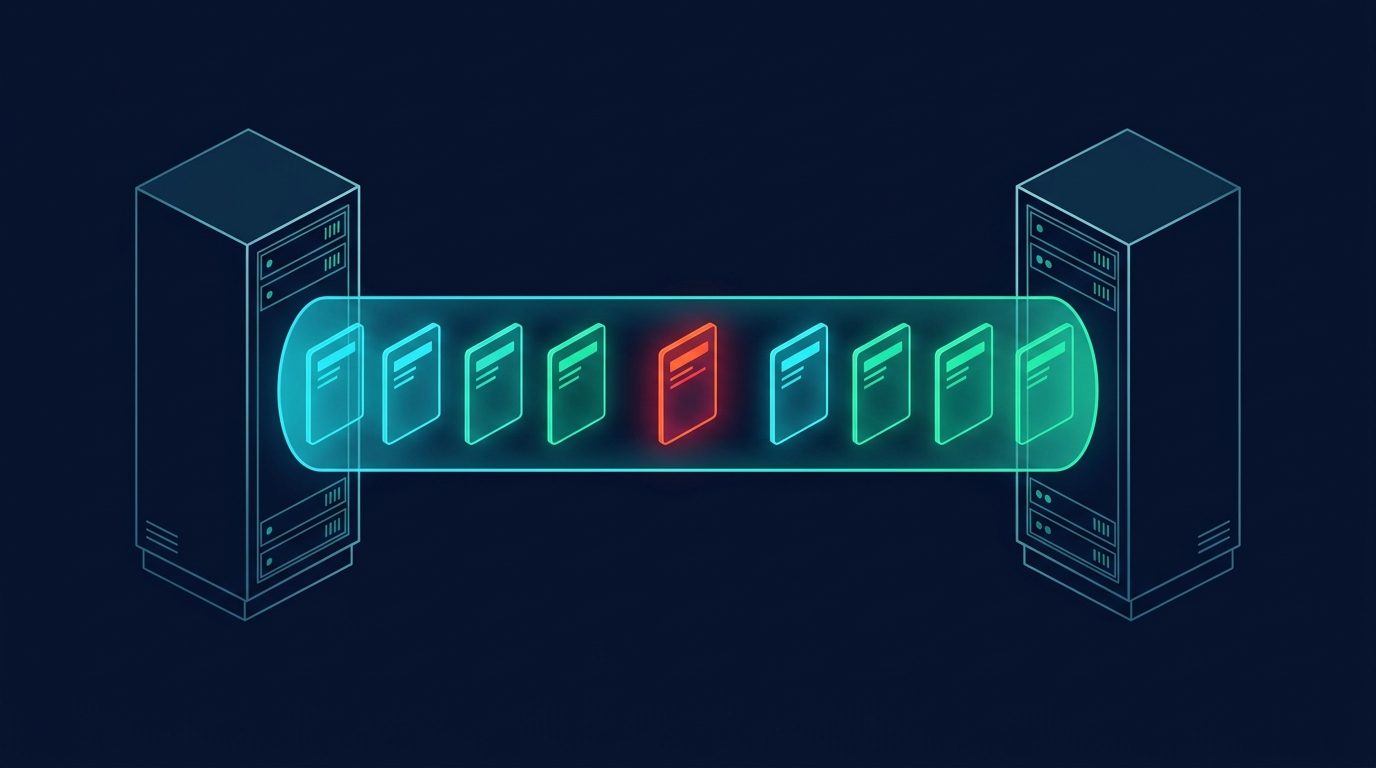
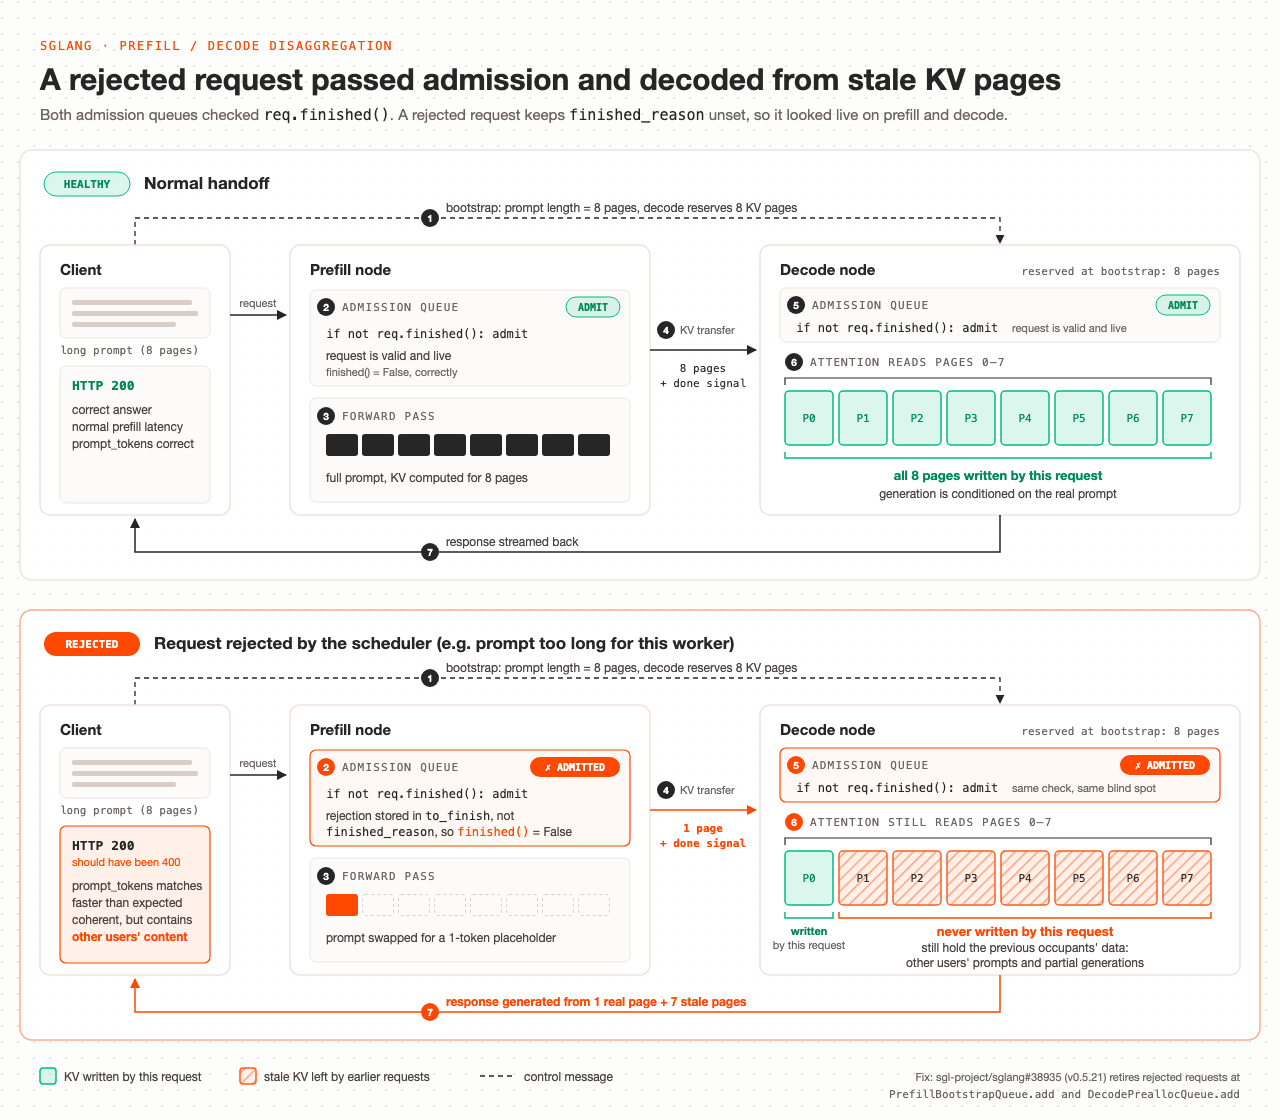 图:分离式推理架构下的显存泄露路径示意。超长请求在 prefill 阶段被中止后状态位传递缺失,decode 节点将未清零的历史显存页接入注意力计算,造成数据外泄。来源:Cloudflare(blog.cloudflare.com)。
为了保障高并发吞吐,GPU 显存物理页在分配给新请求时不会执行清零擦除。逐页清零会严重损耗显存写入带宽与响应延迟。系统默认信任调度器对物理页所有权的生命周期管理。多租户安全因此全部依赖元数据标记的正确性。
在跨节点交付中,准入队列调用的是 finished() 方法而非显式的拒绝状态位。该请求被误判为合法任务并被调度器顺利放行。prefill 节点为 1 token 的占位符分配了 1 个物理页写入数据,随后向 decode 节点发送了传输完成通知。
接收端缺少关键的长度对账。decode 节点预先根据原始请求的超大长度预留了 8 个物理页,但实际只接收到了 1 个物理页的新写入。计算模块直接将预留的全部 8 个物理页送入了 Attention 算子。后 7 个物理页依然保留着上一位租户尚未被覆盖的历史数据,未擦除的显存内容随之被编入了后续的矩阵乘法中。
155次响应返回200,监控绿灯掩盖穿透
这起显存穿透在生产环境中无声无息。根据事后全量日志审计,线上共有 155 个响应向用户输送了夹杂他人上下文的数据。所有受影响请求的输入长度均严格超过了 681,280 token 的临界点。长文本边界处的断裂,让这批超长请求成为了特定显存漏洞的受害者。
外部恶意探测的嫌疑被排除。Cloudflare 剔除了自身工程排查日志以及安全研究员的复现请求。团队确认受影响调用的时间与数量,与真实的长上下文使用节奏高度吻合。这起事件由正常长文本业务流量触发,并非预谋的黑客渗透。
整条链路的监控探针未能发出警报。网关端接收到的 HTTP 状态码为 200。请求耗时处于合理区间,返回的 token 计费统计也吻合请求规格。基础设施指标全部保持绿灯,故障在健康的指标掩盖下持续发生。
神经网络的补全能力削弱了异常的突兀感。大模型在处理拼接的 Attention 向量时依然能生成连贯文本。语言模型本身并不校验内容的语义归属。传统的错误日志与异常捕获机制在此失效,形成了典型的静默数据穿透。
只查状态码不读输出,安全边界外包给引擎
类似隐患在开源社区并非初次出现。早在 2026 年 7 月 6 日,SGLang 社区 issue #30233 就记录了关于 prefill 调度器中止状态处理异常的讨论。Cloudflare 自部署 v0.5.10 起也在内部遇到类似征兆。零星记录当时多被视作瞬态网络抖动。预警信号在日常噪音中被掩埋。
Cloudflare 在复盘中指出了行业普遍存在的测试盲区。传统的上线质量保障把精力集中在 API 状态码、系统吞吐量与长文本负载压力上。测试流程从未建立自动化机制,用以校验生成内容与输入提示词的语义一致性。云厂商默认推理引擎只要不抛出异常,内部状态机的分配便是可靠的。
多租户隔离的安全红线落在显存页所有权追踪上。API 网关层只负责路由请求与计费鉴权,无法透视 GPU 内部的显存映射表。云厂商一旦缺乏对引擎内部状态的校验机制,数据隔离的防线就事实上被外包给了推理框架的一行代码。
两倍冗余重画红线,跨节点校验必须合流
事件处置展现了应急响应的速度。9 月 9 日 13:22 官方正式立项,并在 25 分钟内复现故障。团队于 14:00 将模型下线,14:52 滚动重启全部 prefill 节点清理显存,19:40 部署修补热更后恢复对外服务。随后与 SGLang 核心团队协同,在 9 月 11 日至 19 日完成了生产环境全量集群的加固。
配置侧建立了严格的安全裕度。Cloudflare 将 prefill KV cache 池扩容至约 204 万 token,达到上下文窗口长度的两倍。这一规模与此前稳定运行的 GLM 5.2 保持一致。部署管线同步新增了强制门禁:容器拉起前直接从运行中的引擎读取 KV 池物理尺寸,与声明的上下文窗口强制比对,杜绝容量倒挂。
引擎层面的修复迅速合入上游代码库。SGLang 维护者相继合入了 PR #38704、PR #36988 与 PR #38935。带有拒绝标记的请求在准入队列阶段就会被立即阻断,严禁分配显存与发起跨节点传输。同时 decode 节点增加了强校验,一旦实际传输页数与预留页数不符立即报错。修复补丁已在 SGLang v0.5.21 与 v0.5.22 中全面发布。
Cloudflare 这次技术复盘揭示了分离式推理演进中的工程代价。为了追求吞吐与显存利用率,现代推理架构将 prefill 与 decode 拆开。KV cache 在高速网络中流动,未清零的显存页在请求交替时得以保留。架构优化将多租户隔离的基石,压在了一行细小的状态位检查上。只要云基础设施的测试依旧停留在 HTTP 状态码的表层,显存深处的沉默穿透就随时可能重演。
参考链接:
- Cloudflare 官方事故分析与修复报告(KV Cache Exposure Remediation)
- SGLang PR #38704:分离式推理传输与预留 token 数量一致性校验
- SGLang PR #38935:准入队列提前拦截异常中止请求
- SGLang Issue #30233:Prefill 调度器中止状态处理记录