Am 11. November 2026 stellte IBM in Yorktown Heights, New York, seinen Quantenprozessor der nächsten Generation vor: den Nighthawk r3. Bei dieser Ankündigung ging es nicht um neue Rekorde bei der Gesamtzahl physischer Qubits, sondern um eine neue ingenieurtechnische Benchmark: die stabile Ausführung von 10.000 Quantenoperationen auf 520 programmierbaren Qubits. Noch aufschlussreicher fielen die zeitgleich vorgelegten Kennzahlen aus der Praxis aus: Externe Partner wie E.ON, Algorithmiq und Q-CTRL ließen auf der Vorgängergeneration bereits mehr als 34 Milliarden Schaltkreise laufen und meldeten Beschleunigungen um bis zum 19-Fachen.
Nach drei Jahrzehnten Skepsis: Das Ende des reinen Zahlenkults
In den vergangenen dreißig Jahren wurde die Quanteninformatik von Kritikern oft mit dem Bonmot bedacht, sie sei „stets fünf Jahre entfernt“. Hardware-Hersteller überboten sich auf Produktpräsentationen gegenseitig mit der Anzahl physischer Qubits – von einigen Dutzend kletterten die Angaben bis in den vierstelligen Bereich. Die Realität war jedoch ernüchternd: Viele dieser physischen Einheiten erwiesen sich als derart fragil, dass sie nicht einmal wenige Dutzend Rechenschritte überstanden, bevor Umgebungswärme und Rauschen den Quantenzustand kollabieren ließen.
Die Fixierung auf schiere Mengenangaben lenkte die Prioritäten der Branche über Jahre hinweg fehl. Eine hohe Qubit-Zahl nützt in der Praxis wenig, wenn die Berechnungen weder präzise noch schnell genug ablaufen, um über Labordemonstrationen hinauszukommen. Erst durch die Neuausrichtung der Roadmap auf Ausführungsgeschwindigkeit und Zuverlässigkeit kann die Technologie den Schritt von der Vorführbühne in reale Produktionsabläufe vollziehen.
Mit 10.000 aufeinanderfolgenden Operationen über die Industrieschwelle
Auf dem Nighthawk r3 sind insgesamt 2.034 supraleitende physikalische Elemente gefertigt, für externe Berechnungen stehen jedoch gezielt 520 programmierbare Qubits zur Verfügung. Diese Diskrepanz resultiert aus einer strengen Selektion. Ähnlich wie in einer Obstplantage, in der von über zweitausend gepflanzten Bäumen nur gut fünfhundert die Qualitätsprüfung für die Ernte bestehen, dienen die übrigen Einheiten dazu, kurzlebige Hardwarefehler abzufangen und zu neutralisieren.
Der entscheidende technologische Durchbruch liegt in der Schaltungstiefe von 10.000 Operationen. Bei der Simulation chemischer Materialien oder der Optimierung komplexer Stromnetze müssen Algorithmen Tausende aufeinanderfolgende Quantengatter durchlaufen; mit jedem Schritt akkumulieren sich Fehler. Unterstützt ein Chip lediglich einige hundert Rechenschritte, liefert er selbst bei 10.000 vorhandenen Qubits schon bei der Modellierung mäßig komplexer Moleküle unbrauchbare Ergebnisse.
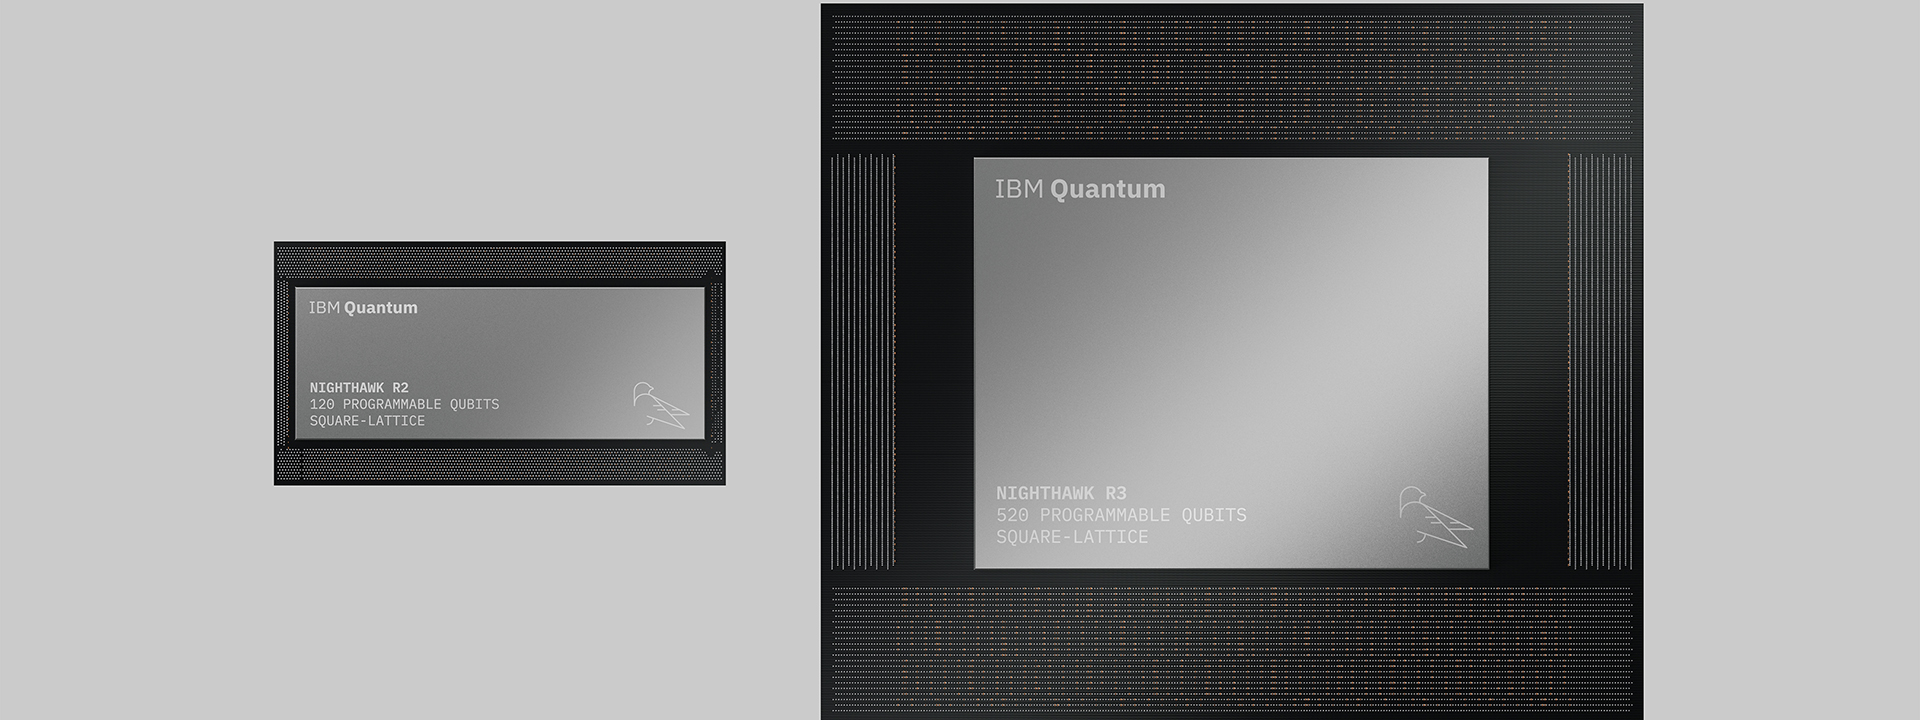 Abbildung: Rendering des Nighthawk-Prozessors. Die quadratische Gitterstruktur verbessert die Konnektivität zwischen den Qubits und verkürzt die Signalwege. Quelle: IBM Newsroom
Der r3 behält das quadratische Gitterlayout (Square Lattice) der Vorgängergeneration bei. Diese dichte Kopplung verkürzt die Signalwege signifikant und reduziert das Übersprechen zwischen benachbarten Qubits. Die Kombination aus über 500 Qubits und einer Tiefe von 10.000 Rechenschritten erlaubt es Forschern erstmals, realistische Festkörpergittermodelle direkt auf einem einzelnen Quantenchip zu simulieren.
100.000 Messungen pro Sekunde: Monate auf wenige Stunden komprimiert
Vielfach wird angenommen, ein Quantencomputer funktioniere wie ein klassischer Rechner: Taste drücken, und schon erscheint ein exakter Wert. Tatsächlich basiert Quantencomputing auf statistischem Sampling. Qubits entwickeln sich in Überlagerungszuständen, und jede Messung liefert lediglich einen stochastischen Einzelwert. Um die Grundzustandsenergie komplexer Moleküle zu ermitteln, muss derselbe Schaltkreis Millionen oder gar Milliarden Male wiederholt ausgeführt werden.
Die bereits im Produktiveinsatz befindliche Vorgängergeneration Nighthawk r2 erreicht eine Abtastrate von 100.000 Messungen pro Sekunde. Durch die Implementierung von Hochgeschwindigkeits-Resets gelang es den Ingenieuren, die Wartezeiten zwischen den einzelnen Schaltungsdurchläufen drastisch zu verkürzen. Erst dieser enorme Durchsatz ermöglicht es, statistische Rechenläufe mit Milliarden Wiederholungen in einem vertretbaren Zeitrahmen abzuschließen.
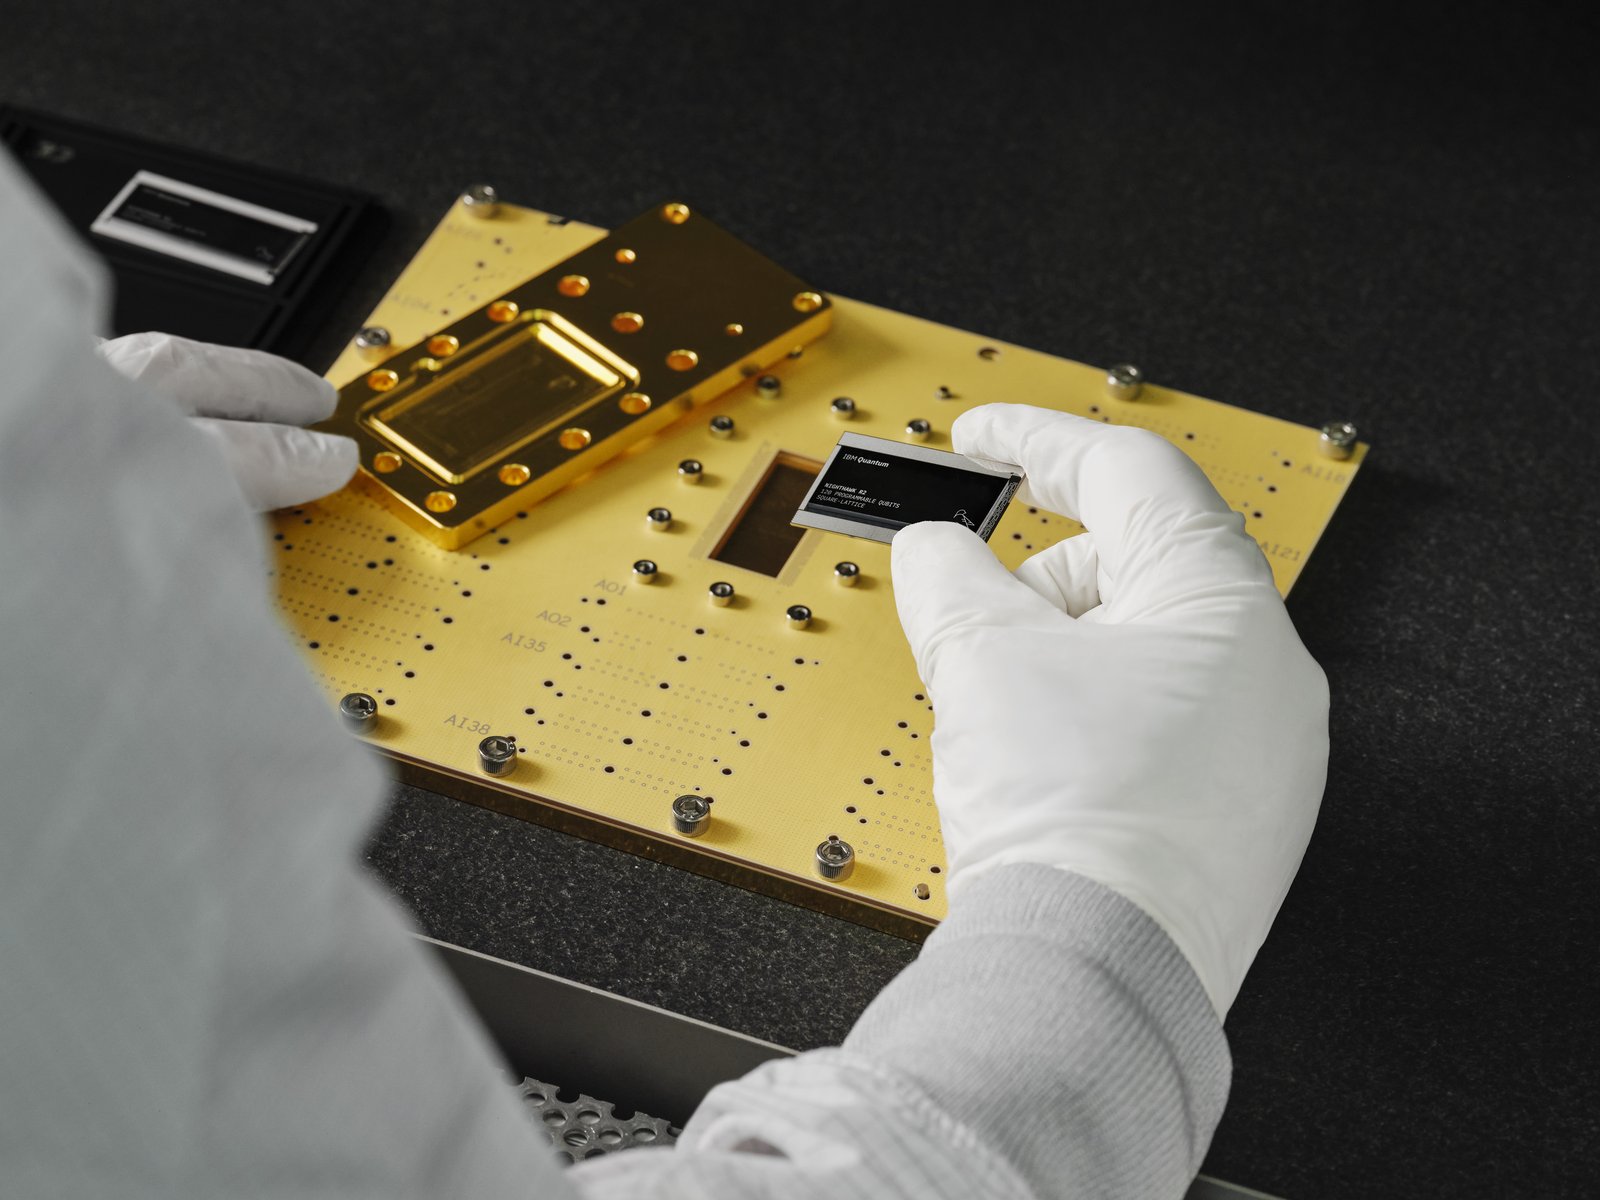 Abbildung: Der Nighthawk-r2-Prozessor im Handformat. Der Chip arbeitet bei einer Betriebstemperatur von 15 Millikelvin. Quelle: IBM Newsroom
Europäische Industriepartner wie der Energiekonzern E.ON und das Softwareunternehmen Algorithmiq führten auf dem r2 bereits 34 Milliarden Quantenschaltkreise aus. E.ON verzeichnete bei Aufgaben des quantengestützten maschinellen Lernens zur Netzoptimierung eine 15-fache Beschleunigung. Das Oak Ridge National Laboratory (ORNL) bildete reale magnetische Materialien auf dem System ab und reduzierte die Rechenzeit gegenüber der vorherigen Generation auf ein Zwölftel; die Simulationsergebnisse deckten sich exakt mit experimentellen Daten aus der Neutronenstreuung.
Algorithmiq steigerte die Ausführungsgeschwindigkeit von Materialsimulationen nach der Migration auf den neuen Prozessor um das Achtfache. Wollte man die gleiche Genauigkeit auf einem klassischen Supercomputer mit modernen Tensor-Netzwerk-Algorithmen erzielen, wäre nach Berechnungen der Forscher ein 240-facher Speicherbedarf erforderlich. Diese Speicherexplosion bei der klassischen Berechnung von Vielteilchen-Verschränkungen bildet das physikalische Fundament für den Quantenvorteil in spezialisierten Domänen.
Modulare Kopplung über zehn Brücken: Die 1.000-Qubit-Marke für 2027 anvisiert
Die physikalische Fläche eines einzelnen supraleitenden Chips lässt sich nicht beliebig vergrößern. Jenseits von tausend Qubits erzeugen die dichten Koaxialkabel massive thermische Lasten, während mikroskopische Fertigungsfehler die Ausbeute ganzer Silizium-Wafer zunichtemachen. Der monolithische Ansatz stößt an eine harte Grenze; die modulare Zusammenschaltung mehrerer Chiplets ist daher der folgerichtige Ausweg.
IBM bestückte die Ränder des r3-Chips mit zehn sogenannten „l-Couplern“ – Quanten-Interconnect-Brücken. In vorangegangenen Machbarkeitsnachweisen koppelten die Ingenieure zwei Chips der ersten Generation über vier Leitungen und erzielten eine Übertragungstreue der Quantenzustände von 99,3 Prozent. Im August 2026 wurden zwei getrennte Kryostat-Module zu einem gemeinsamen Kühlsystem zusammengeführt; das Herunterkühlen von Raumtemperatur auf die Betriebstemperatur von 15 Millikelvin dauerte weniger als fünf Tage.
Nach den offiziellen Plänen will IBM im Jahr 2027 zwei r3-Prozessoren zu einem Gesamtsystem mit 1.040 programmierbaren Qubits verschalten. Indem man unabhängig gekühlte Module synchron arbeiten lässt, umgeht man das Ausbeuterisiko riesiger Einzelchips. Erweist sich dieser Verbund in der Praxis als stabil, folgt die Skalierung von Quantenrechnern künftig der klaren Modularität moderner Blade-Server.
Jenseits der Labordemonstration: Der eigentliche Härtetest beginnt
Die Weiterentwicklung der Hardware erfordert auch den umfassenden Umbau der Software-Pipeline. IBM überarbeitete seine Cloud-Plattform, um Quantenprozessoren und klassische Supercomputer in einer einheitlichen Betriebsumgebung zusammenzuführen. Das japanische Forschungsinstitut RIKEN steigerte in dieser hybriden Umgebung die Geschwindigkeit von Diagonalisierungs-Workflows um etwa das Fünffache und vergrößerte das Rechenvolumen gleichzeitig um den Faktor 100. Die Cleveland Clinic automatisierte die Verarbeitung von 608 Millionen Messpunkten und senkte die Durchlaufzeit auf ein Dreißigstel.
Am 5. November 2026 startete IBM gemeinsam mit dem Oak Ridge National Laboratory und AMD eine Plattform zur koordinierten Quantenfehlerkorrektur. Indem man Nighthawk-Prozessoren und High-Performance-Computing-Cluster mit AMD Instinct MI355X-Beschleunigern im selben Rechenzentrum unterbrachte, soll die Latenz zwischen klassischer Dekodierung und dem Quantenchip auf physikalischer Ebene minimiert werden. Durch die Freigabe der Steuerung auf Pulsebene können Algorithmen-Entwickler die Mikrowellenimpulse direkt formen, um Rauscheffekte bereits an der physikalischen Basis zu unterdrücken.
In der Fachwelt überwiegt dennoch ein nüchterner Blick. Selbst wenn bei speziellen Simulationen magnetischer Materialien klare Geschwindigkeitsvorteile erzielt werden, bedeutet dies noch nicht den Durchbruch zum universellen Quantencomputer. IBM betont selbst, dass es sich bei den aktuellen Kennzahlen um Zwischenetappen handelt; die Schaltkreise und Messreihen wurden zur unabhängigen Überprüfung in der Open-Source-Community offengelegt. Physikalisches Rauschen und der immense Rechenaufwand für die Fehlerkorrektur bleiben für die gesamte Disziplin eine gewaltige Herausforderung.
Der Wettbewerb im Quantencomputing verabschiedet sich von oberflächlichen Zahlenspielen. Vor zehn Jahren konkurrierten die Akteure um die größte Qubit-Zahl auf Präsentationsfolien; heute entscheidet die Stoppuhr über Durchsatz und Rechengenauigkeit realer Schaltkreise. Indem sich die ingenieurtechnischen Maßstäbe endlich an der praktischen Anwendbarkeit ausrichten, zeichnet sich für diese Technologie nach Jahrzehnten der Skepsis ein realistischer Weg aus dem Labor in die industrielle Praxis ab.
Weiterführende Links:
- IBM Newsroom: IBM Unveils Quantum Nighthawk Processor
- ORNL News: Accelerating Materials Simulations on Quantum Hardware
- Algorithmiq Research: Benchmarking Quantum Simulation against Tensor Networks
- Quantum Advantage Tracker Community Database