Le 11 novembre 2026, à Yorktown Heights dans l’État de New York, IBM a levé le voile sur son processeur quantique de nouvelle génération, le Nighthawk r3. Plutôt que de revendiquer un record du nombre brut de qubits, l’annonce a posé un nouvel étalon d’ingénierie : exécuter de manière stable 10 000 opérations quantiques sur 520 qubits programmables. Les indicateurs remontés par les utilisateurs sont encore plus parlants : des partenaires tels qu’E.ON, Algorithmiq ou Q-CTRL ont déjà traité plus de 34 milliards de circuits sur la génération précédente, constatant des accélérations de calcul allant jusqu’à 19 fois.
Trente ans de scepticisme : la fin de la course effrénée aux qubits
Durant les trois dernières décennies, l’informatique quantique a souvent essuyé les railleries d’observateurs qui la disaient “éternellement à cinq ans d’aboutir”. Les constructeurs rivalisaient lors de keynotes pour afficher le plus grand nombre de qubits physiques, passant de quelques dizaines à plusieurs milliers. La réalité d’ingénierie demeurait bien plus cruelle : nombre de ces qubits physiques étaient si instables qu’ils ne pouvaient soutenir que quelques dizaines de portes logiques avant que la chaleur ambiante et le bruit thermique ne détruisent l’état quantique.
Cette frénésie du chiffre brut a longtemps fourvoyé les priorités technologiques du secteur. Un volume massif de qubits ne sert à rien si les calculs manquent de précision ou s’exécutent trop lentement pour quitter le laboratoire. Ce n’est qu’en recentrant les feuilles de route sur la vitesse d’exécution et la fidélité des portes que la technologie peut enfin franchir le pas entre démonstrations de tribune et production industrielle réelle.
Franchir le seuil industriel grâce à une profondeur de 10 000 opérations
La puce Nighthawk r3 intègre 2 034 éléments supraconducteurs physiques, mais n’en met que 520 à disposition des charges de travail externes sous forme de qubits programmables. Cet écart s’explique par une sélection drastique. À l’image d’un verger où, sur deux mille arbres plantés, seuls les cinq cents plus vigoureux sont retenus pour produire la récolte, les éléments physiques restants sont mobilisés pour absorber et neutraliser les erreurs matérielles transitoires.
La véritable rupture réside dans cette profondeur de calcul de 10 000 étapes. Dans la simulation de matériaux chimiques ou l’optimisation des réseaux électriques, les algorithmes nécessitent d’enchaîner des milliers de portes quantiques ; l’erreur s’accumule à chaque palier. Si un composant ne peut soutenir que quelques centaines d’opérations, disposer de dix mille qubits produira inévitablement des résultats erronés dès que la molécule étudiée présente un minimum de complexité.
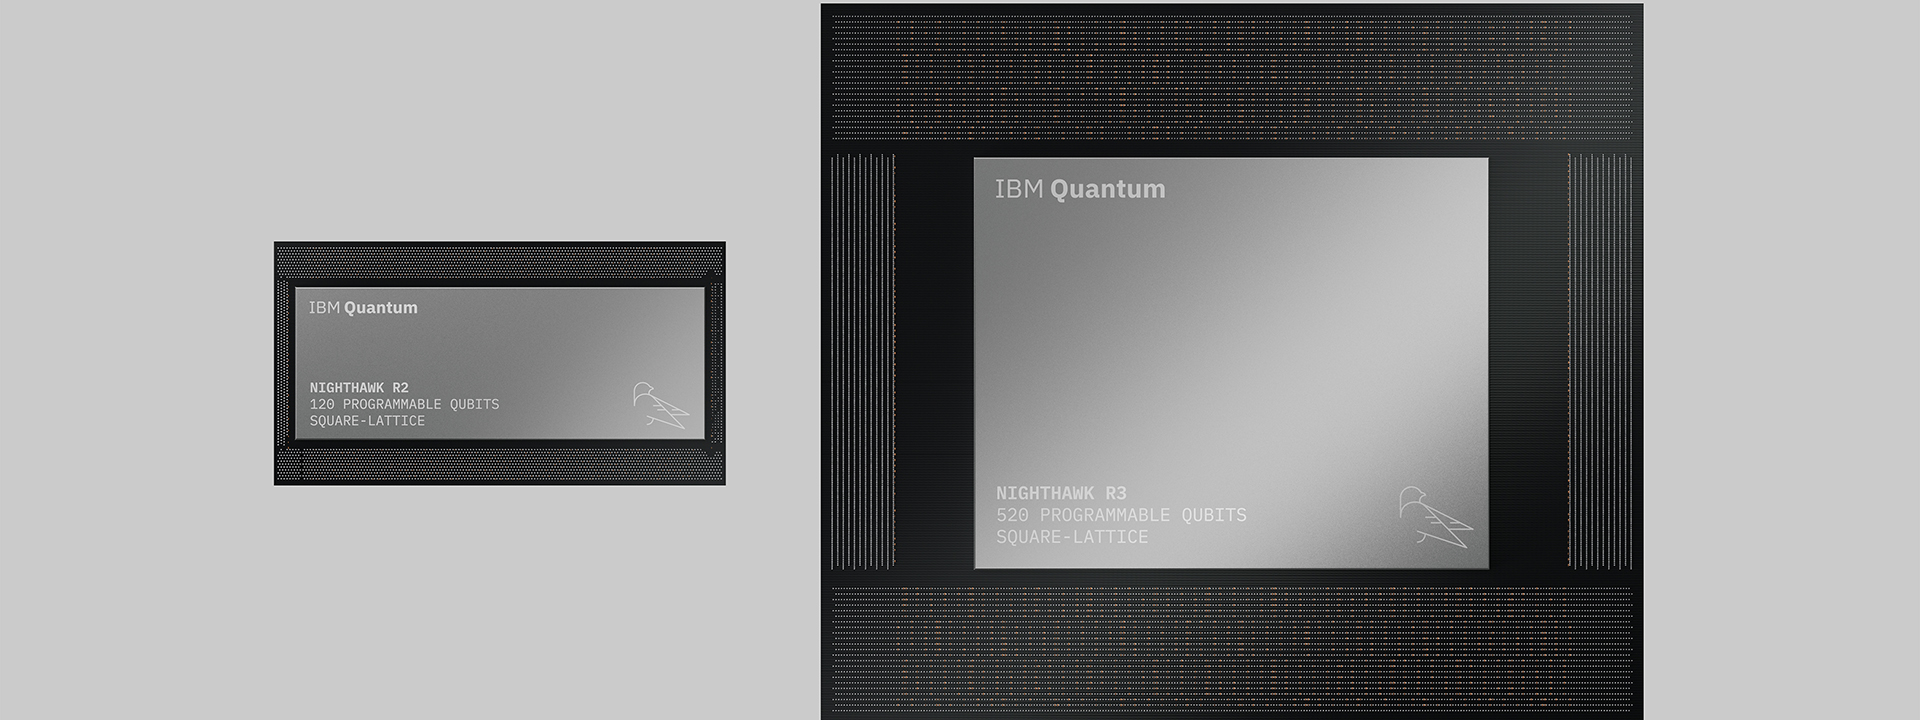 Figure : Rendu de la puce du processeur Nighthawk. La disposition en grille carrée optimise la connectivité entre qubits et raccourcit les lignes de routage. Source : IBM Newsroom
Le r3 conserve le réseau en maillage carré (square lattice) déjà éprouvé sur la génération précédente. Cette interconnexion dense réduit nettement les chemins de propagation des signaux et limite les interférences (crosstalk) entre qubits. En associant plus de 500 qubits à une profondeur de 10 000 portes logiques, les chercheurs peuvent simuler des réseaux cristallins réels directement au sein d’une unique puce quantique.
100 000 échantillons par seconde : des mois de calcul réduits à quelques heures
On imagine souvent qu’un ordinateur quantique fonctionne comme un ordinateur classique, délivrant une valeur déterministe d’une simple pression sur la touche Entrée. En réalité, le calcul quantique repose sur l’échantillonnage statistique. Les qubits évoluent en superposition, et chaque mesure produit un tirage probabiliste. Évaluer l’énergie de l’état fondamental d’une molécule complexe requiert de répéter le même circuit des millions, voire des milliards de fois.
Le processeur Nighthawk r2, actuellement en service, atteint déjà une cadence d’échantillonnage de 100 000 mesures par seconde. Les ingénieurs ont intégré des mécanismes de réinitialisation ultra-rapide (fast reset) pour éliminer les temps morts entre deux passages de circuit. Ce débit d’échantillonnage élevé est la condition sine qua non pour que des calculs statistiques massifs s’achèvent dans des délais opérationnels viables.
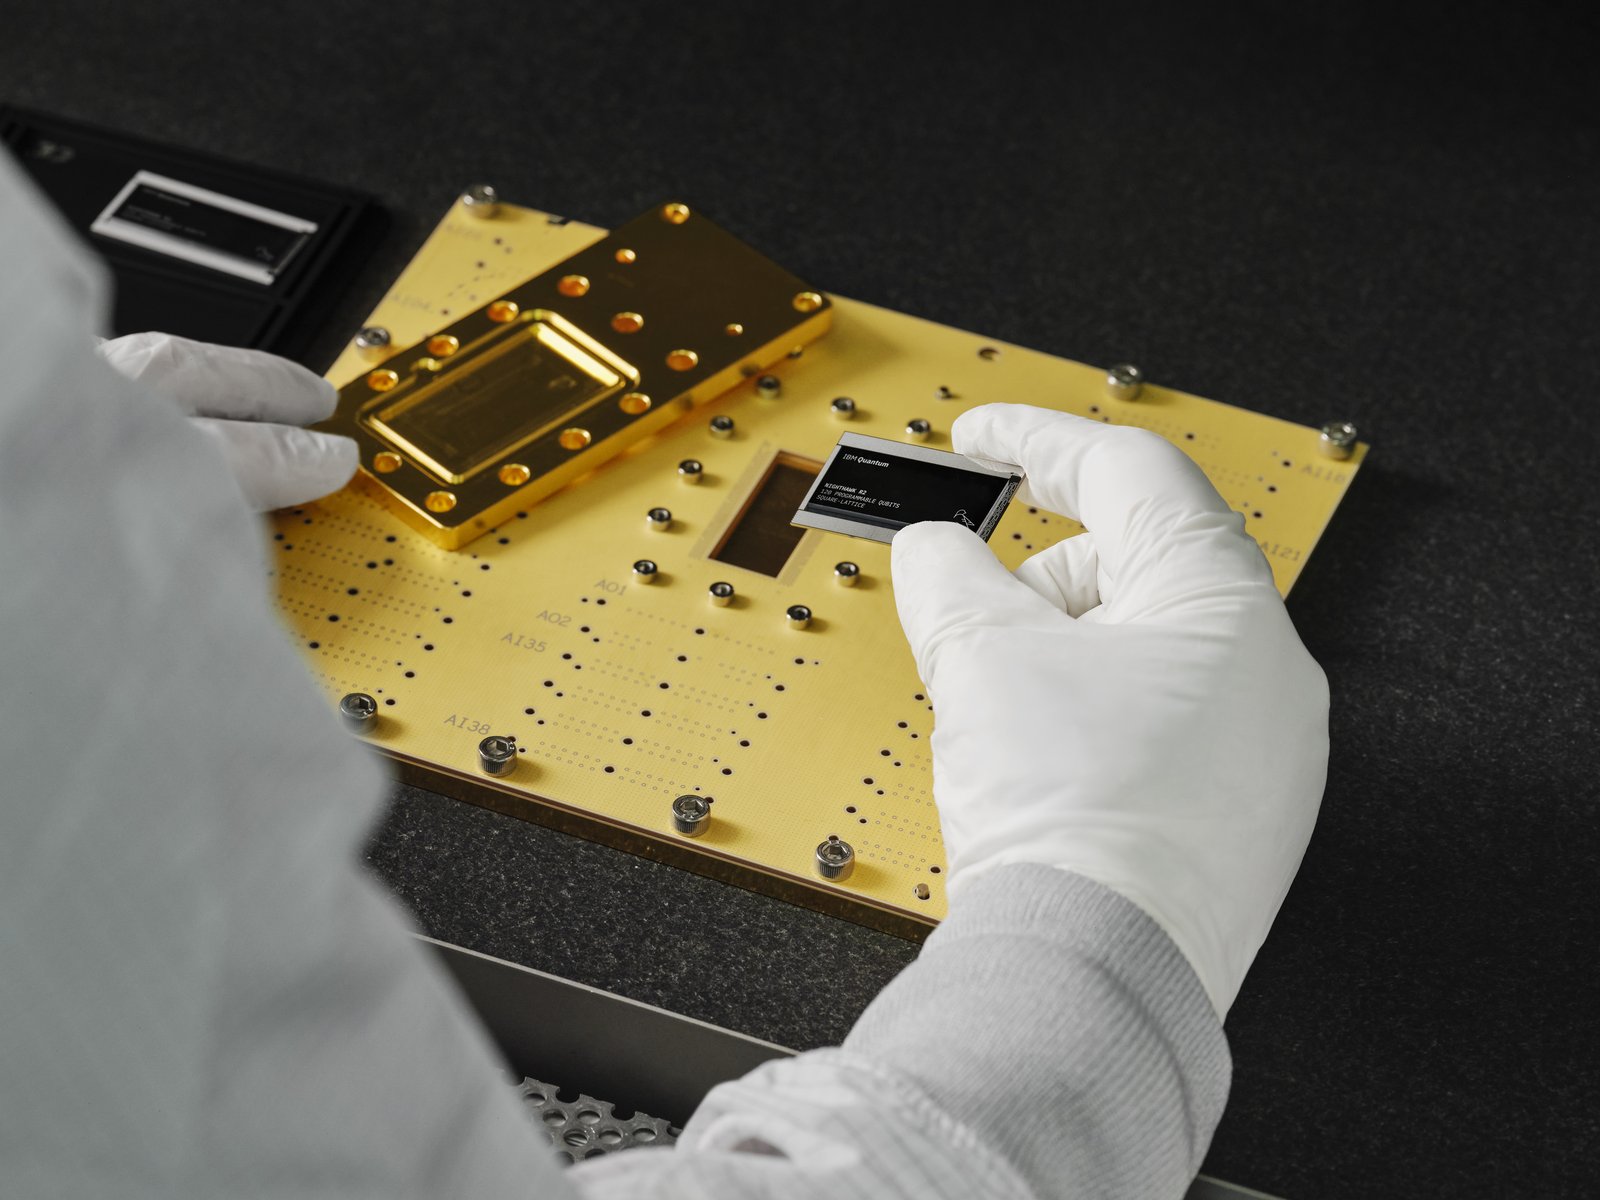 Figure : Le processeur Nighthawk r2 tenu en main. La puce fonctionne dans un réfrigérateur à dilution à 15 millikelvins. Source : IBM Newsroom
Le géant européen de l’énergie E.ON et l’éditeur Algorithmiq ont déjà exécuté 34 milliards de circuits sur la puce r2. E.ON a enregistré une accélération de 15 fois dans des tâches d’apprentissage automatique quantique appliquées à la gestion de réseau électrique. Le Laboratoire national d’Oak Ridge (ORNL) a modélisé des matériaux magnétiques réels en divisant le temps de calcul par douze par rapport à la génération antérieure, les résultats simulés reproduisant parfaitement les mesures issues d’expériences de diffusion de neutrons.
Algorithmiq a de son côté multiplié par huit la vitesse d’exécution de ses simulations de matériaux après migration sur la nouvelle puce. Pour parvenir à un niveau de précision identique sur un supercalculateur classique avec des algorithmes de réseaux de tenseurs de pointe, il faudrait, selon leurs estimations, multiplier la mémoire vive requise par 240. L’explosion de la mémoire classique face à l’intrication quantique à N corps constitue le fondement physique de l’avantage quantique dans ces domaines spécifiques.
Dix ponts d’interconnexion : franchir le cap des 1 000 qubits en 2027
La surface d’une puce supraconductrice ne peut pas être étendue indéfiniment. Dès lors que l’on dépasse le millier de qubits physiques, la densité des câbles coaxiaux induit une charge thermique insoutenable, et le moindre défaut de fabrication ruine le rendement de tranches entières de silicium. L’approche monolithique ayant touché ses limites physiques, l’interconnexion modulaire de chiplets s’impose comme la seule trajectoire viable.
IBM a ainsi disposé en bordure de la puce r3 dix ponts d’interconnexion quantique baptisés “l-couplers”. Lors de validations préliminaires, l’équipe a relié deux composants de première génération par quatre lignes de liaison, atteignant une fidélité de transfert d’état de 99,3 %. En août 2026, deux modules cryogéniques distincts ont été raccordés au sein d’une même installation ; il a fallu moins de cinq jours pour faire chuter leur température de l’ambiante jusqu’aux 15 millikelvins requis.
Selon la feuille de route d’IBM, deux puces r3 seront assemblées en 2027 pour former un système unifié de 1 040 qubits programmables. Coordonner plusieurs puces refroidies de manière modulaire écarte le risque d’effondrement des rendements de fabrication. Si cette approche s’avère concluante à grande échelle, le dimensionnement des calculateurs quantiques adoptera une logique aussi claire que celle des serveurs lames actuels.
Au-delà de la démonstration : le véritable défi industriel s’ouvre
Le saut qualitatif du matériel implique une refonte globale de la chaîne logicielle. IBM a mis à niveau sa plateforme cloud afin de faire cohabiter processeurs quantiques et supercalculateurs classiques au sein d’un environnement unifié. L’institut de recherche japonais RIKEN a exploité cette infrastructure hybride pour quintupler la vitesse de traitement de flux de diagonalisation exacte, tout en multipliant le volume de calcul par 100. La Cleveland Clinic a quant à elle automatisé le traitement de 608 millions d’échantillons, réduisant le temps d’exécution d’un facteur trente.
Le 5 novembre 2026, IBM a officialisé un partenariat avec le Laboratoire national d’Oak Ridge et AMD pour lancer une plateforme collaborative de correction d’erreurs quantiques. En installant les processeurs Nighthawk et un cluster de calcul accéléré par des puces AMD Instinct MI355X dans la même salle des machines, l’objectif est d’éliminer les temps de latence physique entre le décodage classique et la puce quantique. L’ouverture du contrôle au niveau des impulsions permet par ailleurs aux concepteurs d’algorithmes de moduler directement la forme des micro-ondes pour étouffer le bruit à la source.
La prudence reste de mise dans la communauté scientifique. Mettre en évidence un avantage de calcul sur la simulation de matériaux magnétiques ciblés ne signifie pas qu’un ordinateur quantique universel et tolérant aux pannes soit déjà né. IBM admet elle-même que les performances actuelles constituent des jalons d’étape, et l’ensemble des circuits et données de référence a été versé à la communauté open source pour contre-expertise. Le bruit physique et le coût en calcul de la correction d’erreurs demeurent des verrous majeurs pour l’ensemble des chercheurs.
La compétition quantique s’émancipe enfin des chiffres d’illusion. Il y a dix ans, chacun se mesurait au nombre de qubits affichés sur des diapositives ; désormais, la confrontation se joue chronomètre en main sur le débit des circuits et la fidélité des mesures. En alignant ses objectifs sur l’utilité concrète, cette technologie de pointe s’offre une voie tangible pour quitter l’enceinte des laboratoires.
Références :
- IBM Newsroom: IBM Unveils Quantum Nighthawk Processor
- ORNL News: Accelerating Materials Simulations on Quantum Hardware
- Algorithmiq Research: Benchmarking Quantum Simulation against Tensor Networks
- Quantum Advantage Tracker Community Database