2026년 11월 11일, IBM은 미국 뉴욕주 요크타운 하이츠에서 차세대 양자 프로세서인 나이트호크 r3(Nighthawk r3)를 발표했다. 이번 공개는 단순한 큐비트 총수 기록 경신 대신 완전히 새로운 엔지니어링 지표를 전면에 내세웠다. 520개의 프로그래밍 가능한 양자 큐비트 위에서 1만 회의 양자 연산을 안정적으로 연속 수행하는 실력이다. 고객 측에서 보고된 수치는 더욱 주목할 만하다. E.ON, Algorithmiq, Q-CTRL 등 외부 파트너들은 이전 세대 칩에서 이미 340억 개 이상의 회로를 실행했으며, 최대 19배에 달하는 작업 가속을 달성했다고 보고했다.
30년간의 냉소와 큐비트 숫자 경쟁의 종말
지난 30년 동안 양자 컴퓨팅 산업은 ‘실용화까지는 늘 5년 남았다’는 비아냥을 받아왔다. 하드웨어 제조사들은 신제품 발표회마다 누가 더 많은 물리적 큐비트를 탑재했는지 수십 개에서 수천 개로 숫자를 부풀리며 경쟁했다. 그러나 현실은 냉정했다. 대다수 물리 큐비트는 너무나 취약하여 수십 번의 게이트 연산조차 버티지 못하고 외부 열과 환경 노이즈에 의해 양자 상태가 무너져 내렸다.
큐비트 숫자만을 늘리려는 집착은 오랫동안 업계의 기술 개발 방향을 왜곡시켰다. 큐비트가 아무리 많아도 계산이 부정확하고 속도가 느리다면 연구실의 시연 장치에 머무를 수밖에 없다. 로드맵의 초점을 단순한 큐비트 수량에서 실행 속도와 연산 정밀도로 전환해야만 기술이 무대 위 시연을 넘어 실제 산업 현장으로 나아갈 수 있다.
1만 회 연속 연산 깊이로 산업화 문턱을 넘어서다
나이트호크 r3 프로세서 전체에는 2,034개의 초전도 물리 소자가 집적되어 있지만, 외부 연산 작업에 개방되는 것은 엄격히 선별된 520개의 프로그래밍 가능 큐비트뿐이다. 이러한 차이는 철저한 엔지니어링 선별 과정에서 비롯된다. 과수원에 2천여 그루의 나무를 심어 철저한 건강 검진을 통과한 건강한 500여 그루만 열매를 맺게 하고, 나머지 소자들은 순간적으로 발생하는 하드웨어 오류를 흡수하고 완화하는 역할을 맡는 것과 같다.
진정한 기술적 도약은 1만 회 연산이라는 회로 깊이에 있다. 화학 재료 시뮬레이션이나 복잡한 전력망 최적화 알고리즘에서는 수천 개의 양자 논리 게이트를 연속 실행해야 하며, 연산 깊이가 깊어질수록 오류가 누적된다. 프로세서가 수백 단계의 연산밖에 버티지 못한다면, 설령 1만 개의 큐비트를 보유하고 있더라도 조금만 복잡한 분자 구조를 계산하는 순간 오류투성이 결과를 내놓게 된다.
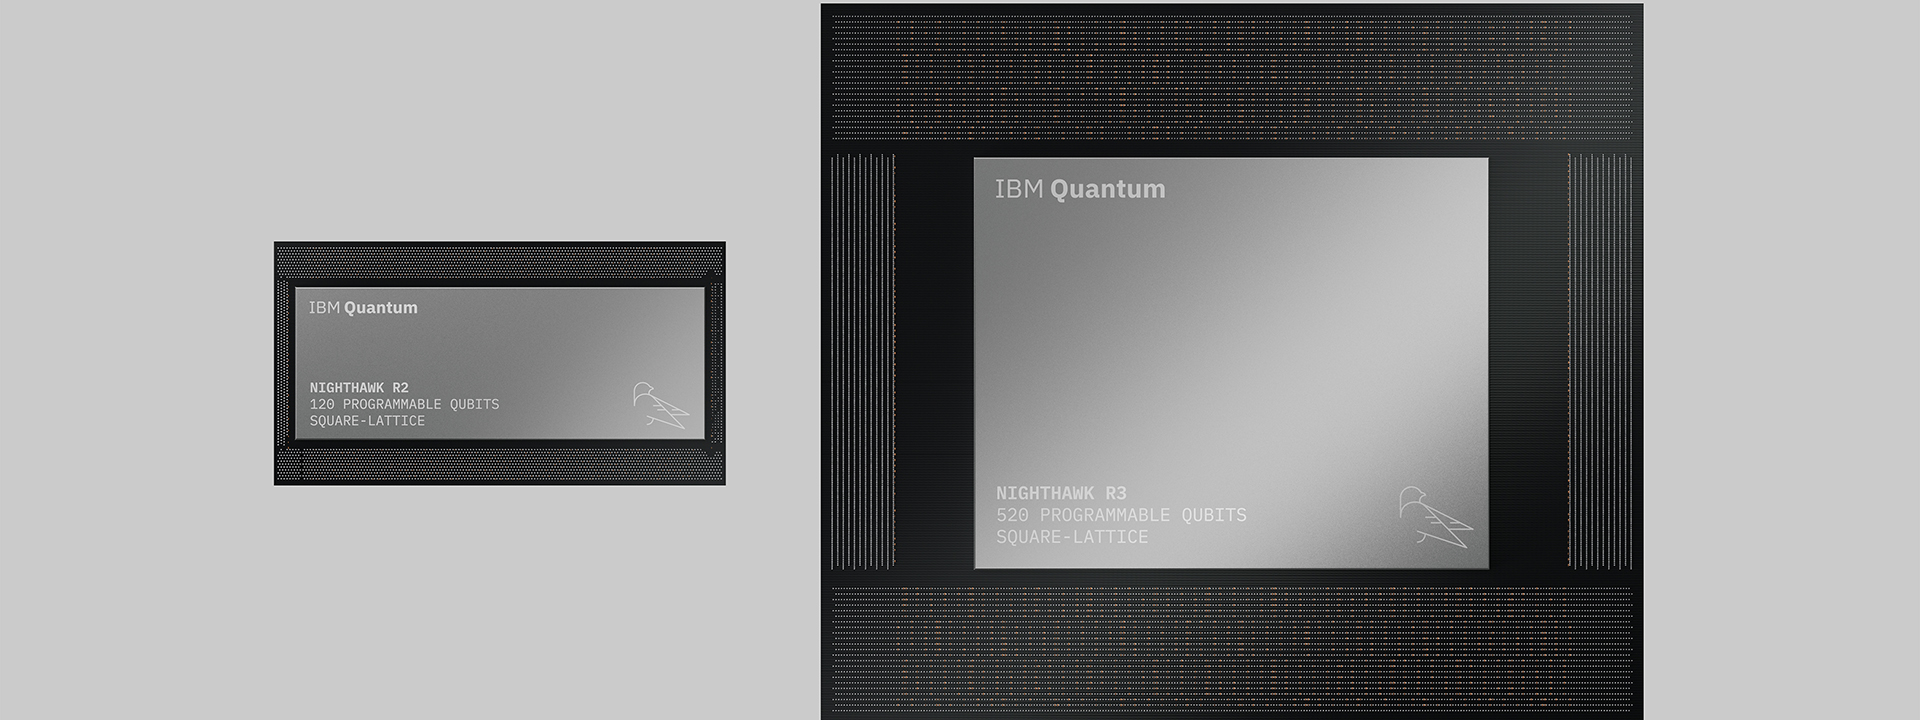 그림: Nighthawk 프로세서 칩 렌더링 이미지. 정사각형 격자 배열 구조를 통해 큐비트 간 연결성을 높이고 신호 전송 경로를 단축했다. 출처: IBM Newsroom
r3는 이전 세대 프로세서의 정사각형 격자(Square-lattice) 배열을 계승했다. 이처럼 밀접한 상호 연결 구조는 신호 전송 경로를 획기적으로 단축해 큐비트 간 간섭(크로스토크)을 억제한다. 500개 이상의 큐비트와 1만 단계의 회로 깊이가 결합되면서, 연구자들은 단일 칩 위에서 실제 물리 격자 모델을 모사하는 시뮬레이션 연산을 수행할 수 있게 되었다.
초당 10만 회 샘플링: 몇 달의 연산을 몇 시간으로 단축
일반 컴퓨터처럼 엔터 키 한 번을 누르면 확정적인 결괏값이 바로 계산되어 나오는 것으로 양자 컴퓨터를 오해하기 쉽다. 하지만 현실의 양자 컴퓨팅은 통계적 샘플링에 의존한다. 큐비트는 중첩 상태에서 변화하며, 매 측정마다 확률에 따른 표본 하나를 출력한다. 복잡한 분자의 바닥 상태 에너지를 정확히 계산해내려면 동일한 양자 회로를 수백만 번에서 수십억 번 반복 실행해야 한다.
현재 서비스 중인 나이트호크 r2는 샘플링 속도를 이미 초당 10만 회 수준까지 끌어올렸다. 연구개발팀은 초고속 리셋 기술을 도입하여 각 회로 실행이 완료된 후 발생하는 대기 시간을 극적으로 단축했다. 샘플링 처리 속도가 대폭 향상되어야만 수백만에서 수십억 회의 반복 연산을 요하는 통계 작업을 현실적인 시간 안에 완료할 수 있다.
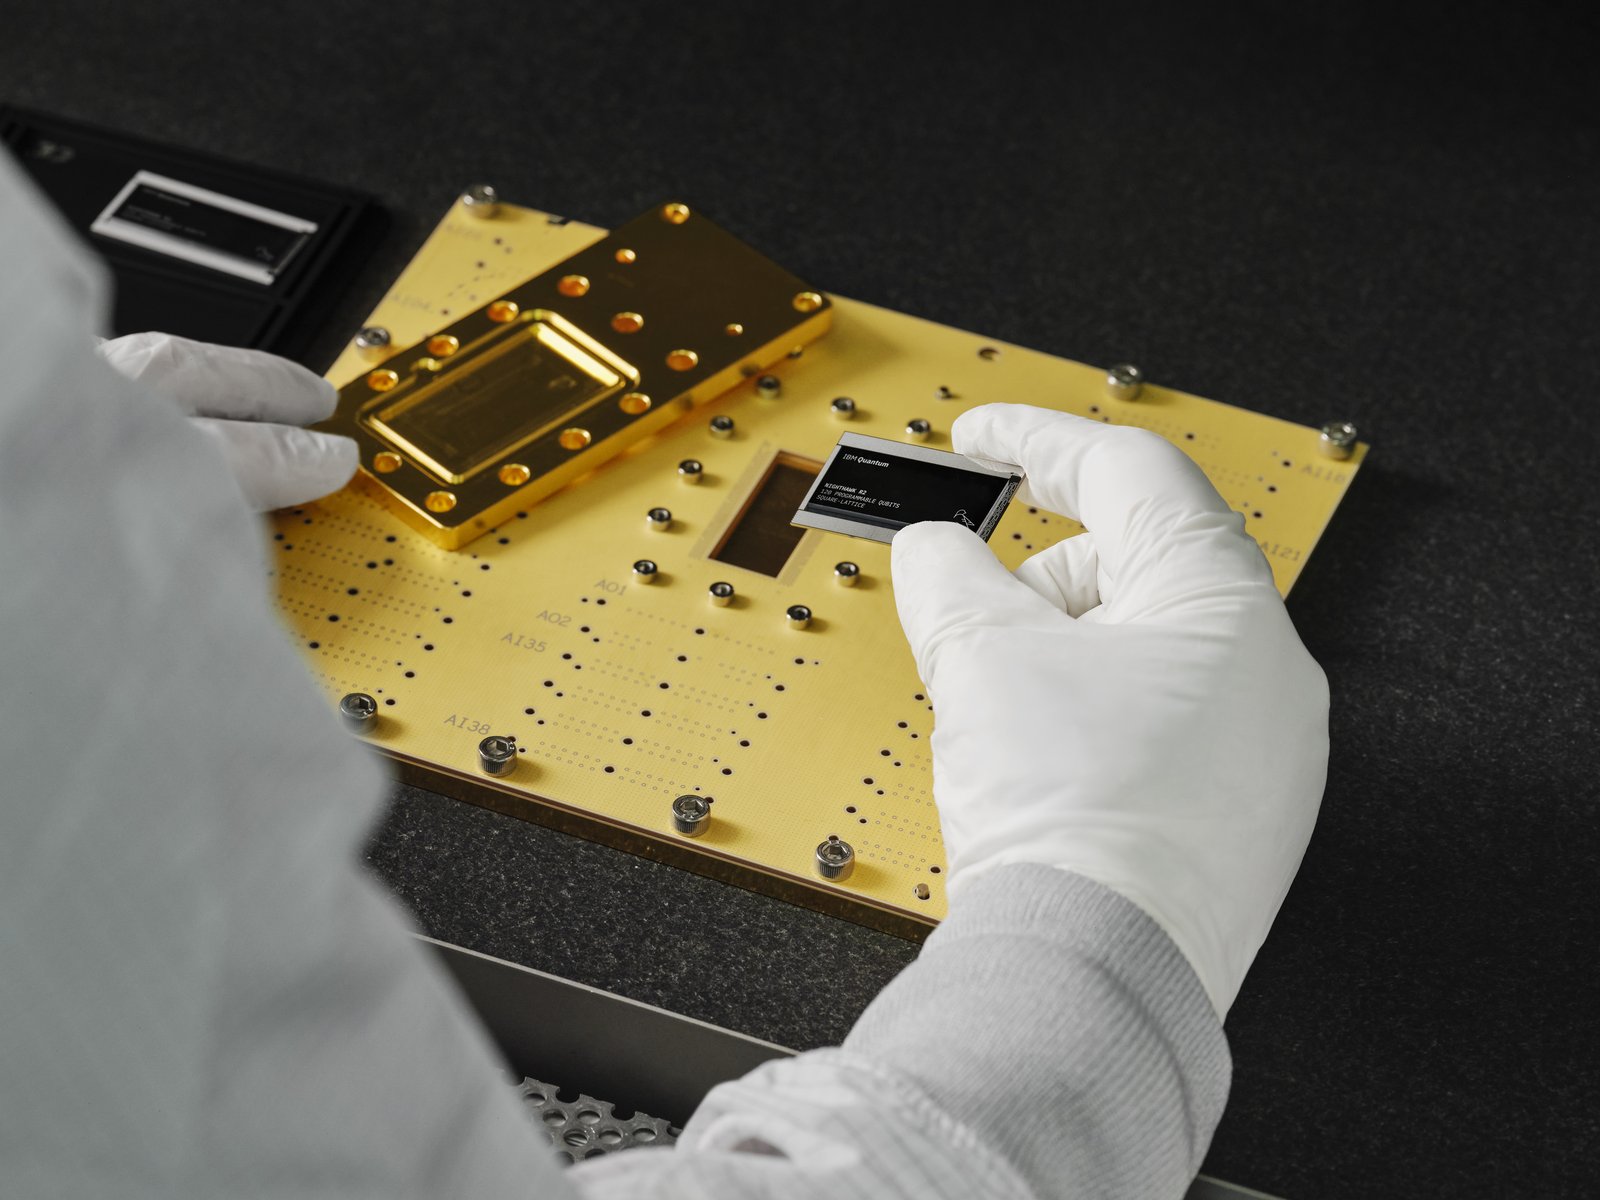 사진: 손으로 들어 보인 Nighthawk r2 프로세서 실물. 칩은 15밀리켈빈 극저온 환경에서 동작한다. 출처: IBM Newsroom
유럽 에너지 대기업인 E.ON과 양자 소프트웨어 전문 기업 Algorithmiq 등 외부 기관들은 r2 칩에서 누적 340억 회의 회로를 실행했다. E.ON은 전력망 최적화를 위한 양자 머신러닝 작업에서 15배의 처리 가속을 기록했다. 오크리지 국립연구소(ORNL)는 이 시스템을 활용해 실제 자성 재료를 시뮬레이션하며 이전 세대 대비 연산 시간을 12분의 1로 단축했고, 시뮬레이션 데이터는 중성자 산란 실험의 실제 측정값과 완벽히 일치했다.
Algorithmiq는 재료 시뮬레이션을 신형 칩으로 이전한 후 회로 실행 속도가 기존 대비 8배 빨라졌다고 밝혔다. 기존 슈퍼컴퓨터에서 최신 텐서 네트워크 알고리즘을 사용해 동일한 정밀도를 달성하려면 약 240배에 달하는 메모리가 필요한 것으로 추산된다. 다체 양자 얽힘을 고전 하드웨어에서 모사할 때 발생하는 이러한 메모리 폭발 현상이야말로 양자 프로세서가 특정 영역에서 우위를 발휘하는 물리적 근거다.
10개의 인터커넥트로 칩을 결합, 2027년 1,000큐비트 돌파 목표
단일 초전도 칩의 물리적 면적을 무한정 늘리는 데는 한계가 있다. 물리 큐비트 수가 수천 개를 넘어가면 촘촘한 동축 케이블이 엄청난 열 부하를 유발하고, 미세한 제조 결함 하나가 웨이퍼 전체 수율을 망쳐버린다. 단일 칩 크기를 키우는 방식은 이미 엔지니어링 한계에 부딪혔으며, 칩렛 모듈러 방식의 결합이 유일한 해법으로 부상했다.
IBM은 r3 칩 가장자리에 ‘l-커플러(l-coupler)‘라 불리는 10개의 양자 상호 연결 브리지를 배치했다. 초기 개념 검증 단계에서는 4개의 상호 연결 라인으로 1세대 칩 두 개를 연결해 99.3%의 양자 상태 전송 충실도를 입증했다. 2026년 8월에는 독립된 두 개의 극저온 냉각 모듈을 하나로 결합하여 전원 공급부터 작동 온도인 15밀리켈빈 극저온에 도달하기까지 단 5일도 걸리지 않았다.
공식 로드맵에 따르면 IBM은 2027년에 두 개의 r3 칩을 결합해 총 1,040개의 프로그래밍 가능 큐비트를 갖춘 통합 시스템을 구축할 계획이다. 별도로 냉각된 다중 칩을 결합해 협력 연산을 수행함으로써 대형 단일 칩의 수율 붕괴 위험을 피할 수 있다. 이 결합 방식이 성공적으로 검증된다면 양자 컴퓨터의 확장 방식은 현대 블레이드 서버처럼 명확한 모듈식 구조를 갖추게 된다.
연구실 시연을 넘어: 진짜 엔지니어링 승부가 시작되다
하드웨어 성능 향상은 소프트웨어 파이프라인의 전면적 개편과 맞물려 있다. IBM은 클라우드 양자 런타임을 업그레이드하여 양자 칩과 고성능 슈퍼컴퓨터를 동일한 관리 환경에 통합했다. 일본 이화학연구소(RIKEN)는 이 협업 환경을 통해 특정 대각화 작업 흐름 속도를 약 5배 높이면서 계산 규모를 100배로 확장했다. 클리블랜드 클리닉은 6억 800만 개의 샘플 처리를 자동화하여 작업 시간을 기존의 30분의 1로 줄였다.
2026년 11월 5일, IBM은 오크리지 국립연구소 및 AMD와 협력하여 양자 오류 정정 협력 플랫폼을 공식 출범했다. 나이트호크 프로세서와 AMD Instinct MI355X GPU 기반 고성능 클러스터를 같은 전산실 내에 배치하여 실시간 고전 오류 정정 제어와 양자 칩 간의 물리적 전송 지연을 최소화하려는 시도다. 또한 펄스 수준의 제어 권한을 개방함으로써 알고리즘 설계자가 마이크로파 펄스 파형을 직접 미세 조정하여 물리 계층에서 노이즈를 억제할 수 있도록 지원한다.
학계의 냉철한 시각 역시 여전하다. 특정 자성 재료 시뮬레이션에서 가속 능력을 입증했다고 해서 범용 양자 컴퓨터가 당장 완성된 것은 아니다. IBM 역시 공개된 수치가 중간 단계의 설계 목표임을 인정하며 회로와 벤치마크 데이터를 오픈소스 커뮤니티에 전면 공개해 검증받고 있다. 물리적 잡음 제어와 오류 정정에 수반되는 막대한 연산 비용은 여전히 모든 연구자가 풀어야 할 과제다.
양자 컴퓨팅 경쟁은 허황된 숫자 부풀리기에서 점차 벗어나고 있다. 10년 전에는 발표 슬라이드에 적힌 큐비트 숫자만을 다투었지만, 이제는 스톱워치 앞에서 회로가 얼마나 빠르고 정확하게 돌아가는지를 겨룬다. 엔지니어링 지표의 초점이 실질적인 효용성과 연산 완성도로 옮겨갈 때, 수십 년간 의구심을 받아온 최첨단 기술은 비로소 연구실을 벗어나 산업 현장으로 향하는 확실한 경로를 개척하게 될 것이다.
참고 링크:
- IBM Newsroom: IBM Unveils Quantum Nighthawk Processor
- ORNL News: Accelerating Materials Simulations on Quantum Hardware
- Algorithmiq Research: Benchmarking Quantum Simulation against Tensor Networks
- Quantum Advantage Tracker Community Database