2026 年 11 月 11 日,IBM 在纽约州约克敦高地公布了下一代量子处理器 Nighthawk r3。这次发布没有刷新比特总数的纪录,拿出的是一组新的工程指标:在 520 个可编程量子比特上稳定执行一万次量子操作。同日给出的客户侧数字更值得看:E.ON、Algorithmiq、Q-CTRL 已经在上一代芯片上跑了 340 多亿个电路,报告的加速比最高 19 倍。
嘲弄了三十年,行业承认只堆比特没用
过去三十年里,量子计算行业总被同行嘲弄为「永远还要五年」。厂商们热衷于在发布会上比拼谁的物理比特更多,从几十个一路飙升到上千个。现实却格外尴尬:很多物理比特一碰就散架,连几十次运算都坚持不住,整台机器就被外界的热量和噪声冲毁。
只堆比特数量的狂热,把整个行业的技术重心带偏了很久。比特再多,算不准也跑不快,就只能留在实验室里做演示。路线图的重心从追求比特数量转向衡量速度与精度,技术才可能从舞台演示迈进真实生产。
连跑一万次操作,算力才跨过工业门槛
Nighthawk r3 整块芯片制造了 2,034 个超导物理单元,但最终开放给外部调用的只有 520 个可编程量子比特。两者的差距来自工程筛选。就像果园里种下两千多棵树,最终只有五百多棵通过健康检验、承担结果任务,其余的要用来吃掉转瞬即逝的误差。
真正的突破在于这一万次操作的深度。在化学材料模拟和复杂的电网调度中,算法需要连续执行几千道量子逻辑门,步数稍深就会积累误差。如果芯片只能支撑几百步操作,哪怕拥有一万个比特,遇到稍大一点的分子结构也会迅速得出错误结果。
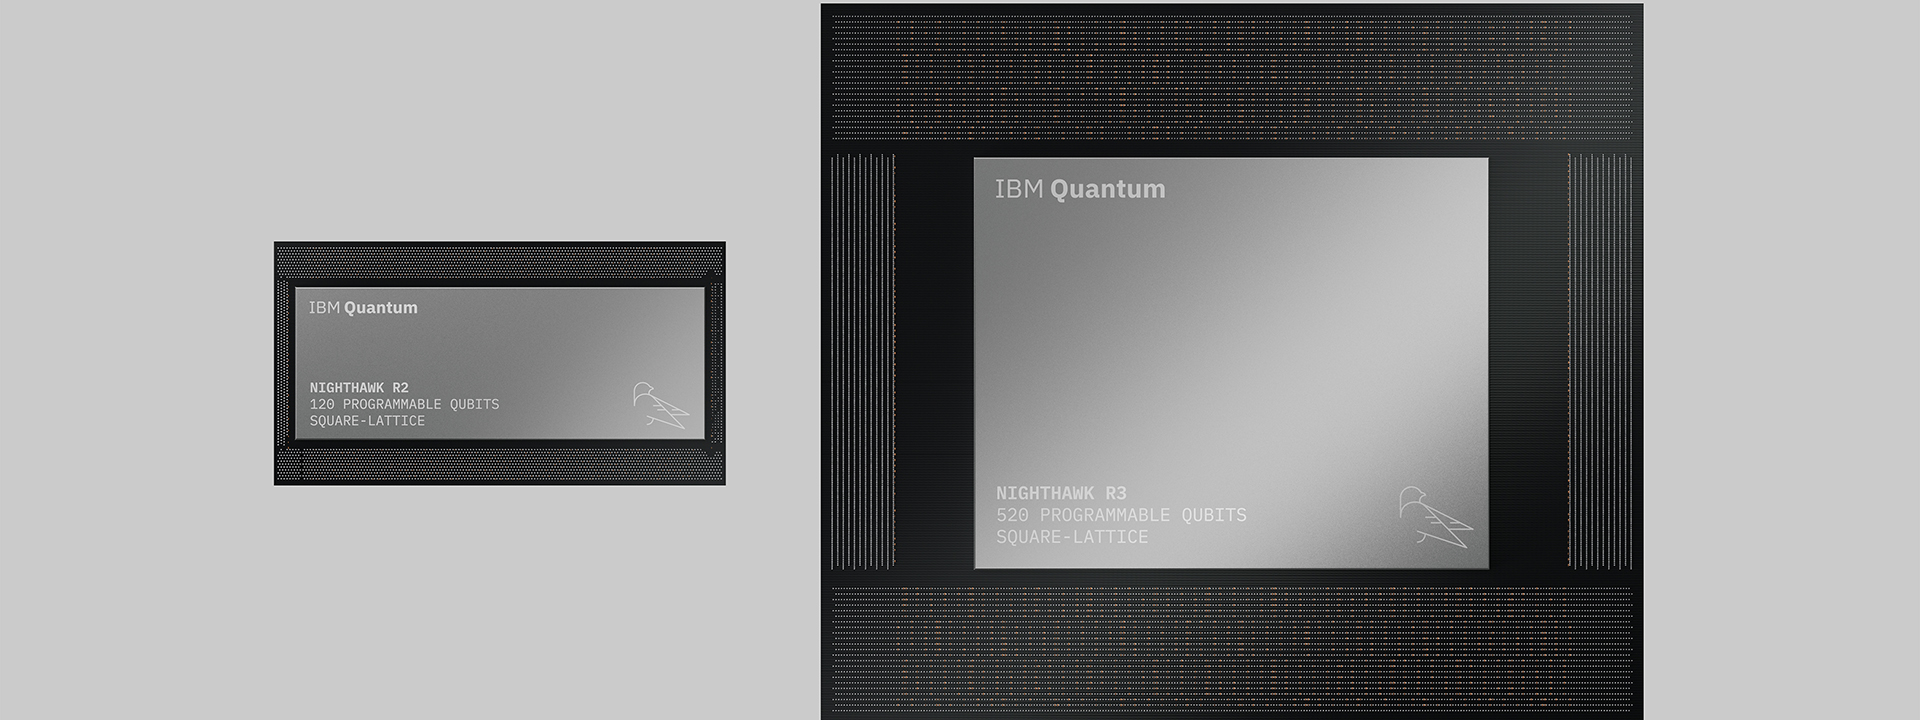 图:Nighthawk 处理器芯片渲染图。方格阵列结构提升了比特间连通性,缩短操作路径。来源:IBM Newsroom
r3 延续了上一代处理器的方形晶格布局。这种紧密的互联让信号传输路径显著缩短,降低了比特之间的干扰。五百多个比特配合一万步深度,研究人员能在同一块芯片上跑真实物理晶格的模拟计算。
每秒采样十万次,把几个月压缩进几小时
很多人以为量子计算像传统电脑一样,按一次回车就能吐出精确数字。现实中量子计算依靠统计采样。量子比特在叠加状态下演化,每次测量只落下一个由概率决定的测量样本。要摸清复杂分子的基态能量,通常需要重复运行几百万到几十亿次相同的电路。
现役的 Nighthawk r2 已经将采样速度推到了每秒 10 万次。研发团队通过高速重置技术,压缩了每个电路执行完毕后的等待间隙。采样速度上去了,需要数百万到数十亿次重复的统计任务才谈得上在可接受的时间里跑完。
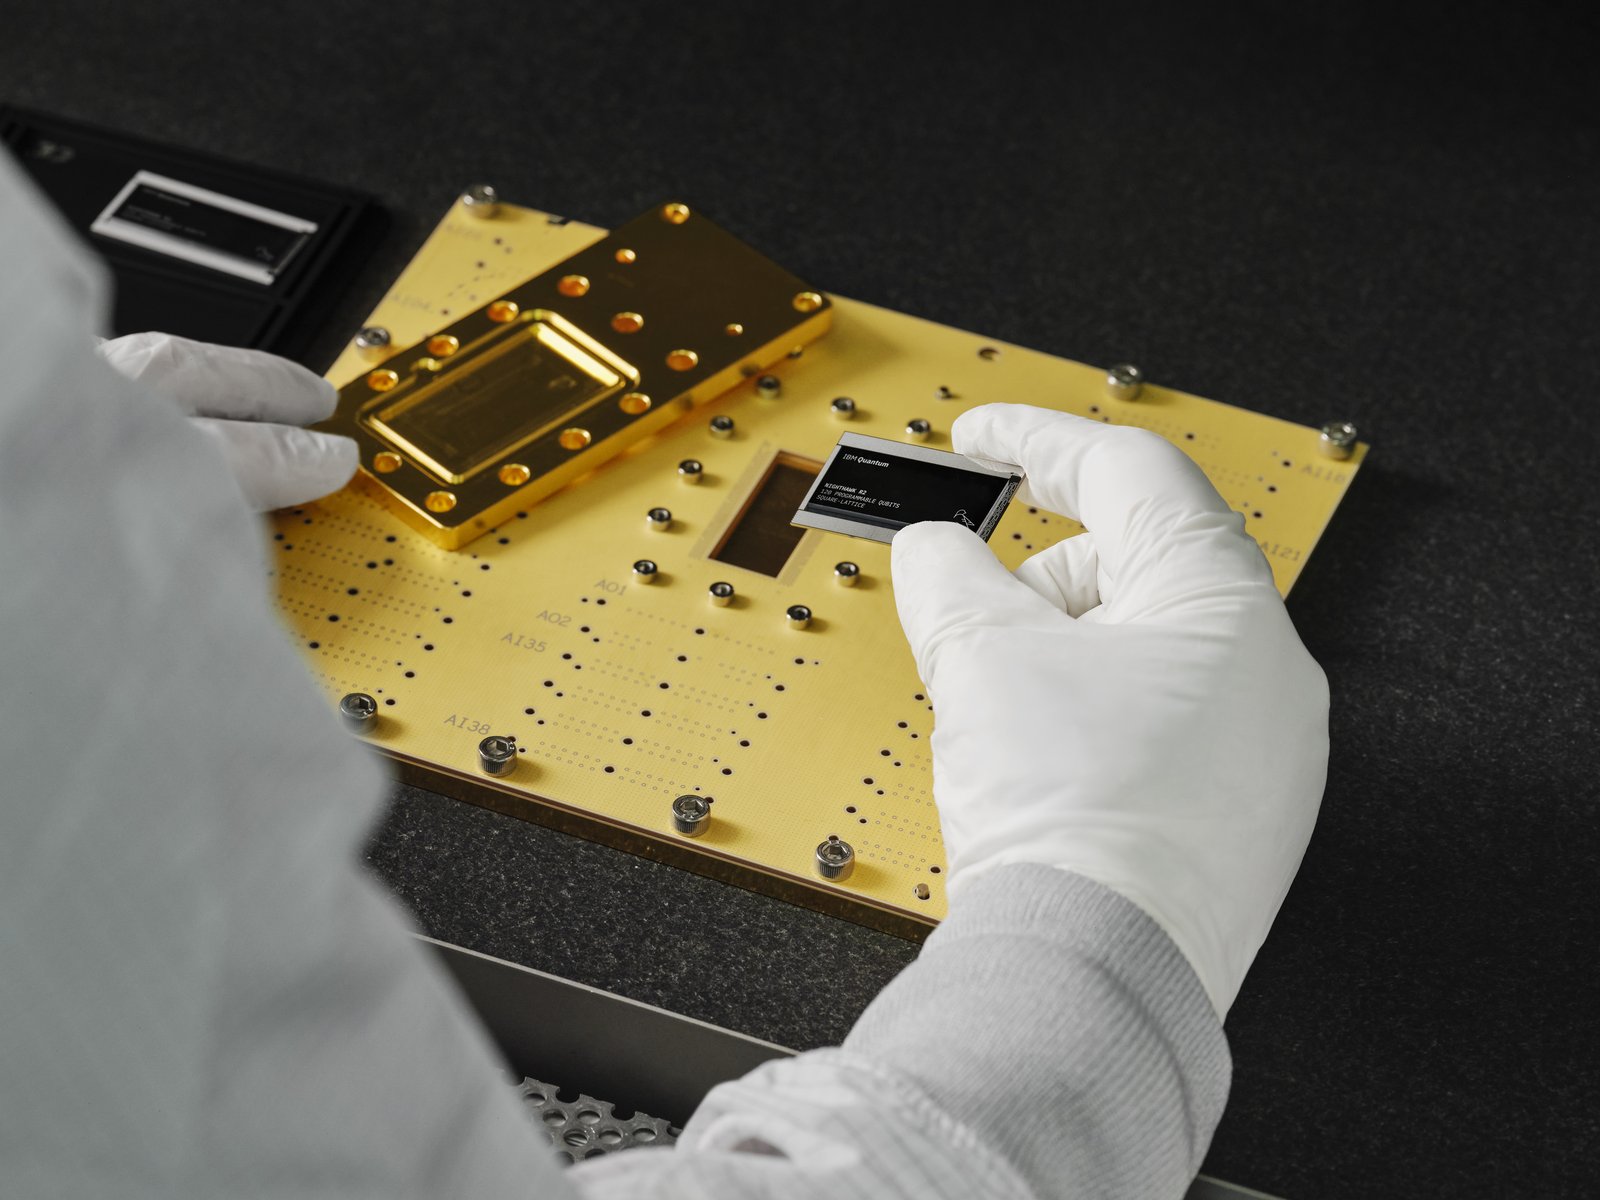 图:手持展示的 Nighthawk r2 处理器实物。芯片需置于 15 毫开尔文低温环境工作。来源:IBM Newsroom
欧洲能源巨头 E.ON 与软件商 Algorithmiq 等外部机构已经在 r2 上累计执行了 340 亿个电路。E.ON 在电网优化的量子机器学习任务中测得了 15 倍的加速。橡树岭国家实验室利用这套系统模拟真实磁性材料,运算耗时缩短到前代芯片的十二分之一,模拟数据与中子散射实验的实际读数完全吻合。
Algorithmiq 将材料模拟迁移到新芯片后,电路执行速度提高到原来的 8 倍。如果换用传统超级计算机运行领先的张量网络算法,要达到相同精度,推算需要 240 倍的内存开销。经典硬件在模拟多体纠缠时的内存爆炸,正是量子处理器在特定领域展现算力优势的物理基础。
用十根互联线拼接,双芯片要在2027年破千
单颗超导芯片的物理面积无法无限做大。当物理比特数量突破上千,密密麻麻的同轴电缆会带来巨大的热负荷,微小的制造缺陷也会毁掉整块晶圆。死磕单芯片尺寸已经撞上了工程天花板,模块化拼接成了必经之路。
IBM 在 r3 边缘装配了 10 根名为 l-coupler 的量子互联桥。在更早的概念验证中,工程团队用 4 根互联线连接了两颗第一代芯片,量子态传输保真度达到 99.3%。2026 年 8 月,两个独立的制冷模块成功连成一体,从通电启动到降温进入 15 毫开尔文的绝对低温,只耗费了不到 5 天时间。
按照既定规划,IBM 准备在 2027 年把两颗 r3 芯片拼装成一台拥有 1,040 个可编程比特的整机系统。将多块独立冷冻的芯片拼在一起协同运算,避开了单芯片良率崩塌的陷阱。这种拼装方式如果验证成功,量子计算机扩展规模的逻辑就会变得和现代刀片服务器一样清晰。
走出实验室演示,真正的硬仗才刚打响
硬件指标的提升离不开软件流水线的改造。IBM 更新了云端量子平台,将量子芯片与经典超级计算机塞进同一个托管环境。日本理化学研究所利用这套协同环境把特定对角化工作流的速度提升约 5 倍,同时把计算量做大了 100 倍。克利夫兰诊所自动处理了 6.08 亿个样本,流水线自动化把耗时缩减到原本的三十分之一。
2026 年 11 月 5 日,IBM 进一步联合橡树岭国家实验室与 AMD 启动了量子纠错协同平台。他们把 Nighthawk 处理器与搭载 MI355X 显卡的高性能集群放在同一机房内,试图在物理层面缩短经典纠错控制与量子芯片之间的传输延迟。开放脉冲级控制权,让算法专家可以直接微调微波脉冲的形状,从物理层寻找压低噪声的路径。
学术界的冷静审视依然存在。即便在特定磁性材料模拟中展现出速度优势,这并不意味着通用量子计算机已经诞生。IBM 也承认当前公布的指标属于阶段性设计目标,电路与测试数据全部挂在开源社区接受检验。物理噪声与纠错带来的算力开销,依然是横亘在所有从业者面前的现实难题。
量子计算的竞争正在告别虚假的数字狂欢。十年前大家比拼谁的 PPT 上比特数字更大,如今大家在秒表前比拼谁的电路跑得更快、算得更准。当工程指标的焦点真正落在可用性上,这项被调侃了数十年的前沿技术,才算找到了走出实验室的真实路径。
参考链接:
- IBM Newsroom: IBM Unveils Quantum Nighthawk Processor
- ORNL News: Accelerating Materials Simulations on Quantum Hardware
- Algorithmiq Research: Benchmarking Quantum Simulation against Tensor Networks
- Quantum Advantage Tracker Community Database