Deux barrettes grand public de 32 Go de mémoire vive sont en passe de remplacer les cartes accélératrices professionnelles à plusieurs dizaines de milliers d’euros pour animer des modèles géants de 284 milliards de paramètres. Publié le 4 novembre 2026, le projet open source llama-modchip v2.4.0 est parvenu à faire tenir l’empreinte opérationnelle complète de DeepSeek-V4-Flash dans 64 Go de RAM physique. Pour la première fois, un simple ordinateur de bureau sans aucune carte graphique dédiée exécute de manière stable un réseau de type Mixture-of-Experts (MoE) de plusieurs centaines de milliards de paramètres.
Ce mode de déploiement redéfinit en profondeur les règles matérielles de l’IA locale. Jusqu’à présent, faire tourner localement les modèles de pointe imposait l’achat de cartes de calcul spécialisées dotées d’une réserve colossale de mémoire VRAM. Les algorithmes de quantification à très faible précision réduisent drastiquement l’encombrement des paramètres : il suffit désormais de garnir les emplacements mémoire de sa carte mère pour franchir le seuil des modèles à cent milliards de paramètres.
20 Go d’empreinte effacés : 56,56 GiB de poids logés dans 64 Go de RAM
DeepSeek-V4-Flash compte 284,33B de paramètres au total, répartis sur 43 couches d’attention latente multi-têtes (MLA) et 256 experts routés, activant 13,17B de paramètres à chaque token généré. Avec la méthode officielle standard de quantification UD-IQ1_S, le fichier du modèle atteint 76,87 GiB. Sur une machine Linux standard équipée de 64 Go de mémoire brute, la mémoire réellement disponible après déduction du système d’exploitation ne dépasse guère 62,5 GiB.
Face à cet excédent, toute tentative de déploiement classique se heurte à une défaillance immédiate. Le processus est impitoyablement stoppé par le mécanisme OOM Killer du noyau Linux, ou s’enlise dans une pagination massive vers la mémoire virtuelle sur disque (swap), anéantissant toute vitesse d’exécution. Dès lors que la mémoire physique sature, les échanges constants de pages bloquent l’inférence du processeur.
Pour contourner ce verrou, llama-modchip applique une technique propriétaire de quantification SwiGLU-H2 basée sur le Hessien du second ordre, couplée à un format de tenseurs sur mesure baptisé Fractal-64. Cette méthode ramène la précision moyenne à 3,75 bpw, abaissant la taille des poids de 76,87 GiB à seulement 56,56 GiB. Cette cure d’amaigrissement de 20,31 GiB (une réduction de 26,4 %) fait glisser le modèle juste sous la ligne de flottaison de la mémoire physique disponible.
Même avec une configuration à contexte long de 256K tokens, la mémoire résidente du processus (VmRSS) reste contenue à 57,61 GiB. Sur les 64 Go physiques, une marge de sécurité d’environ 6,4 Go demeure disponible, garantissant une exécution exempte de tout recours au swap et sans aucune saturation du disque NVMe. Libérée des lectures disques, l’architecture sur CPU pur maintient un flux de calcul stable en s’appuyant uniquement sur la mémoire centrale.
Zéro GPU, 9 à 14 tokens par seconde : le décodage auto-spéculatif offre un débit exploitable
La configuration matérielle mise en œuvre ne comporte aucune carte d’accélération spécifique : elle repose sur un ordinateur de bureau standard animé par un processeur AMD Ryzen 9 9955HX. Reposant sur l’architecture Zen 5 à 16 cœurs, ce CPU prend en charge l’intégralité des multiplications tensorielles via ses jeux d’instructions vectorielles natifs. En phase de décodage pur, la cadence de génération se maintient entre 9,06 et 9,95 tokens par seconde.
Afin de dépasser les contraintes de latence inhérentes au calcul sur processeur, le projet intègre l’algorithme de décodage auto-spéculatif Stockfish-PVS. En s’appuyant sur des branches de prédiction légères pour supprimer les opérations matricielles superflues, le débit réel de décodage grimpe entre 11,5 et 14,7 tokens par seconde. Cette vitesse franchit largement le seuil de confort nécessaire pour la lecture humaine et l’exécution d’outils via des agents en terminal.
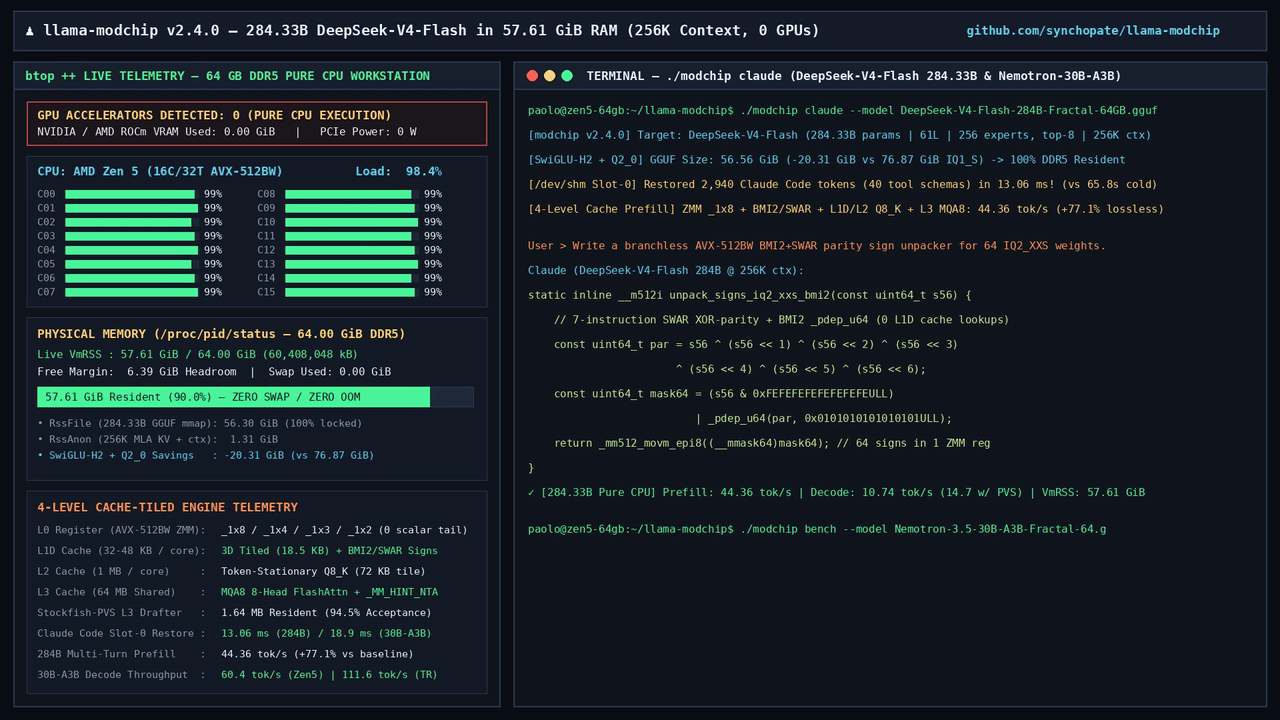 Figure : Un modèle de 284B paramètres exécutant des flux d’Agent en terminal sur un ordinateur de 64 Go de RAM. Source : dépôts d’actifs de llama-modchip
En revanche, la phase de pré-remplissage des invites (prefill) met en évidence les limites de puissance pure du processeur. Le débit actuel de prefill s’établit entre 43,16 et 44,36 tokens par seconde, marquant une hausse de 77 % par rapport aux 25 tokens/s de la mouture précédente. Cependant, face à une invite dense de 10 000 tokens, l’utilisateur doit patienter environ 225 secondes avant de voir s’afficher le tout premier caractère.
Ces données tracent précisément le champ d’application d’un déploiement 100 % CPU. Il ne peut prétendre répondre à de fortes concurrences de requêtes ni à des services exigeant des démarrages à froid instantanés. Mais pour un usage individuel, quelques minutes de chargement initial représentent un compromis tout à fait acceptable pour maîtriser intégralement et chez soi un modèle de plusieurs centaines de milliards de paramètres.
Le palier 30B ramené à 16 Go : une alternative taillée pour les PC portables
Au-delà de la prise en charge du modèle phare de 284B, le projet propose une optimisation adaptée aux architectures plus compactes. Pour le modèle Nemotron-3.5-30B-A3B, le fichier quantifié est ramené à 14,35 GiB. Un tel volume permet de le faire tourner sans encombre sur des ordinateurs portables grand public dotés de 16 à 32 Go de mémoire vive.
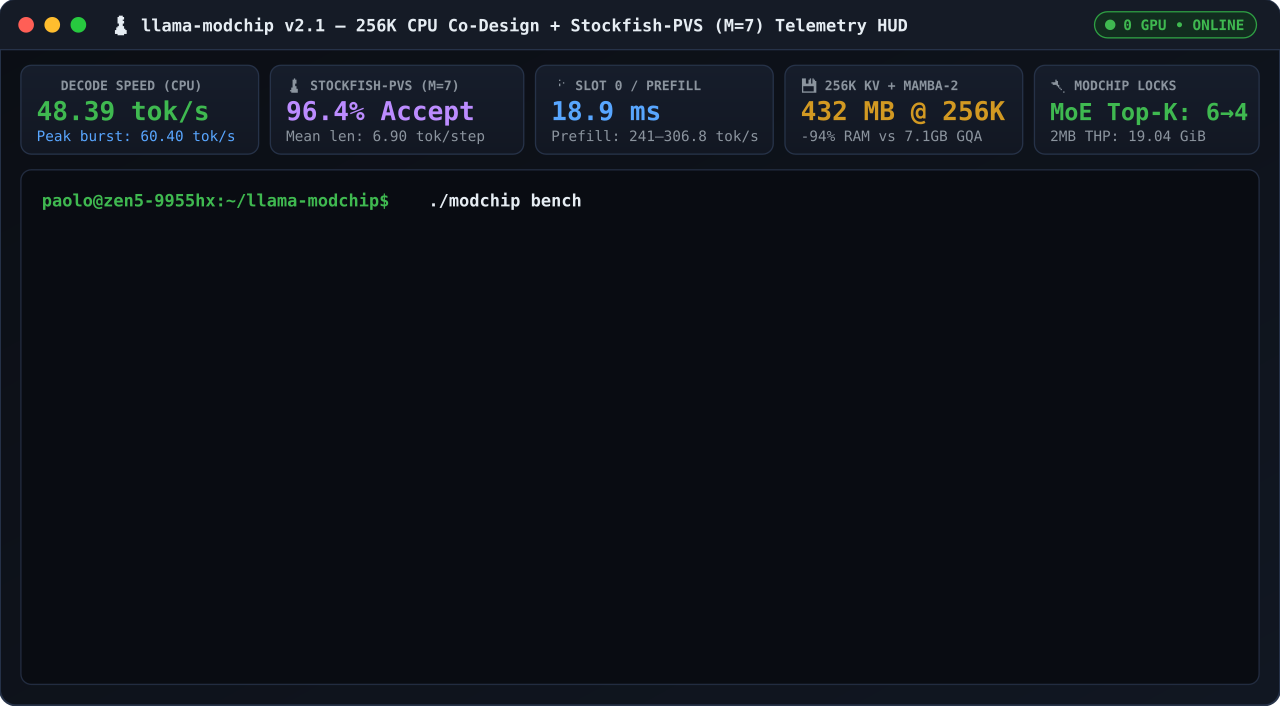 Figure : Procédure de configuration et de chargement du modèle dans le terminal llama-modchip. Source : dépôt llama-modchip assets/modchip_demo.svg
Associé à de la mémoire DDR grand public en double canal, le débit de décodage du modèle 30B oscille entre 25 et 111 tokens par seconde. Les tests de référence menés par l’équipe ont validé l’ensemble des critères de qualité avec le score maximal. Ce format réduit conjugué à un débit rapide renforce significativement la valeur pratique des modèles intermédiaires hors ligne.
La quantification ultra-poussée s’affirme comme une brique d’infrastructure incontournable pour l’IA embarquée et locale. Les méthodes de compression éprouvées sur les modèles géants s’adaptent désormais aux appareils de milieu de gamme, offrant aux petites équipes dépourvues de cartes graphiques haut de gamme des options d’inférence locale particulièrement souples.
Tenseurs propriétaires et repères de qualité : l’épreuve du feu pour la quantification extrême
L’abaissement spectaculaire des barrières d’accès matériel s’accompagne de contreparties au niveau de la compatibilité logicielle. Le format Fractal-64 introduit un identifiant de tenseur propriétaire (type ID 40). Toute tentative d’ouverture de ces fichiers avec les versions officielles de llama.cpp, Ollama ou LM Studio se solde par un message d’erreur. Les développeurs doivent obligatoirement compiler les utilitaires à partir de la branche spécifique du projet pour lancer leurs calculs.
La mesure de la dégradation de précision suscite également des discussions au sein de la communauté technique. Les repères d’évaluation publiés par le projet se limitent à une comparaison avec la variante IQ2_XXS, sans confrontation directe avec les sorties non quantifiées en pleine précision FP16. Plusieurs contributeurs sur Hacker News soulignent que la version de 97 Go en Q2_XXS présente déjà des divergences perceptibles par rapport aux résultats d’origine.
L’empreinte mémoire du cache KV sur les contextes longs constitue un autre facteur limitant. Pour conserver l’intégralité d’un cache KV non quantifié sur des fenêtres maximales, la machine devrait embarquer environ 150 Go de mémoire vive. De surcroît, les bancs d’essai montrent qu’en dehors d’une phase de prefill légèrement accélérée sur les modèles 30B, le comportement en décodage standard reste très proche de l’implémentation de base.
Le stockage l’emporte sur l’accélération : refonte du modèle économique de l’IA de pointe
L’écart vertigineux des coûts d’acquisition matérielle justifie l’engouement suscité par cette démarche. Assembler une infrastructure dédiée de calcul GPU capable d’héberger un modèle de 284B représente un investissement de plusieurs dizaines de milliers de dollars. En comparaison, le coût d’un ordinateur de bureau équipé de 64 Go de RAM se situe un ordre de grandeur plus bas.
Les tokens issus d’une quantification extrême locale ne sauraient évidemment rivaliser avec les débits et la finesse de calcul d’une grappe de serveurs GPU dans le cloud : leurs domaines de latence et d’usage sont totalement différents. L’intérêt fondamental de la solution locale n’est pas de supplanter les infrastructures distantes, mais de fournir un socle d’exécution fiable et totalement affranchi des cartes accélératrices.
Le centre de gravité du matériel dédié à l’IA glisse progressivement de la puissance brute de calcul des GPU vers la capacité mémoire globale du système. Tant que les barrettes de RAM peuvent accueillir les poids statiques compressés, des nœuds purement CPU suffisent à soutenir l’inférence de réseaux MoE colossaux. Voir un modèle de 284 milliards de paramètres débiter du texte de manière fluide sur une machine ordinaire consacre une avancée décisive vers une IA souveraine, économique et accessible.
Liens de référence :
- Documentation technique et article de quantification du projet open source llama-modchip
- Rapport technique sur l’architecture Mixture-of-Experts de DeepSeek-V4-Flash
- Discussion de la communauté Hacker News sur le déploiement local de modèles 100B+ sur processeur