两根随处可见的 32GB 内存条,正在取代单价数万元的专用显卡,成为驱动 2840 亿参数大模型的支点。2026 年 11 月 4 日发布的开源项目 llama-modchip v2.4.0,把 DeepSeek-V4-Flash 的整机运行要求压进了 64GB 内存。一台没有独立 GPU 的普通台式机,第一次平稳跑起了千亿级混合专家网络。
这种部署方式改变了大模型落地的硬件规则。长期以来,开发者在本地运行前沿模型,必须采购高规格的专用计算卡。超低位量化算法压缩了参数存储开销。开发者只要插满主板内存插槽,就能跨过千亿模型的硬件门槛。
削减20GB冗余:56.56GiB权重挤进64GB内存
DeepSeek-V4-Flash 拥有 284.33B 总参数,包含 43 层多头潜变量注意力(MLA)与 256 个路由专家,每次推理激活 13.17B 参数。按照官方标准的 UD-IQ1_S 量化方案,模型检查点体积达到 76.87 GiB。一台标称 64GB 内存的 Linux 设备,扣除系统开销后,可用内存通常只有 62.5 GiB 左右。
面对超额的体积,标准部署方案只能面临系统崩溃。进程会因为超出配额被内核直接杀死,或者跌入磁盘虚拟内存交换,导致计算陷入严重迟滞。在内存不足的环境下,频繁页面置换会让处理器推理陷入停顿。
llama-modchip 采用自研的 SwiGLU-H2 二阶 Hessian 量化技术,结合自定义的 Fractal-64 格式重写了张量结构。这套方案将参数平均位宽压制到 3.75 bpw,使权重体积从 76.87 GiB 缩减到 56.56 GiB。整体权重削减了 20.31 GiB,降幅达到 26.4%,模型刚好滑进物理内存的安全线内。
在 256K 的长上下文配置下,运行进程的物理常驻内存(VmRSS)被控制在 57.61 GiB。整机 64GB 物理内存因此留出了大约 6.4 GiB 的缓冲余量,达成了零虚拟内存换页与零 NVMe 读盘。纯处理器架构避开磁盘读写后,依靠主内存即可维持平稳计算。
零显卡输出9到14字:自投机解码换来可用吞吐
这套系统的硬件载体没有任何专用计算卡,只是一台搭载 AMD Ryzen 9 9955HX 处理器的普通整机。这款处理器基于 16 核 Zen 5 架构,依靠纯 CPU 指令集完成所有张量乘法运算。在纯解码阶段,系统输出速度维持在每秒 9.06 到 9.95 个 token。
为了突破纯 CPU 计算的延迟限制,项目引入了 Stockfish-PVS 自投机解码算法。算法通过轻量预测分支减少冗余计算,将实际解码吞吐提升至每秒 11.5 到 14.7 个 token。这个输出速度已经跨过了人类阅读与工具调用的体验门槛。
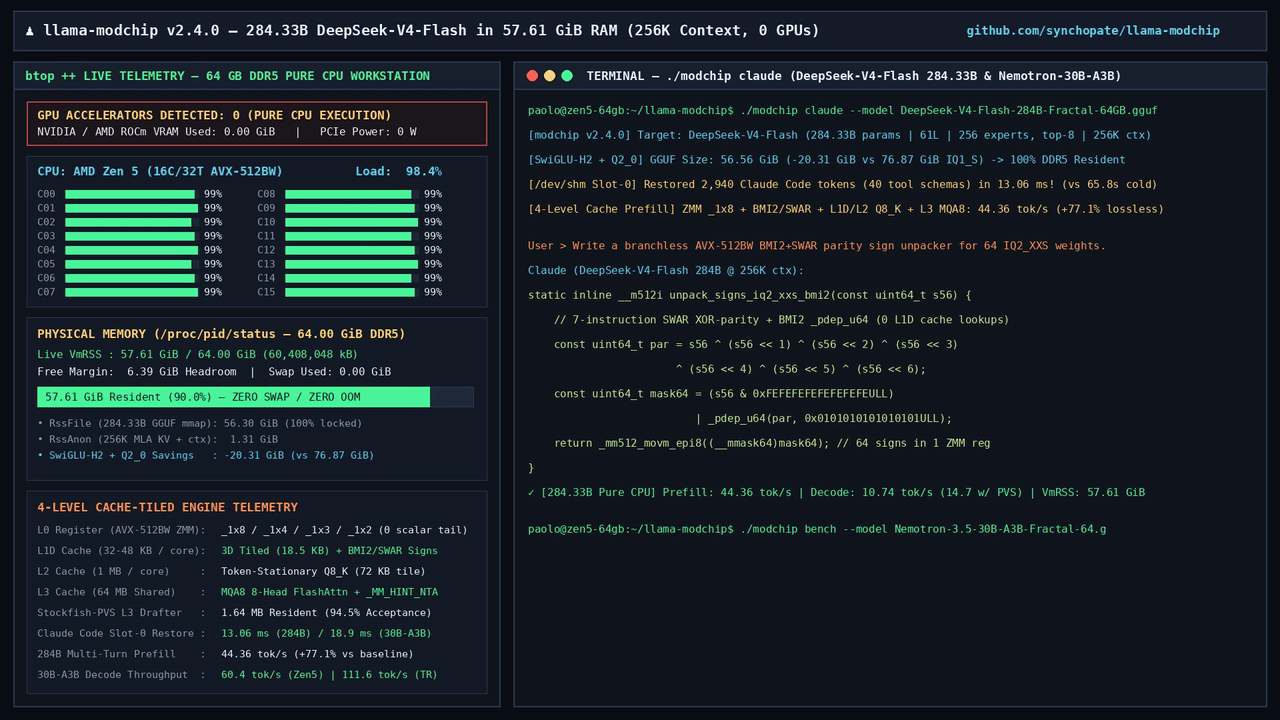 图:284B 参数模型在 64GB 内存整机上运行终端 Agent 任务。来源:llama-modchip 仓库 assets
输入提示词的预填充阶段暴露出明显的算力延迟。当前版本的预填充速度为每秒 43.16 到 44.36 个 token,相比上一版本的每秒 25 个 token 提升了 77%。面对一个 1 万 token 的长篇提示词,用户需要等待大约 225 秒才能看到首个字符出现。
这种性能特征划定了纯 CPU 部署的适用边界。它无法承担高并发请求或频繁冷启动的在线交互。但对单人任务而言,几分钟启动换来的是千亿参数的本地掌控权。
30B档下探16GB:小规格模型建立第二梯队
除了驱动 284B 的大型网络,该项目还为中小规格模型开辟了适配空间。针对 Nemotron-3.5-30B-A3B 模型,量化转码后的检查点体积压缩到了 14.35 GiB。这一体积让配置有 16GB 到 32GB 内存的主流笔记本获得了运行能力。
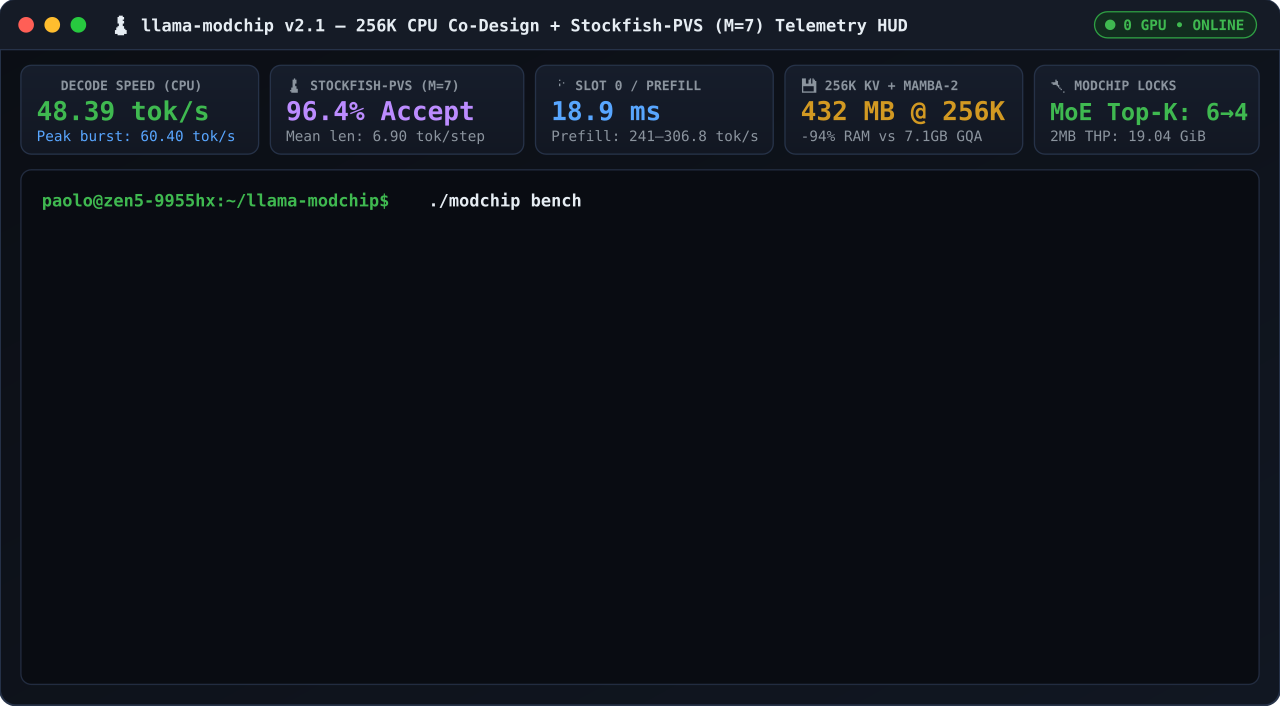 图:llama-modchip 终端一键配置与模型加载流程。来源:llama-modchip 仓库 assets/modchip_demo.svg
在普通的消费级双通道内存下,30B 模型的解码吞吐达到每秒 25 到 111 个 token。项目方在基准评测中给出了满分质量门判定。高速输出配合紧凑体积,让中等模型展现出更灵活的离线实用性。
低位量化策略正在演变为通用的端侧基建。它将超大规模网络中验证的压缩逻辑,平移到了中端硬件更容易承接的规格上。缺乏高端计算卡的小型团队,因此有了阶梯式的本地算力选项。
自定义张量与基准参照:超低位量化面临真实检验
硬件门槛的大幅降低带来了生态兼容的代价。Fractal-64 格式引入了专属的张量类型编号 40(type ID 40)。使用官方原版 llama.cpp、Ollama 或 LM Studio 读取此类权重文件时,软件会直接报错退出。使用者必须依赖项目专有分支编译的二进制工具,才能启动推理。
精度折损的衡量方式同样引发了技术社区的讨论。项目宣称的质量基准仅以 IQ2_XXS 版本为参考,并未对比 FP16 全精度基线。社区开发者指出,97GB 版本的 Q2_XXS 模型与全精度输出已有明显分歧。
长文本缓存开销进一步推高了实际部署门槛。若要完整保留未量化的 KV cache,整机内存需要达到 150GB 左右。测试表明,30B 模型除预填充略快外,常规解码表现与原版差别不大。
算力硬件让位存储容量:千亿推理成本结构重构
设备采购成本的断层对比展示出该方案的吸引力。组建一套容纳 284B 模型的专业 GPU 集群,硬件投入动辄数以万美元计。配置 64GB 内存的普通整机,采购成本足足低了一个数量级。
本地超低位量化产出的 token 无法与云端旗舰集群的输出等同。两者的推理精细度与响应延迟处于不同维度。本地部署的核心价值是提供无卡运行底座,并非替代云端集群。
大模型的硬件重心正在从显卡算力转向整机内存。只要内存条装得下压缩后的静态权重,纯 CPU 节点就能承载千亿 MoE 网络的推理运作。2840 亿参数模型在普通整机上平稳出字,推开了低成本私有化的大门。
参考链接:
- llama-modchip 开源项目技术文档与量化论文
- DeepSeek-V4-Flash 混合专家模型架构技术报告
- Hacker News 社区关于 CPU 本地部署千亿模型讨论