Zwei handelsübliche 32-GB-DDR-Speicherriegel lösen zunehmend teure Enterprise-Grafikkarten ab, um Modelle mit 284 Milliarden Parametern lokal anzutreiben. Das am 4. November 2026 veröffentlichte Open-Source-Projekt llama-modchip v2.4.0 hat den Systembedarf von DeepSeek-V4-Flash vollständig in ein 64-GB-RAM-Profil gepresst. Damit führt erstmals ein gewöhnlicher Desktop-PC ohne dedizierte GPU ein hochmodernes Mixture-of-Experts-Netzwerk (MoE) stabil aus.
Diese Bereitstellungsmethode verschiebt die Hardware-Spielregeln für lokale KI-Implementierungen grundlegend. Bislang mussten Entwickler, die Flaggschiff-Modelle lokal ausführen wollten, kostspielige Rechenbeschleuniger mit enormen VRAM-Kapazitäten anschaffen. Fortschritte bei Ultra-Low-Bit-Quantisierungsalgorithmen senken den Speicherbedarf der Parameter drastisch. Wer heute alle RAM-Bänke seines Mainboards bestückt, kann die Einstiegshürde für 100-Milliarden-Modelle problemlos überwinden.
20 GB Ballast entfernt: 56,56 GiB Modellgewichte passen in 64 GB RAM
DeepSeek-V4-Flash umfasst insgesamt 284,33 Milliarden Parameter, verteilt auf 43 Schichten Multi-head Latent Attention (MLA) sowie 256 Routing-Experten, von denen pro Inferenzschritt 13,17 Milliarden Parameter aktiv geschaltet werden. Nach dem offiziellen Standard-Quantisierungsverfahren UD-IQ1_S beansprucht der Modell-Checkpoint rund 76,87 GiB Speicherplatz. Auf einem typischen Linux-System mit nominell 64 GB Arbeitsspeicher verbleiben nach Abzug des Betriebssystems real etwa 62,5 GiB verfügbarer Speicher.
Unter regulären Bedingungen führt dieser Speicherüberhang unweigerlich zum Absturz. Der Prozess wird entweder direkt vom OOM-Killer des Linux-Kernels beendet, oder das System driftet in ein massives Virtual-Memory-Swapping ab, was die Rechenleistung extrem einbrechen lässt. Bei akutem RAM-Mangel führen permanente Page-Swaps zu einem faktischen Stillstand der Inferenz.
llama-modchip setzt hierbei auf eine selbst entwickelte SwiGLU-H2-Hessian-Quantisierung zweiter Ordnung, kombiniert mit einem maßgeschneiderten Fractal-64-Format zur Neustrukturierung der Tensoren. Dieses Verfahren drückt die durchschnittliche Bitbreite auf 3,75 bpw, wodurch das Checkpoint-Volumen von 76,87 GiB auf 56,56 GiB schrumpft. Durch diese Reduktion um 20,31 GiB (ein Minus von 26,4 %) gleitet das Modell exakt unter die kritische Grenze des physischen Speichers.
Selbst in einer Long-Context-Konfiguration mit 256K Tokens bleibt der residente Arbeitsspeicher des Prozesses (VmRSS) bei 57,61 GiB gedeckelt. Innerhalb der 64 GB physischen RAMs verbleibt somit ein Sicherheitspuffer von etwa 6,4 GiB. Dies garantiert einen Betrieb völlig ohne Swap-Aktivitäten oder NVMe-Leseengpässe. Durch die Beschränkung auf den Hauptspeicher arbeitet die reine CPU-Architektur unterbrechungsfrei und stabil.
Null GPUs, 9 bis 14 Tokens pro Sekunde: Selbstspekulative Dekodierung liefert praxistaugliche Durchsätze
Das Testsystem kommt vollständig ohne dedizierte Beschleunigerkarten aus; als Plattform dient ein handelsüblicher Desktop mit einem AMD Ryzen 9 9955HX. Der auf der 16-Kern-Zen-5-Architektur basierende Prozessor wickelt sämtliche Tensor-Multiplikationen über native CPU-Vektorbefehlssätze ab. In der reinen autoregressiven Dekodierungsphase liefert das System kontinuierlich 9,06 bis 9,95 Tokens pro Sekunde.
Um die Latenzgrenzen der reinen CPU-Berechnung zu überwinden, integriert das Projekt den Algorithmus Stockfish-PVS für selbstspekulative Dekodierung (Self-Speculative Decoding). Durch leichtgewichtige Vorhersagezweige werden redundante Matrixoperationen vermieden, wodurch der tatsächliche Dekodierungsdurchsatz auf 11,5 bis 14,7 Tokens pro Sekunde steigt. Diese Geschwindigkeit genügt den Anforderungen an flüssiges menschliches Lesen und automatisierte Agentenaufrufe im Terminal mühelos.
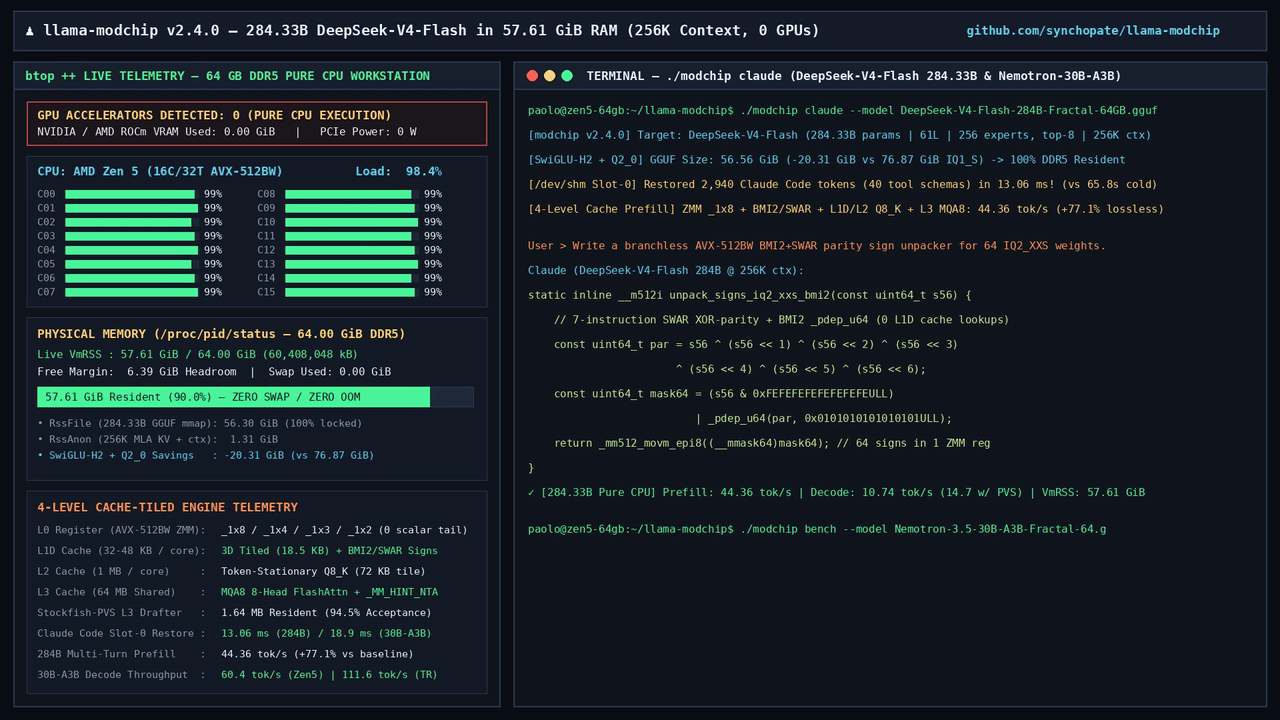 Abbildung: Ein 284B-Parameter-Modell führt Terminal-Agentenaufgaben auf einem 64-GB-RAM-Desktop aus. Quelle: llama-modchip-Repository-Assets
In der Prefill-Phase für Eingabe-Prompts treten die Rechenbeschränkungen der CPU naturgemäß deutlicher zutage. Die aktuelle Version erreicht Prefill-Raten von 43,16 bis 44,36 Tokens pro Sekunde – eine Steigerung um 77 % gegenüber den 25 Tokens/s der Vorgängerversion. Bei einem umfangreichen Kontext von 10.000 Tokens muss der Anwender dennoch etwa 225 Sekunden warten, bis das erste Zeichen ausgegeben wird.
Dieses Leistungsprofil markiert die Grenzen des reinen CPU-Einsatzes. Für hochgradig nebenläufige Webservices mit häufigen Kaltstarts ist das Verfahren ungeeignet. Für Einzelanwender steht dem kurzen initialen Ladevorgang jedoch der enorme Vorteil gegenüber, ein 200-Milliarden-Parameter-Modell vollständig und souverän auf eigener Hardware zu kontrollieren.
30B-Klasse auf 16 GB RAM portiert: Zweite Reihe für mobile Geräte
Neben dem 284B-Großmodell deckt das Projekt auch mittelgroße Architekturen ab. Für Nemotron-3.5-30B-A3B schrumpft die komprimierte Checkpoint-Größe auf 14,35 GiB. Damit lässt sich das Modell auf gängigen Laptops mit 16 bis 32 GB RAM betreiben.
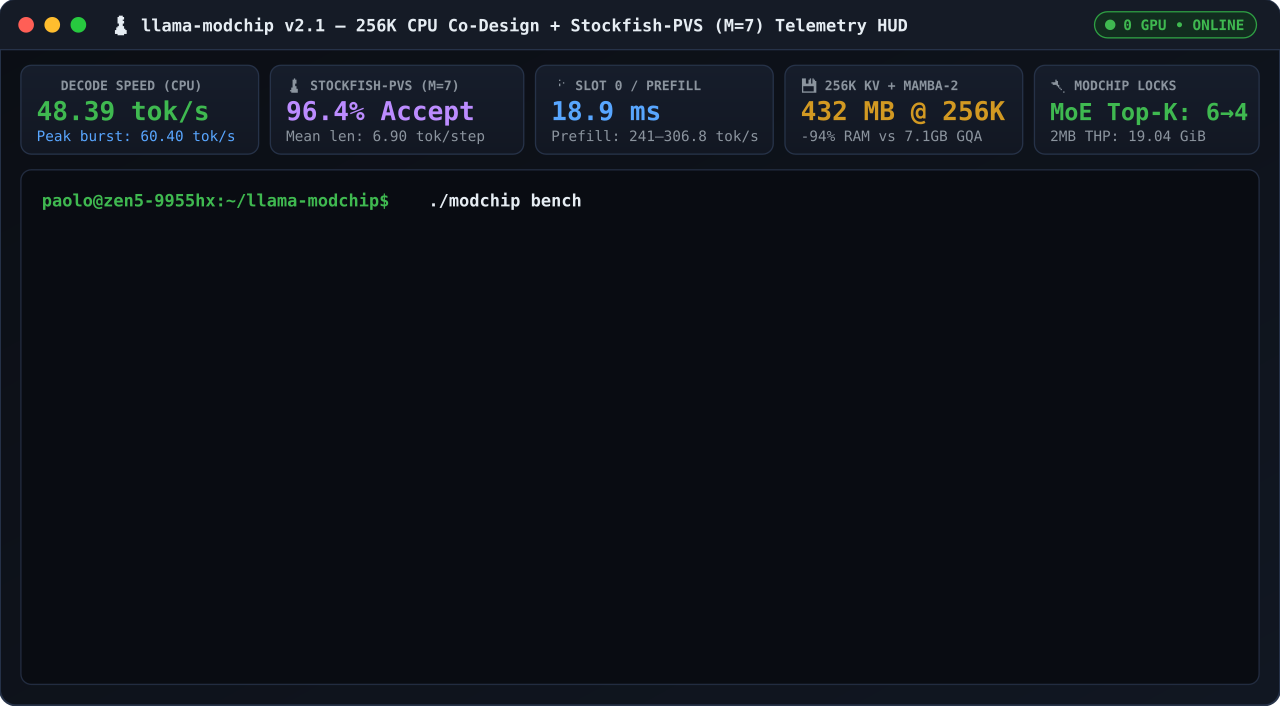 Abbildung: Einrichtungsablauf und Modell-Ladevorgang im llama-modchip-Terminal. Quelle: llama-modchip-Repository-Assets/modchip_demo.svg
Über regulären Consumer-DDR-Dual-Channel-Speicher erreicht das 30B-Modell Dekodierungsraten von 25 bis 111 Tokens pro Sekunde. In standardisierten Benchmark-Tests bestand die Implementierung sämtliche Qualitätsprüfungen mit voller Punktzahl. Das kompakte Format gepaart mit hoher Ausgabegeschwindigkeit verleiht Modellen mittlerer Größe eine beachtliche Offline-Praxistauglichkeit.
Die Ultra-Low-Bit-Quantisierung entwickelt sich zügig zu einer tragenden Basisinfrastruktur für Edge-Umgebungen. Die an Flaggschiff-Netzen erprobten Komprimierungsmethoden lassen sich nahtlos auf Mittelklasse-Hardware übertragen. Kleinere Entwicklerteams ohne High-End-Grafikkarten erhalten so einen realistischen, mehrstufigen Pfad für lokale KI-Workloads.
Proprietäre Tensoren und Qualitätsmaßstäbe: Die Kehrseite radikaler Quantisierung
Die radikale Absenkung der Hardwarehürden verlangt Zugeständnisse an die Kompatibilität des Ökosystems. Das Fractal-64-Format führt eine proprietäre Tensor-Typkennung ein (Typ-ID 40). Wird ein solches Modell über Standardversionen von llama.cpp, Ollama oder LM Studio geladen, bricht die Software mit Fehlermeldungen ab. Anwender sind zwingend darauf angewiesen, die Inferenzwerkzeuge aus dem projekteigenen Fork zu kompilieren.
Auch die Bewertung von Präzisionsverlusten sorgt in der Entwicklergemeinde für Diskussionen. Die veröffentlichten Benchmarks beziehen sich ausschließlich auf Vergleiche mit der IQ2_XXS-Quantisierung und verzichten auf Gegenüberstellungen mit der FP16-Vollpräzision. Entwickler auf Hacker News betonen, dass bereits die 97-GB-Version von Q2_XXS spürbare Abweichungen gegenüber unkomprimierten Referenzläufen aufweist.
Der KV-Cache-Overhead bei langen Kontexten stellt eine weitere praktische Hürde dar. Um einen unquantisierten KV-Cache über maximale Längen aufrechtzuerhalten, müsste der Arbeitsspeicher auf rund 150 GB anwachsen. Zudem zeigen Praxistests, dass abseits eines etwas schnelleren Prefills bei 30B-Modellen die normale Dekodierleistung kaum vom Standardverhalten abweicht.
Rechenbeschleuniger weichen Speicherkapazität: Die Kostenstruktur wandelt sich
Der drastische Anschaffungspreisunterschied erklärt das enorme Interesse an dieser Lösung. Ein spezialisierter Multi-GPU-Server für ein 284B-Modell erfordert Investitionen im fünfstelligen Dollarbereich. Ein Standard-Desktop mit 64 GB Arbeitsspeicher kostet dagegen gut eine Zehnerpotenz weniger.
Natürlich entspricht die Ausgabe einer lokalen Ultra-Low-Bit-Quantisierung in Präzision und Latenz nicht den Ergebnissen großer GPU-Cloud-Cluster; beide Ansätze bewegen sich in unterschiedlichen Nutzungsszenarien. Der wahre Mehrwert der lokalen Lösung liegt nicht im Verdrängen von Cloud-Diensten, sondern im Schaffen einer soliden Basis für den GPU-losen Betrieb.
Der Schwerpunkt der KI-Hardware verlagert sich von roher GPU-Rechenleistung hin zur Hauptspeicherkapazität. Solange der Arbeitsspeicher die komprimierten statischen Gewichte vollständig aufnehmen kann, genügen reine CPU-Knoten, um Inferenz für gewaltige MoE-Netzwerke bereitzustellen. Dass ein 284-Milliarden-Parameter-Modell auf Standard-PCs reibungslos Text generiert, stößt das Tor zu kostengünstiger, vollständig privater KI weit auf.
Weiterführende Links:
- llama-modchip Open-Source-Projektdokumentation und Quantisierungs-Paper
- Technischer Bericht zur Mixture-of-Experts-Architektur von DeepSeek-V4-Flash
- Hacker-News-Diskussion über lokale CPU-Inferenz für Modelle mit über 100 Mrd. Parametern