Im November 2026 verbreitete die KI-Übersicht (AI Overview) ganz oben in der Google-Suche eine verblüffende Branchenmeldung: Eine Sicherheitsforscherin, die zuvor 14 Chrome-Schwachstellen gemeldet hatte, soll angeblich eine historische Rekordprämie von 1.333.337 US-Dollar erhalten haben. Auf der Suchkarte waren Empfängerin, astronomische Summe und Projektname fein säuberlich aufgeführt – inklusive eines Vergleichs mit den regulären Höchststufen.
Auf dem Bankkonto der Forscherin war jedoch kein einziger Cent eingegangen. Die angebliche Millionenauszahlung existierte in der Realität schlichtweg nicht. Sie stammte lediglich aus einem unbedacht geänderten Backend-Feld und einem öffentlichen, selbstironischen Scherz auf Social Media.
Fehlkonfiguration übergibt Bearbeitungsrechte für Prämienbetrag
Die Hauptfigur der Geschichte ist die Sicherheitsforscherin Lyra Rebane. Sie analysiert seit langem Low-Level-Browserstrukturen und hat bereits 14 Schwachstellen in Chromium gemeldet. Der Ursprung des aktuellen Durcheinanders reicht bis ins Jahr 2022 zurück, als sie einen Logikfehler einreichte.
Die Schwachstelle betraf die Background-Fetch-API. Ein Angreifer musste ein Opfer lediglich dazu verleiten, eine präparierte Webseite oder ein bösartiges iframe aufzurufen, um den Browser in ein Botnet einzubinden. Da ein sauberer Fix komplex war, verharrte der Patch jahrelang in den internen Systemen. Als die Behebung im Februar 2026 schließlich abgeschlossen war, zahlte Google ihr die reguläre Prämie von 1.000 US-Dollar aus.
Die entscheidende Wende folgte bei der anschließenden Bearbeitung. Im Mai 2026 berichtete Ars Technica, dass Details der Schwachstelle versehentlich vorzeitig publik gemacht worden waren. Google stufte das interne Ticket eilig wieder als privat ein. Bei dieser Rechteanpassung unterlief dem Betriebsteam ein folgenschwerer Fehler: Lyra Rebane wurde irrtümlich als Verifiziererin (verifier) für das Problem eingetragen.
Im Ticketsystem Buganizer dürfen externe Berichterstatter normalerweise nur lesen und kommentieren. Mit der Rolle als Verifiziererin schaltete das System jedoch zentrale Schreibrechte frei. Für die Erfassung des Prämienbetrags war das Feld vrp-reward zuständig. Weil sensible Finanz-Metadaten nicht strikt nach Rollen isoliert waren, erhielt eine externe Testerin unbemerkt Schreibzugriff auf die zugrundeliegende Datenbank.
Ein 1,33-Millionen-Dollar-Scherz durchbricht die automatische Moderation
Im November 2026 öffnete Lyra Rebane das Ticket erneut und bemerkte mehrere ungewohnte Bearbeitungsbuttons auf der Benutzeroberfläche. Um die Grenzen ihrer neuen Berechtigungen auszuloten, änderte sie die ursprünglichen 1.000 Dollar in 1.333.337 Dollar – eine Zahl, die im Hacker-Slang (Leet) für Elite steht und in der Geschichte von Googles Vulnerability Reward Program völlig astronomisch ist.
Die Bearbeitung erfolgte um 22:38:15 Uhr UTC. Exakt 14 Sekunden später markierte sie das Ticket als verifiziert. Da ihr bewusst war, dass interne Logs die Änderung sofort aufdecken würden, ging sie damit offen auf Social Media um. Am 7. November postete sie auf X, ihre Chrome-Lücke habe eine Rekordprämie von 1,33 Millionen Dollar erzielt – nur um im nächsten Satz selbstironisch aufzulösen: „Oder ich habe einfach Bearbeitungsrechte für ein Feld bekommen, an das ich nicht herangehöre.“
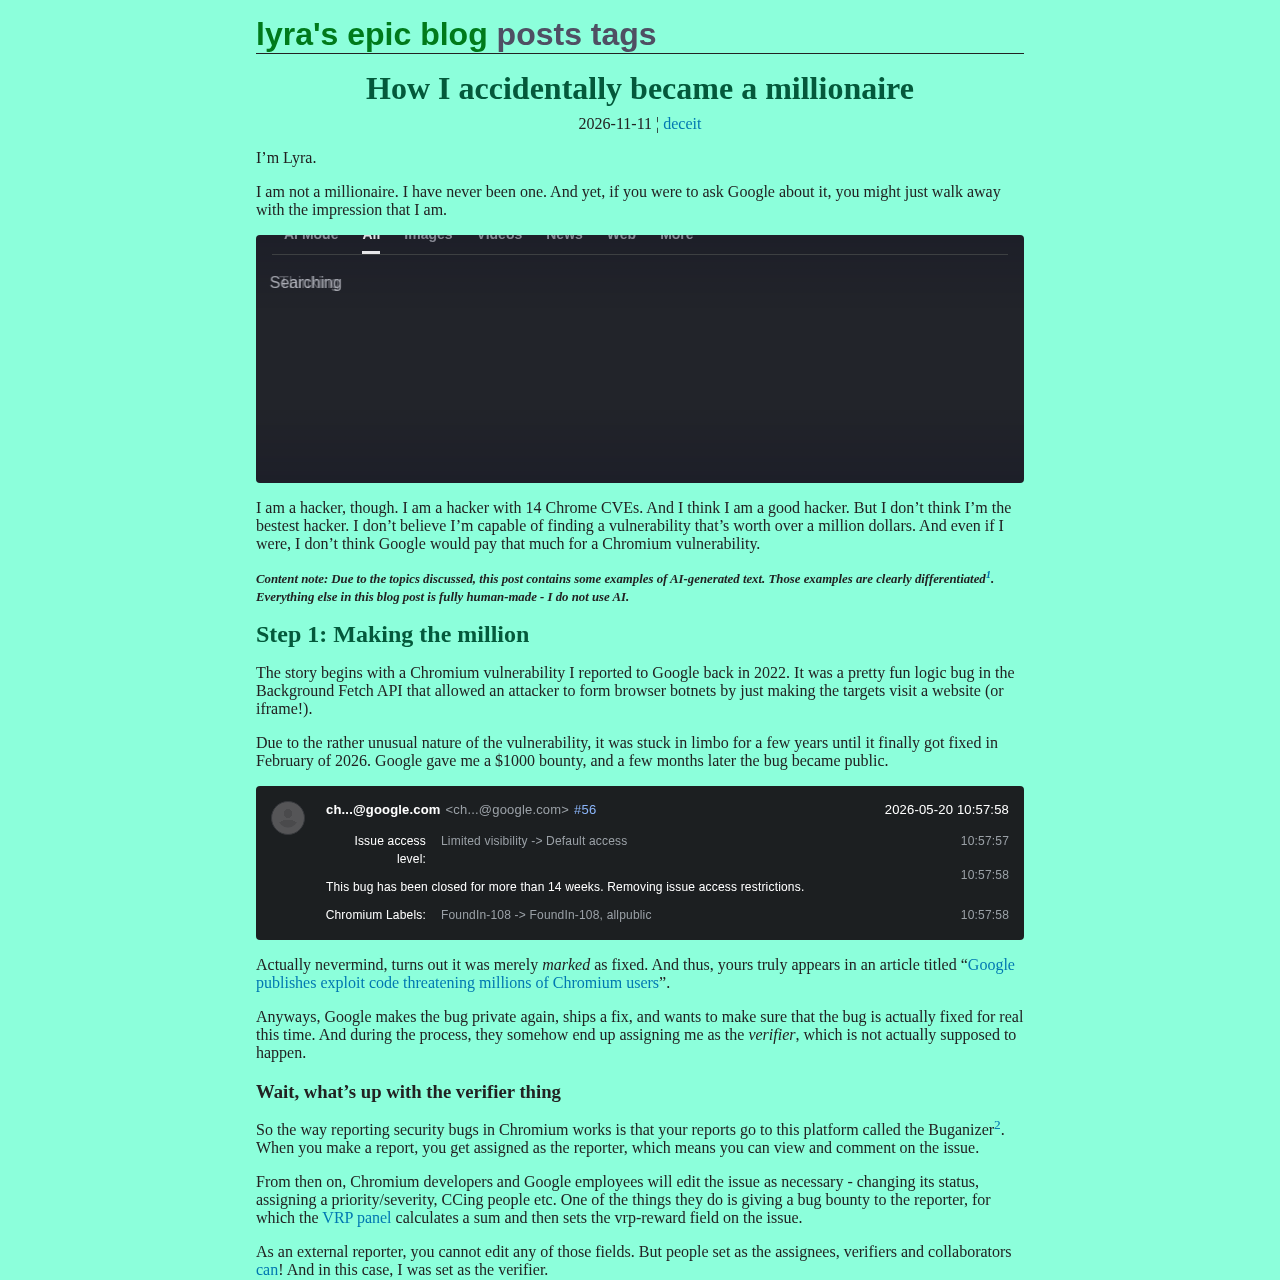 Abbildung: Lyra Rebane stellt auf ihrem Blog klar, dass sie nie Millionärin wurde, und zeigt Systemprotokolle mit der tatsächlichen Prämie von 1.000 Dollar. Quelle: Screenshot von lyra.horse
Der Beitrag ging in Entwickler- und Sicherheitskreisen rasch viral. In den frühen Morgenstunden des 8. November veröffentlichte sie eine offizielle Klarstellung: Der Datenbankeintrag sei zwar echt, Google würde diesen Betrag aber unter keinen Umständen auszahlen. Das Ganze sei eine reine Farce infolge einer Berechtigungspanne.
Doch die Automatisierungsmechanismen der Plattform brachten die Geschichte erst richtig ins Rollen. Ein experimenteller KI-Prüfer auf X heftete eine Community Note an den Tweet und behauptete fälschlicherweise, sie habe den Screenshot gefälscht. Rebane hielt umgehend dagegen: Der Datenbankeintrag existiere tatsächlich, der Fehler liege in Googles Zugriffskontrolle. Nach ihrem Widerspruch verschwand der fehlerhafte KI-Hinweis schnell wieder, ohne zur Faktenprüfung beigetragen zu haben. Die automatische Moderation hatte ihre Rechenleistung darauf verschwendet, Bildpixel anzuzweifeln, und den offensichtlichen Sarkasmus des Beitrags völlig verfehlt.
Eine dreistufige Pipeline hebt die Satire in die Suchschlagzeilen
Hätte die Kette auf Social Media geendet, wäre der Witz schnell verpufft. Doch nachgelagerte Systeme übernahmen sofort die Weiterverarbeitung. Ein vollautomatischer KI-Podcast namens Daily Vibe Casting griff den viralen Tweet auf und formte daraus binnen kürzester Zeit eine Audiofolge und einen Webartikel.
Auf der Seite prangte zwar der Hinweis „Inhalt von KI generiert“, doch das System behandelte den ersten Halbsatz des Tweets kurzerhand als bare Münze. Unter dem Titel „Forscherin Rebane erhält Rekordprämie von 1.333.337 Dollar“ ging die Meldung ins Netz. Die Maschinerie prüfte weder offizielle Verlautbarungen noch nachfolgende Dementis – sie stürzte sich allein auf die aufsehenerregende Zahl.
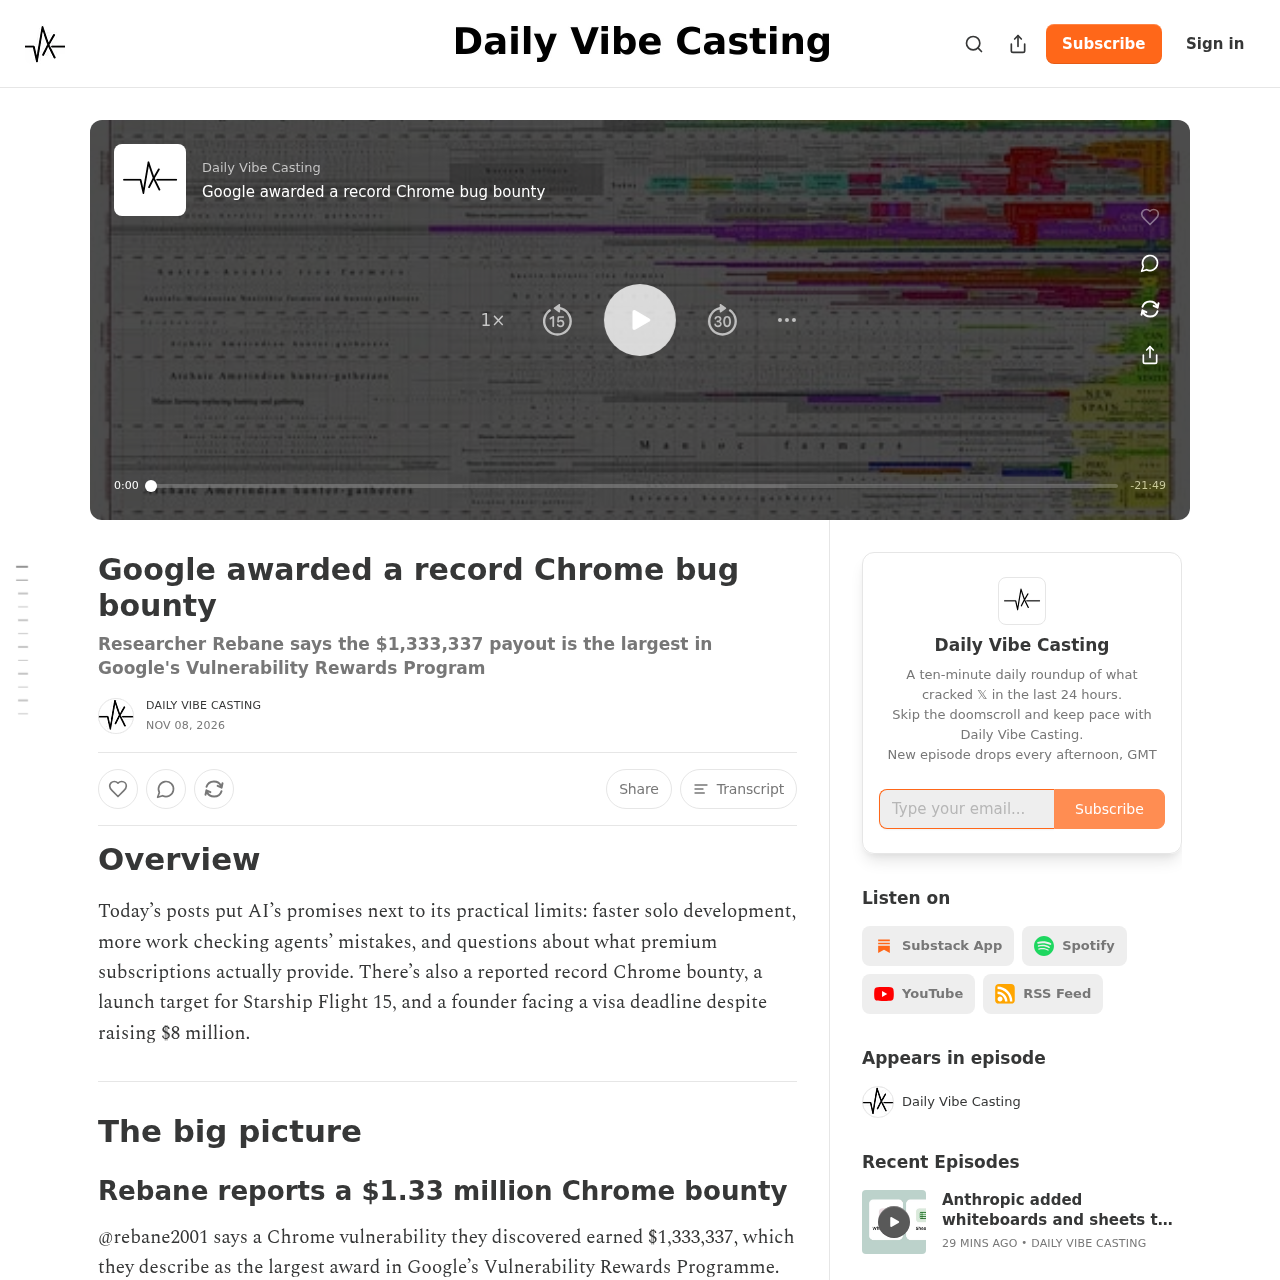 Abbildung: Der automatisierte KI-Nachrichtenpodcast Daily Vibe Casting verpackt den Scherz-Tweet als historische Branchen-Eilmeldung. Quelle: Screenshot von dailyvibecasting.com
Das letzte Glied der Kette schloss sich direkt im Google-Suchschlitz. Wenn Nutzer nach „höchste Chrome-Bug-Bounty“ suchten, fasste Googles AI Overview diese synthetischen Sekundärquellen zu einer autoritär wirkenden Infokarte zusammen. Das System bestätigte die Rekordsumme und feierte die Forscherin als neue Rekordhalterin.
Wer nach ihrem Namen suchte, fand als zentrales Attribut ebenfalls den Begriff „Millionärin“. Das weltweite Referenz-Suchsystem wandelte sich zum Gerüchteverstärker. Ein selbstironischer Witz durchlief Scraping, Umschreiben und KI-Zusammenfassung – und erhielt am Ende den amtlichen Prüfstempel der weltgrößten Suchmaschine. Ein unüberwachtes Fließband hatte eine harmlose Anekdote in strukturierte Falschnachrichten verwandelt.
Automatisierte Systeme zitieren sich gegenseitig und löschen die Verifikation aus
Die Zahl 1.333.337 hätte selbst einer flüchtigen menschlichen Prüfung nicht standgehalten. Nach den offiziellen Richtlinien des Chrome-VRP sind selbst die komplexesten Full-Chain-Sandbox-Escapes bei 250.000 Dollar gedeckelt – Beträge, die an spezialisierte Firmen wie XBOW oder Spitzenforscher vergeben wurden. Ein siebenstelliger Betrag wurde noch nie ausgezahlt.
Ihre eigene, zuvor öffentlich bekannte Höchstprämie lag bei 18.000 Dollar für einen SVG-Clickjacking-Bug. Angesichts einer Zahl, die das Fünffache des Höchstbetrags überstieg, schlug kein einziger automatisierter Knoten im gesamten Prozess Alarm. Google-Ingenieure entzogen ihr gegen zwei Uhr nachts die Rechte und setzten den Betrag auf 1.000 Dollar zurück. Doch die AI Overviews im Frontend behaupteten noch tagelang beharrlich, sie sei Millionärin.
Hier zeigt sich die fatale Schwachstelle des generativen Informationskonsums: Ein Modell behandelt den Output eines vorgelagerten Modells als objektiven Beweis. Der KI-Podcast stützte sich auf einen einzelnen Tweet, das Suchmodell übernahm den KI-Podcast als vertrauenswürdige Primärquelle. Während die Daten zwischen Modellen zirkulierten, wurde das Dementi der Urheberin als Rauschen verworfen, während die Sensationszahl immer tiefer verankert wurde.
Früher erforderte die Aufnahme in Wissensdatenbanken belastbare Belege und Institutionen. Die heutige LLM-gestützte Pipeline umgeht den Menschen vollständig. Scraping-Skripte, Textgeneratoren und Zusammenfassungs-Engines greifen nahtlos ineinander. Durch maschinelle Querverweise wird ein ungeprüfter Witz zur autoritativen Wahrheit aufgewertet.
Falsche Fakten entstehen auch ohne bösartige Lügner
Dieser Vorfall endete als harmlose Posse, doch das strukturelle Risiko für die Informationslandschaft ist gravierend. Lyra Rebane hatte zu keinem Zeitpunkt vor, Fake News zu verbreiten; sie schilderte den Hergang transparent auf sämtlichen Kanälen. Doch sobald Texte in die maschinelle Verarbeitungsfabrik geraten, werden kontextualisierende Fußnoten unbarmherzig getilgt.
Würde ein Akteur diese Schwachstelle gezielt für Desinformationskampagnen oder Reputationsangriffe ausnutzen, brächen die bestehenden Abwehrlinien sofort zusammen. Ein Angreifer müsste lediglich bestimmte Schlagworte über Botnetze streuen und automatisierte Nischenseiten bestücken. Ein Suchsystem ohne gesunden Menschenverstand lässt sich spielend austricksen. Wenn Suchmaschinen Falschinformationen ganz oben platzieren, haben Leser keine Chance zu erkennen, dass der Ursprung lediglich ein lockerer Witz war.
Halluzinierende Modelle sind nur ein Symptom. Das eigentliche Dilemma liegt im Fehlen menschlicher Verifikationsinstanzen entlang der gesamten Informationskette. Rechtefehler, Fehlurteile in sozialen Netzwerken, inhaltsleere Podcast-Generatoren und die Bestätigung durch die Suchmaschine – alle Akteure streben nach maximaler Verbreitungsgeschwindigkeit. Doch niemand übernimmt die Qualitätskontrolle. Auf diesem unbewachten Förderband genießen absurde Gags und geprüfter Qualitätsjournalismus denselben Passierschein.
Einst bauten Suchmaschinen Vertrauen über Hyperlinks und nachprüfbare Quellen auf. Um dem Drang nach sofortigen Antworten nachzugeben, fällen KI-Übersichten heute voreilige Urteile und verpacken statistische Wahrscheinlichkeiten als unumstößliche Wahrheiten. Solange Generierung ohne Verifikation weiterläuft, werden erfundene Geschichten auch künftig die Spitze der Suchergebnisse erobern – und beim nächsten Mal gibt es womöglich niemanden, der die Sache freiwillig aufklärt.
Referenz-Links:
- Lyra Rebanes persönlicher Blogbeitrag: How I accidentally became a millionaire
- Daily Vibe Casting AI-Nachrichtenpodcast Berichtsseite
- Google Buganizer Dokumentation zur Zugriffskontrolle im Issue-Tracker
- Frühere Berichterstattung von Ars Technica zur Chromium-Offenlegungspanne