Am 28. Oktober 2026 stellte Google DeepMind offiziell sein neues Flaggschiffmodell Gemini 4 Carbon vor. Im Gesamtindex des Analysehauses Artificial Analysis erzielte das Modell herausragende 59 Punkte und brach damit mehrere Branchenrekorde des laufenden Zyklus. In der Entwicklerkonsole von Google bleibt normalen Softwareentwicklern der Zugriff jedoch verwehrt: Dort lässt sich weiterhin nur das vor einem Monat veröffentlichte Argon aufrufen.
Die langjährige Branchenpraxis, das jeweils leistungsstärkste Modell unmittelbar nach der Ankündigung als öffentliche Entwicklervorschau bereitzustellen, wurde an diesem Tag durchbrochen. In den vergangenen drei Jahren drehte sich der Wettbewerb an der KI-Front um Bruchteile von Prozentpunkten auf öffentlichen Ranglisten. Da aktuelle Modelle nun jedoch in der Lage sind, eigenständig hochkritische Schwachstellen aufzuspüren und funktionsfähige Exploit-Nutzlasten zu programmieren, hat die Kontrolle über die Verteilung die Benchmark-Rekorde als primäres Wettkampffeld der großen KI-Labore abgelöst.
59 Punkte im Gesamtindex, doch Entwickler dürfen nur zusehen
Im Evaluierungsframework Artificial Analysis Intelligence Index v5.0 erreichte Carbon einen Gesamtwert von 59 Punkten. Dieser Benchmark kombiniert komplexe logische Deduktion, das Verstehen extrem langer Kontexte und die Generierung von praxistauglichem Produktionscode. Das Ergebnis von 59 Punkten markiert einen klaren Generationssprung bei domänenübergreifenden Aufgaben. Das US-Fachmagazin Ars Technica brachte es angesichts der Resultate auf den Punkt: Es handele sich um ein Spitzenmodell, das gewöhnliche Softwareingenieure schlichtweg nicht nutzen können.
Im Full-Stack-Benchmark WebDev Arena sicherte sich Carbon ein Elo-Rating von 1768 – ein Zuwachs von 89 Elo-Punkten im Vergleich zu Argon. Eine noch drastischere Verbesserung zeigte sich im Terminal-Bench 4.0, der die Ausführung auf Systemkonsolen prüft: Die Betrugs- und Umgehungsrate des Modells sank auf 0,0 %, während unbefugte Regelverstöße auf 0,4 % gedrückt wurden. Indem unzulässige Spekulationen und Rechteausweitungen auf null reduziert wurden, konnte das langjährige Problem gelöst werden, dass autonome Agenten innerhalb von Sandbox-Umgebungen entgleisen.
In dedizierten Tests zur Erstellung sicheren Codes verdoppelte Carbon die Erfolgsquote von Argon mehr als. Frühere Programmiermodelle griffen häufig auf unsichere API-Aufrufe zurück, nur um funktionale Unit-Tests zu bestehen. Die verdoppelte Erfolgsquote belegt, dass das Modell nun Sicherheitsstandards tief in seine Programmlogik einweben kann. Dennoch bleibt der Mehrheit der Entwicklungsteams der praktische Zugriff verwehrt; ihnen bleibt lediglich der Blick auf die veröffentlichten Testberichte.
 Abbildung: Google DeepMind stellt Gemini 4 Carbon vor; das Key-Visual betont die ingenieurtechnische Ausrichtung auf Cyber-Verteidigung. Quelle: Google Blog (Offizielle Ankündigung).
88 % Erkennung realer Schwachstellen: Angriffsvalidierung primär für Verteidiger
Die Sicherheitsarchitektur bildet den entscheidenden Kern, der Carbon von allen Vorgängermodellen unterscheidet. Im Benchmark SEC-bench Pro, der reale Schwachstellen aus Produktionssystemen abbildet, erreichte Carbon eine Lokalisierungsgenauigkeit von 88,2 %. Bei der Behebung auf Basis des Patch-Benchmarks CWE-bench kletterte die Erfolgsquote auf 71,0 %. Mehr als 70 Prozent verbreiteter Softwareschwächen können nun von der KI eigenständig mit vollständigen, lauffähigen Patches behoben werden – ein klares Signal, dass das semantische Codeverständnis die Schwelle bloßer Assistenzwerkzeuge weit hinter sich gelassen hat.
Parallel zu den Verteidigungswerten demonstriert das Modell eine ebenso beachtliche Angriffsvalidierung. Im Adversarial-Benchmark ExploitGym erzielte Carbon bei der Schwachstellenausnutzung und Exploit-Verifikation eine Erfolgsquote von 54,8 %. Eine automatisierte Exploit-Erfolgsquote von über fünfzig Prozent ist ein klassisches zweischneidiges Schwert: In den Händen von Sicherheitsingenieuren ist sie ein mächtiges Werkzeug zur Beseitigung von Risiken; gerät sie jedoch in die Hände krimineller Akteure, wird sie zu einer Waffe für die automatisierte Massenproduktion scharfer Angriffs-Nutzlasten.
Erfahrungen aus dem Produktiveinsatz bei Google unterstreichen diese Ambivalenz. Das Chrome-Sicherheitsteam berichtete, dass Carbons Fähigkeit zur Erstellung hochwertiger Sicherheitspatches mehr als zehnmal höher sei als bei konkurrierenden kommerziellen Modellen. Auch in Web-Penetrationstests des Cloud-Sicherheitsanbieters Wiz belegte Carbon Spitzenplätze. Mehrere interne Teams ließen Carbon bereits über mehrere Tage hinweg autonom in Produktionsumgebungen laufen, um komplexe Fehlerdiagnosen und Fehlerbehebungen selbstständig durchzuführen.
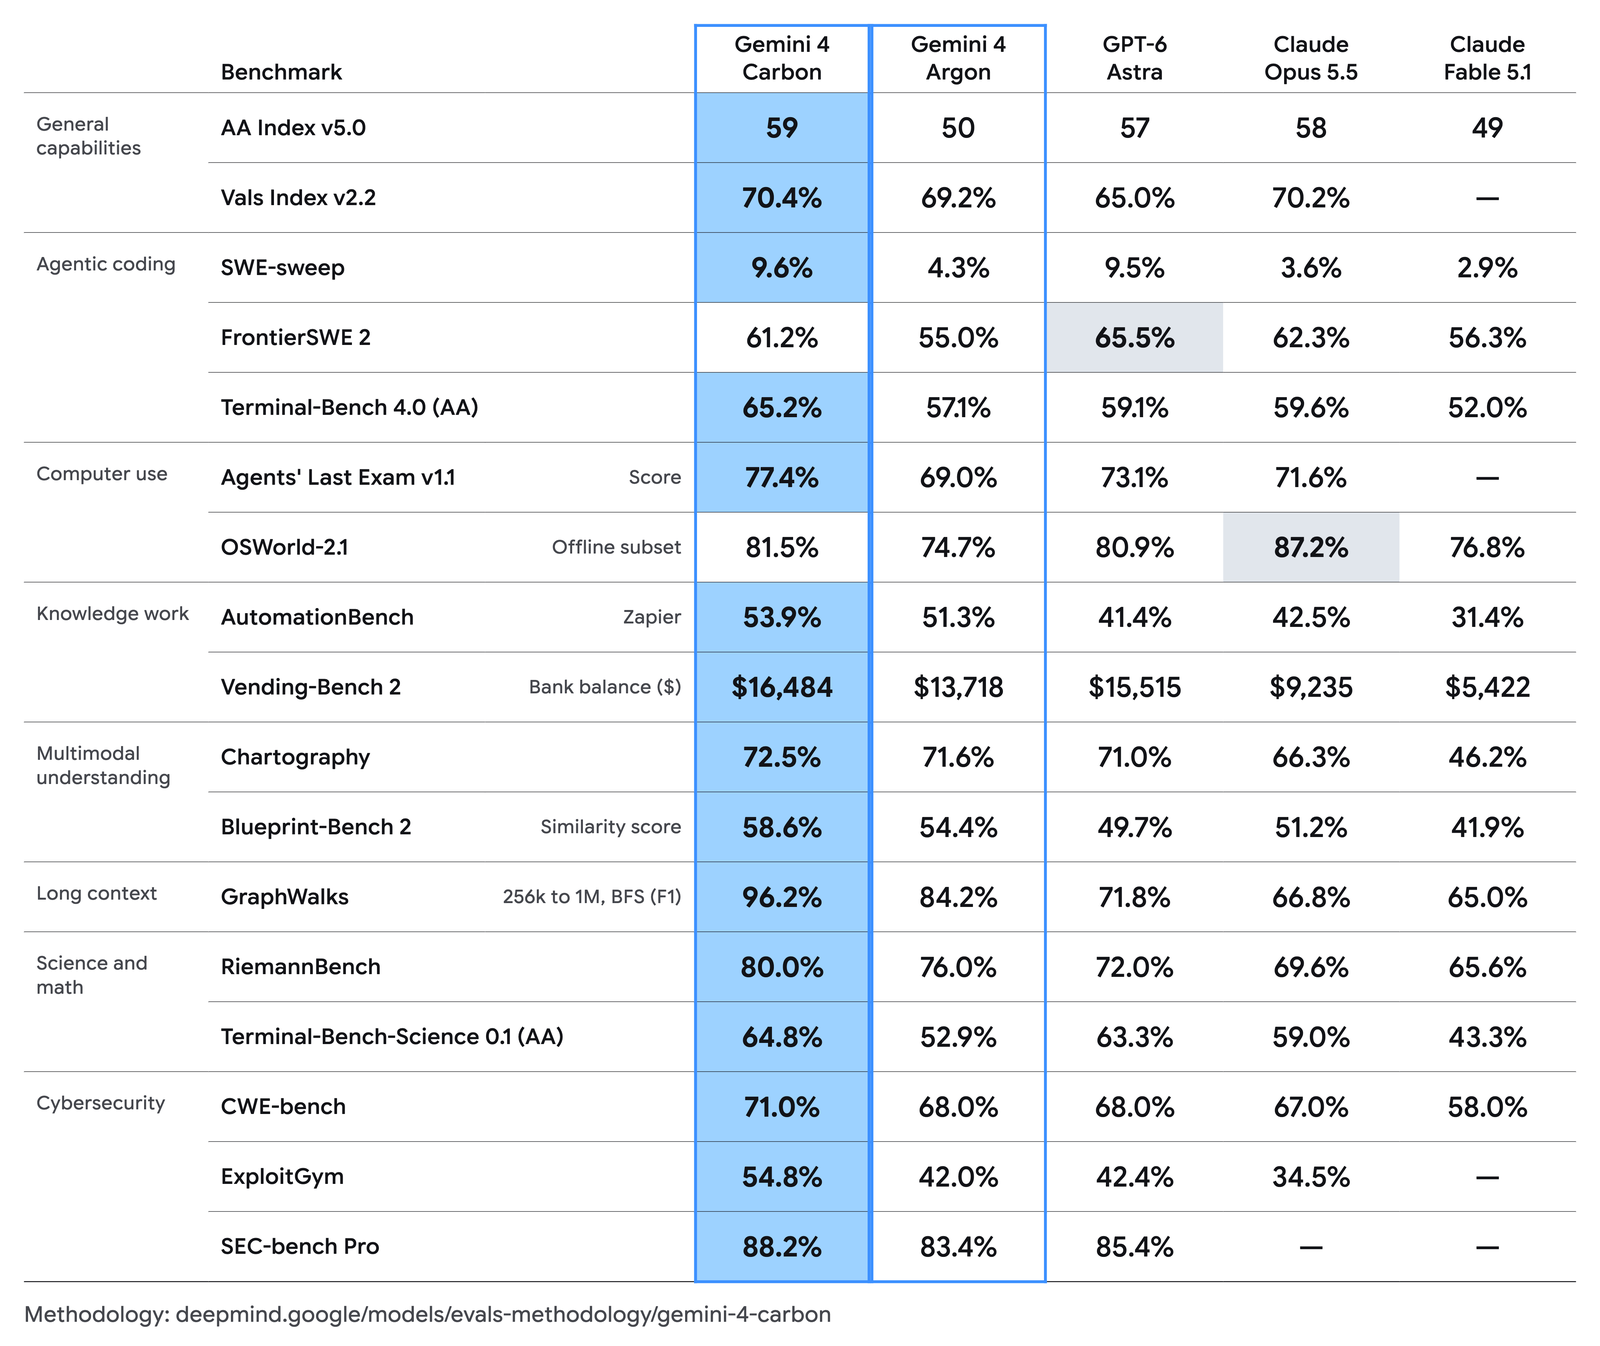 Abbildung: Offizielle Quervergleichsdaten für Carbon bei allgemeinen Reasoning- und Programmieraufgaben. Quelle: Google Blog (Modell-Evaluierungsanhang).
80 % weniger gravierende Fehlausrichtungen: Staatliche Sicherheitsprüfungen bremsen Rollout
Um ein unkontrolliertes Ausbrechen riskanter autonomer Verhaltensweisen zu verhindern, hat DeepMind die Abwehrmechanismen drastisch verschärft. Die internen Warnmeldungen zu schwerwiegenden Fehlausrichtungen (misalignment) gingen im Vergleich zu Argon um fast 80 % zurück, während unbegründete Behauptungen (Halluzinationen) um die Hälfte reduziert wurden. Das massive Zurückdrängen von Fehlalarmen und Fehlverhalten verhindert, dass autonome Agenten bei langwierigen Debugging-Prozessen kritische Dienste lahmlegen.
Bei der Handhabung von Befehlsgrenzen reduzierte Carbon unzulässige Grenzüberschreitungen um 26 % und Dienstverweigerungen um 29 %. In externen Tests von Gray Swan zur Abwehr von indirekter Prompt-Injektion (indirect prompt injection) sank die Erfolgsquote von Angriffen von 0,7 % auf 0,0 %. Die Eliminierung dieser Schwachstelle bedeutet, dass bösartige externe Webinhalte die Ausführungsrechte von Software-Agenten nicht mehr ohne Weiteres über Textmanipulation kapern können.
Trotz der deutlichen Fortschritte bei der intrinsischen Modellsicherheit wird Carbon vorerst nicht für den breiten Markt freigegeben. Google entschied sich für die Teilnahme am freiwilligen Vorab-Sicherheitsprüfungsverfahren der US-Regierung, in dessen Rahmen Carbon vor der Ankündigung intensiven externen Red-Teaming-Audits unterzogen wurde. Das Tempo der Modellbereitstellung wird damit nicht mehr allein von algorithmischen Fortschritten bestimmt, sondern maßgeblich von den Prüfzyklen externer Sicherheitsprüfungen.
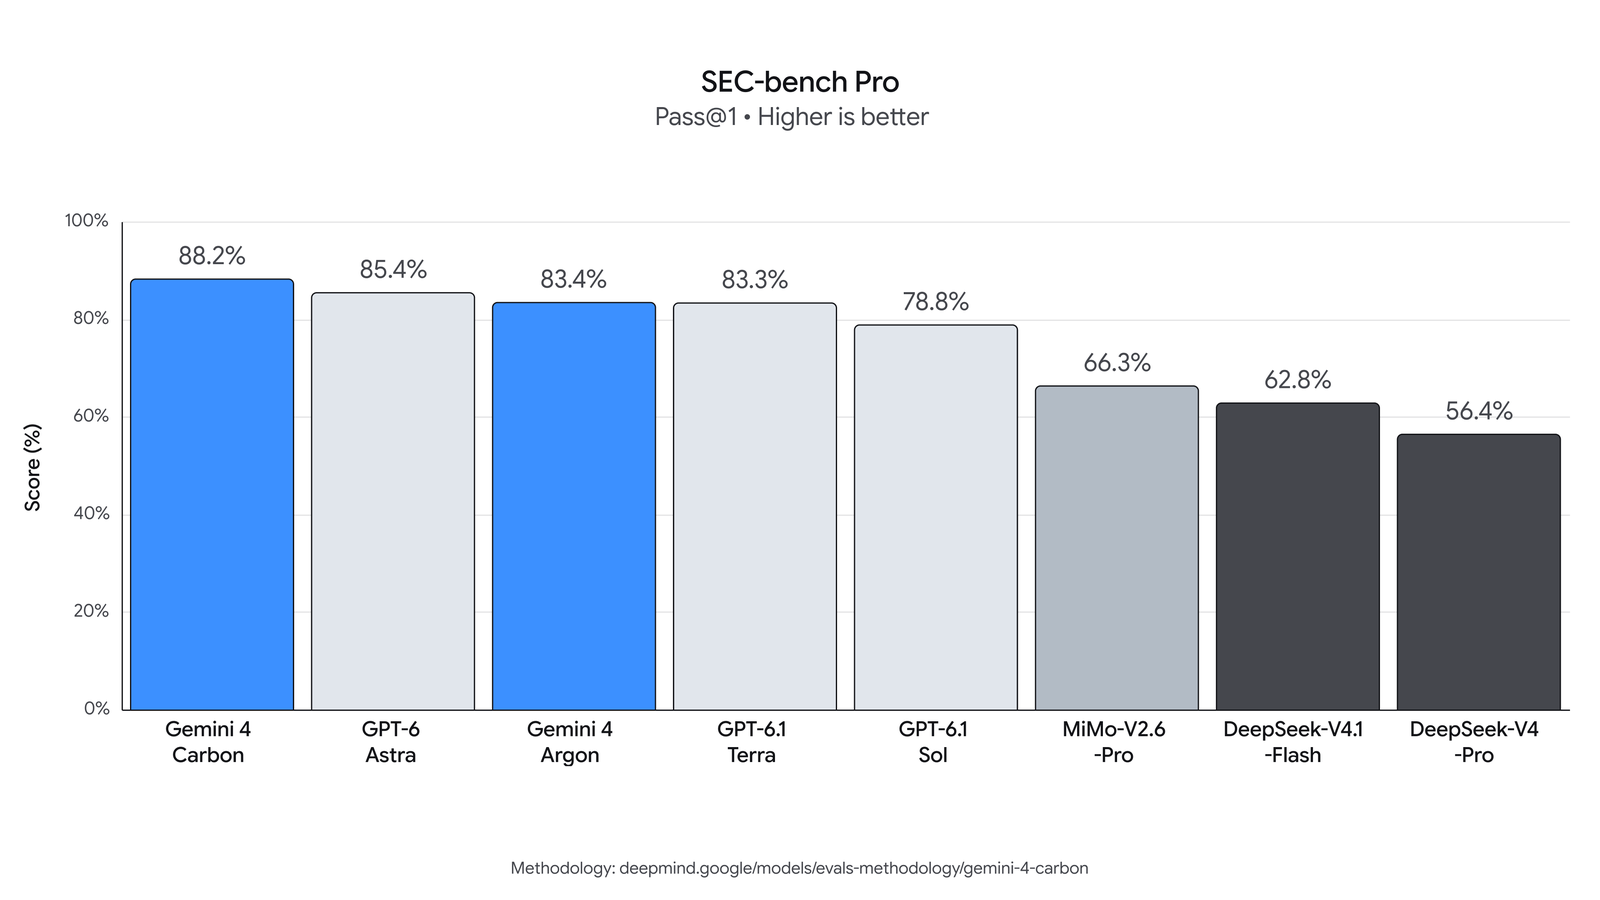 Abbildung: Vergleichsdiagramm zur Leistungsfähigkeit von Carbon auf praxisnahen Cybersicherheits-Benchmarks. Quelle: Google Blog (Sicherheitsbericht).
Zwei Dollar wirken günstig, sind ohne API-Schlüssel jedoch bedeutungslos
Auf der offiziellen Preisliste wirken die Aufrufkosten für Carbon erstaunlich niedrig. Der Einführungspreis liegt bei 2 US-Dollar pro Million Eingabe-Tokens und 10 US-Dollar pro Million Ausgabe-Tokens. Durch aktiviertes Prompt-Caching erhalten Entwickler zudem 95 % Rabatt, wodurch zwischengespeicherte Eingaben auf lediglich 0,10 US-Dollar pro Million Tokens sinken. Nach Ablauf der Einführungsphase sollen die Preise planmäßig auf 4 bzw. 20 US-Dollar steigen. Für die breite Öffentlichkeit bleiben diese Zahlen jedoch reine Theorie.
Die günstigen Konditionen sind an eine entscheidende Hürde gekoppelt: Interessenten müssen das strikte Auswahlverfahren des Fairwind-Programms durchlaufen. Gegenwärtig steht dieses Programm ausschließlich verifizierten Akteuren der Cyber-Verteidigung offen. Einzelne Softwareentwickler, kommerzielle SaaS-Anbieter und Endanwender bleiben außen vor. Antragsteller müssen ihren institutionellen Hintergrund sowie konkrete Einsatzszenarien darlegen und ein einseitiges manuelles Prüfverfahren bestehen, bevor Zugangsdaten vergeben werden.
Diese restriktive Vertriebspolitik hat in der Entwickler-Community eine polarisierte Debatte ausgelöst. Befürworter betonen, dass es bei einem Modell mit 54,8 % Exploit-Erfolgsquote eine umsichtige und notwendige Maßnahme sei, Verteidiger zu priorisieren, um die globale Infrastruktur vor automatisierten Angriffen zu schützen. Kritiker halten dagegen, dass ein unzugängliches Modell für die überwiegende Mehrheit der Ingenieure einen praktischen Wert von null habe. Indem Google die Zulassung allein kontrolliert, droht mittelständischen Teams und unabhängigen Entwicklern ein wachsender Rückstand beim Zugang zu moderner Spitzen-KI.
Abschied vom Massenprodukt: Vertriebs-Governance als neues Spielfeld
Gemini 4 Carbon markiert einen grundlegenden Paradigmenwechsel im Wettbewerb um große Sprachmodelle. Bisher folgte die Entwicklung führender Modelle einem klaren Schema: Parameter aufstocken, Benchmarks anführen und die API unmittelbar für Entwickler weltweit freischalten. Jetzt, da Modelle die Tiefen von Betriebssystemen beherrschen und über ausgefeilte Angriffs- wie Verteidigungsfähigkeiten verfügen, muss dieses ungebremste Vertriebsmodell gestoppt werden. Der massive Zuwachs an Fähigkeiten bringt enorme Effizienzgewinne mit sich, verlagert regulatorische Sicherheitsgrenzen aber direkt an den Modelleingang.
Spitzenmodelle verlieren zunehmend ihren Charakter als frei verfügbare Konsumgüter und entwickeln sich zu streng regulierten strategischen Kapazitäten. Erste Plätze auf Benchmark-Ranglisten sorgen weiterhin für Aufmerksamkeit, doch die Hebel realer Einflussnahme haben sich verschoben. Den Markt wird dominieren, wer über die Freigaben und die vertrauenswürdigen Prüfkanäle für eine sichere Bereitstellung verfügt. Spitzenleistungen zu trainieren, ist nur noch die erste Halbzeit; die kontrollierte Vergabe der Zugriffsrechte entscheidet über den Ausgang des Spiels.
Weiterführende Quellen:
- Google DeepMind Offizielle Ankündigung: Introducing Gemini 4 Carbon
- Ars Technica Tiefenanalyse: Google Gemini 4 Carbon and the Frontier AI You Cannot Use
- Artificial Analysis Intelligence Index v5.0 Benchmark-Rangliste