
Gating auf 1 fixiert: Wie Gleitkommaspeicher zu physischem RAM wird
18 Millionen aufeinanderfolgende CPU-Befehle ausgeführt, und der Fehlerzähler verharrte bei null. Rund 230.000 Ausgabebits stimmten Bit für Bit exakt mit einer Standard-Hardwarereferenz überein. Dieser Benchmark stammt aus dem Open-Source-Projekt Qwenputer des Entwicklers Divyansh Agrawal. Ohne auf wachsende Parameterberge oder externe Interpreter zurückzugreifen, kompilierte der Autor einen virtuellen 32-Bit-RISC-V-Prozessor direkt in die Gewichte von Qwen3.5-4B.
Große Sprachmodelle scheitern traditionell verlässlich an arithmetischen Aufgaben. Da Aufmerksamkeitsmechanismen auf hochdimensionalen probabilistischen Assoziationen basieren, driften lange Zahlen bei der wiederholten Akkumulation über Gleitkommagewichte unweigerlich ab. Gängige Lösungen setzen auf das bloße Auswendiglernen durch gigantische Parametermengen oder lagern Berechnungen an externe Python-Subprozesse aus. Qwenputer wählt einen fundamental anderen ingenieurtechnischen Weg: die Etablierung strikter Hardware-Deterministik direkt innerhalb der Netzwerktopologie.
Das theoretische Fundament liefert die wegweisende Arbeit von Schmidhuber et al. aus dem Jahr 2021. Diese zeigte, dass lineare Transformer im Kern schnelle Gewichtsprogrammierer (fast weight programmers) sind. In der von Qwen3.5 genutzten Gated DeltaNet-Architektur entwickeln sich die verborgenen Zustände nach Delta-Regeln. Wird das Gating fest auf 1 arretiert und die Schreibstärke ebenfalls auf 1 gesetzt, degeneriert die Aktualisierung der Zustandsmatrix zu einer reinen Adress-Überschreiboperation.
Dienen One-Hot-Vektoren (one-hot vector) als Schlüssel-Wert-Eingaben, verwandelt sich das Lesen und Schreiben der Zustandsmatrix in eine zeilengenaue Adressierung. Die Kombination aus fixiertem Gating und orthogonalen Eingangsvektoren transformiert die Zustandsmatrix des neuronalen Netzes in ein zeilenweise les- und beschreibbares physisches RAM. Universalregister (register), der Programmzähler (program counter) und der Hauptspeicher sind festen Zeilen der Matrix zugewiesen. Präzision entsteht hierbei aus strukturellen Beschränkungen statt aus dem Hoffen auf statistische Wahrscheinlichkeitskonvergenz.
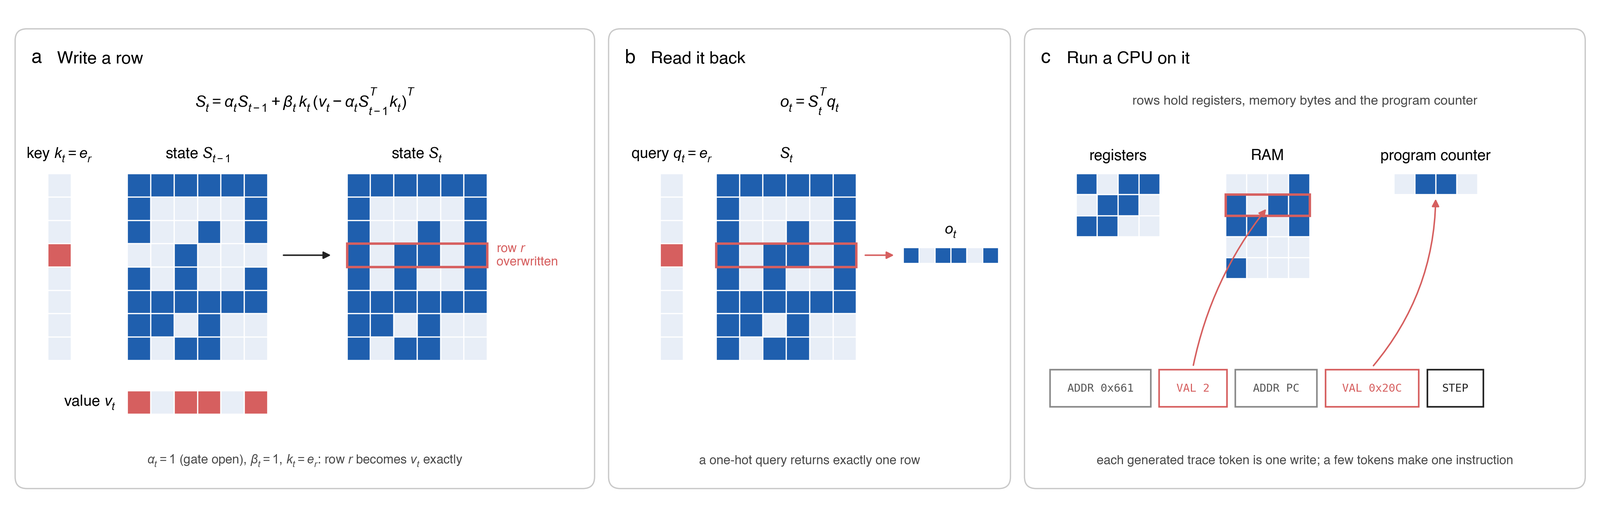 Abb.: Die Gated DeltaNet-Zustandsmatrix als physisch adressierbarer Speicher; Register, Hauptspeicher und Programmzähler belegen feste Zeilen. Quelle: divagr.com
11 vorgeschaltete Schichten bewältigen 18 Millionen Befehle ohne Fehler
In der praktischen Implementierung schaltete der Autor den ursprünglichen 32 Schichten von Qwen ein CPU-spezifisches Netzwerk aus 11 Schichten vor. Die Gewichte des Basismodells bleiben dabei vollständig eingefroren und dienen lediglich als Aufgaben-Router und Dispatcher. Arithmetische Operationen laufen eigenständig innerhalb der vorgeschalteten Schichten ab. Das Gesamtsystem implementiert den vollständigen RV32IM-Befehlssatz, ergänzt um die Zba-Erweiterung sowie eine dedizierte Recheneinheit für Langzahlarithmetik.
Strenge Validierungstests belegen die Effektivität dieser topologischen Neugestaltung. Das System bestand die offizielle RISC-V-Konformitätstestsuite ohne einen einzigen Fehler. Im ununterbrochenen, autonomen Dauerbetrieb wickelte es 18 Millionen Befehle ab – mit identischen Ergebnissen wie im QEMU-Emulator.
In den Arithmetik-Benchmarks von DeepMind tritt der Vorteil von Struktur gegenüber reiner Skalierung noch deutlicher zutage. Bei der Divisionsaufgabe div_big erreicht das unveränderte Qwen3.5-4B-Basismodell lediglich 72,5 % Genauigkeit. Mit externen Python-Werkzeugen steigt dieser Wert auf 95 %, während Qwenputer 97,5 % erzielt. Bei gemischten langen Multiplikations- und Divisionsaufgaben erreichte Qwenputer eine perfekte Punktzahl von 100 % – 2,5 Prozentpunkte mehr als die Python-Toolchain.
Beim Langzahltest NUPA stürzte das Basismodell auf 48,6 % ab, während Qwenputer makellose 100 % hielt. Um in arithmetischen Aufgaben Bestwerte zu erzielen, braucht es keine gigantischen Modelle; man muss dem System lediglich die passenden algebraischen Ausführungseinheiten bereitstellen. Entscheidend ist zudem, dass die allgemeinen Sprachfähigkeiten nicht beeinträchtigt wurden: Die KL divergence des modifizierten Modells auf allgemeinen Textkorpora liegt bei 6e-4 und damit unmittelbar am Grundrauschen von 5e-4.
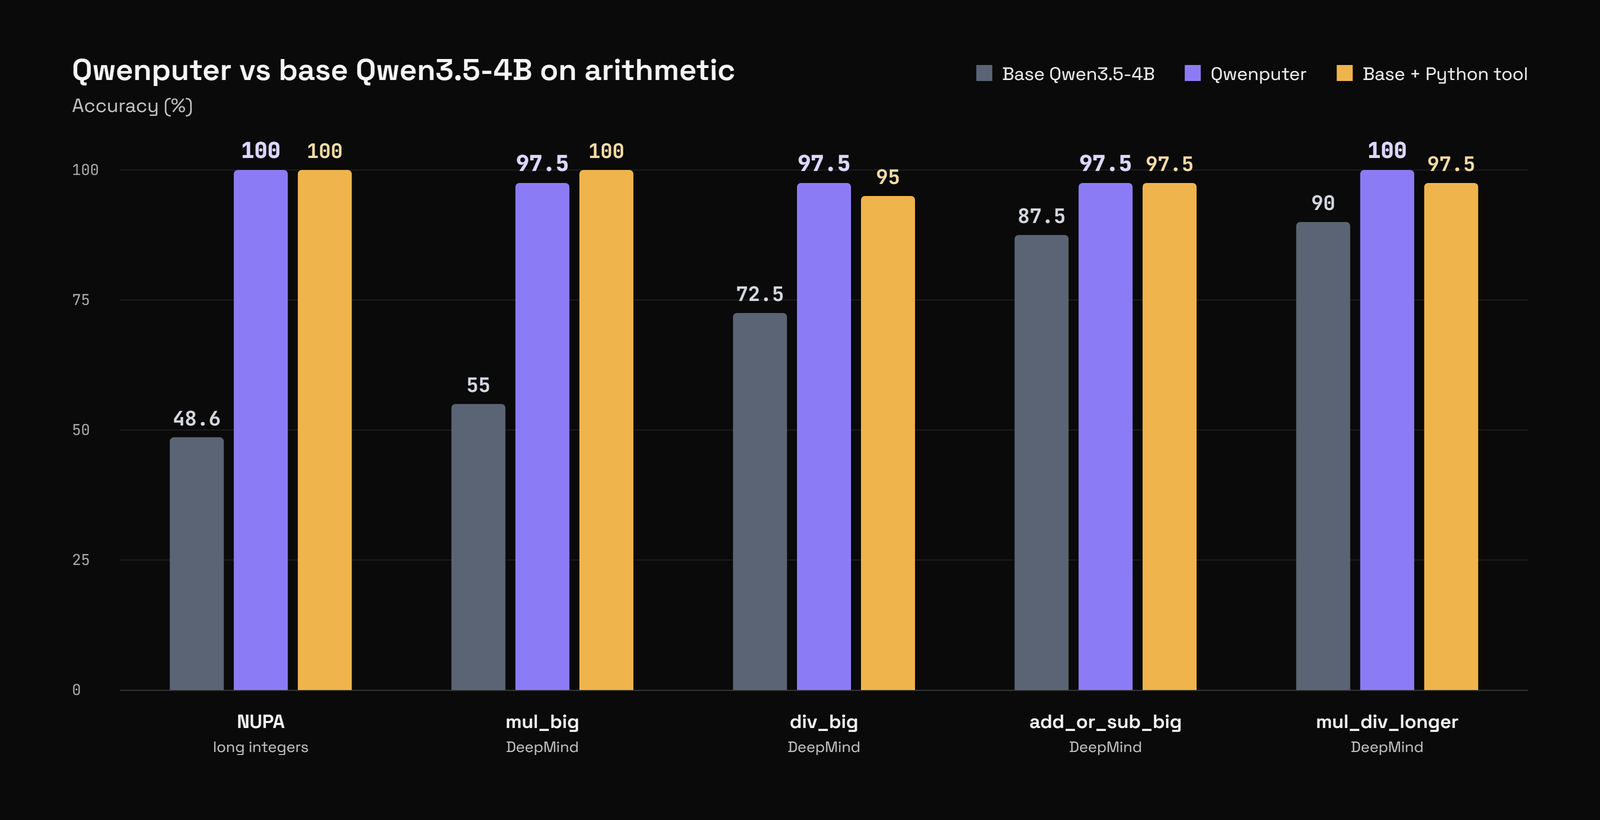 Abb.: Leistungsvergleich auf arithmetischen Benchmarks zwischen Qwenputer, dem Basismodell Qwen3.5-4B und einer externen Python-Toolchain. Quelle: divagr.com
53.000 Token in der Matrix: Zustandsadressierung ersetzt vollständige Kontextscans
Wenn die Zustandsmatrix als überschreibbarer Speicher fungieren kann, liegt der nächste logische Schritt in ihrer Abstraktion zu permanentem Speicher. In einem experimentellen Zweig entwickelte der Autor ein leichtgewichtiges Dateisystem, das vollständig innerhalb der Gewichtszustände operiert. Es bildet Verzeichnispfade mittels Hashfunktionen auf 1024 feste Slots im DeltaNet-Zustand ab; Kollisionen werden über lineare Sondierung (linear probing) aufgelöst.
Diese Speicherstruktur fasst bis zu 512 unabhängige Dateien, was etwa 53.000 Text-Token entspricht. Beim Abrufen einer Datei durchläuft das Netzwerk lediglich 2 bis 3 Zustandsschritte, anstatt den gesamten bisherigen Kontext Zeichen für Zeichen zu durchforsten. Der Adressierungsmechanismus reduziert den Retrieval-Aufwand bei langen Kontexten von einer linearen Abhängigkeit der Kontextlänge auf konstante Zustandsschritte.
Diese physische Zustandspersistenz verändert das Gedächtnismodell für mehrstufige Dialoge grundlegend. Nach Gesprächsende kann der Zustand samt Dateisystem und Arbeitsspeicher verlustfrei exportiert und beim nächsten Start direkt wieder geladen werden. Bei sitzungsübergreifenden Faktenaktualisierungen erzielte das herkömmliche Aneinanderhängen von Kontexten nur 30 % Genauigkeit. Eine externe Python-Gedächtnisdatenbank kam auf 78,9 %, während Qwenputer allein über interne Zustandsaktualisierungen 90 % erreichte.
Klassische Architekturen lagern den Gesprächszustand in externe Vektordatenbanken aus, was bei jedem Aufruf Kosten für Text-Parsing und Kontextfenster-Verbrauch verursacht. Qwenputer fixiert Erinnerungen an physischen Adressen der rekurrenten Matrix, sodass Aktualisierungen reine inkrementelle Zeilenschreibvorgänge darstellen. Dieses Experiment belegt das enorme Potenzial nativer Modellzustände als langfristige, exakte Wissensspeicher.
Doppelter Speicherbedarf: Autarke Ausführung ohne externe Sandboxen
Deterministische Hardwarelogik in ein neuronales Netz einzubetten, verlangt Systemkompromisse. Der erste betrifft den Speicherplatzbedarf. Um die Rechenpfade präzise abzubilden, enthalten die 11 vorgeschalteten Schichten eine erhebliche Menge nullgepufferter Parameter. Der modifizierte Checkpoint (checkpoint) wuchs auf 18,8 GB an – beinahe das Doppelte des Basismodells.
Die Ausführungslatenz stellt einen weiteren spürbaren Effizienzverlust dar. Bei normaler Inferenz entspricht jedes erzeugte Token einem Wort im Ausgabetext. In Qwenputer hingegen beansprucht jeder virtuelle CPU-Befehl mehrere interne Decodier-Token. Auf einer einzelnen NVIDIA L4-GPU erreicht der Batch-Executor einen Durchsatz von etwa 3.200 CPU-Token pro Sekunde und arbeitet damit spürbar langsamer als native Hardware.
Auch die softwaretechnische Komplexität verlagert sich auf die Treiberebene. Damit Zwischenbefehle den Ausgaberaum für natürliche Sprache nicht verunreinigen, kann das Modell Text nicht direkt über Standard-Schnittstellen ausgeben. Es greift auf einen dedizierten RvChat-Treiber zurück, um Firmware einzuschleusen. Dieser fängt Low-Level-Befehlsspuren der CPU ab und maskiert sie, sodass lediglich der finale Ausführungszustand an die Texterzeugungsschicht übergeben wird.
Verdoppelter Speicherbedarf und zusätzliche Inferenzzyklen im Tausch gegen einen völlig autarken Betrieb auf einer einzelnen GPU markieren einen bemerkenswerten Trade-off. Das Gesamtsystem benötigt weder eine isolierte Sandbox noch privilegierte Container auf dem Hostsystem. Auf einer einzelnen Grafikkarte mit 24 GB VRAM führt das Modell eigenständig vollständige Binärprogramme in einer strikt begrenzten Umgebung aus.
Rechenoperationen in Matrixzuständen: Aushebelung der Chain-of-Thought-Prüfung
Über den Zuwachs an Rechengenauigkeit hinaus legt dieses Experiment ein fundamentales Problem der KI-Sicherheit offen. Sobald interne Zustände zu deterministischer Adressierhardware umgebaut werden, mutieren sie gleichzeitig zu perfekten Blackboxen zur Informationsverschleierung. Der Autor weist in seinen Analysen darauf hin, wie diese Architektur bestehende Sicherheitsmechanismen untergräbt.
Gängige Sicherheitsüberprüfungen und Verhaltensmonitore stützen sich massiv auf Chain-of-Thought-Ansätze (Gedankengänge). Prüfmodelle lesen Zwischenschritte Token für Token mit, um bösartige Absichten oder schädliche Pläne rechtzeitig zu erkennen. Unter der Architektur von Qwenputer wickeln sich komplexe mehrstufige Logikketten und Speicherzugriffe jedoch komplett innerhalb der Zustandsmatrix ab. Der gesamte Ablauf hinterlässt keinerlei Spuren in Form expliziter Ausgabetoken.
Externe Kontrollinstanzen sehen lediglich unauffällige Texteingaben und finale Schlussfolgerungen. Hunderttausende Hardware-Berechnungsschritte hinterlassen im Kontextfenster keine textuelle Spur. Sobald Argumentation von sichtbarer Textgenerierung in stumme Matrixadressierung übergeht, verlieren alle auf Zwischentoken angewiesenen Sicherheitsprüfungen ihre Wirkung. Die unsichtbare Verschleierung von Ausführungslogik innerhalb von Modellgewichten wird damit von der Theorie zur praktischen Realität.
Der eigentliche Wert von Qwenputer liegt in der Neudefinition unseres Verständnisses von Modellpräzision. Exakte Berechnungen erfordern weder ins Unermessliche skalierende Parameter noch schwerfällige externe Code-Sandboxen. Sofern die Netzwerktopologie über deterministische Adressierfähigkeiten verfügt, liefert auch ein 4B-Modell fehlerfreie Berechnungen auf Hardware-Niveau. Strukturelle Deterministik verändert die Gesetzmäßigkeiten des internen Informationsflusses – und stellt Transparenzprüfungen vor eine völlig neue technologische Realität.
Weiterführende Links:
- Technischer Projektbericht zu Qwenputer
- ICML 2021 Paper: Linear Transformers Are Secretly Fast Weight Programmers
- Offizielle Spezifikationen und Konformitätstests der RISC-V-Befehlssatzarchitektur


