ゲーティングを1に固定、浮動小数点メモリを物理RAMへ変える
連続1800万ステップのCPU命令を実行し、エラーカウントはゼロのまま。約23万ビットの出力結果は、標準ハードウェアリファレンスとビット単位で完全一致した。このベンチマークは開発者Divyansh Agrawalが公開したオープンソースプロジェクト「Qwenputer」によるものだ。パラメータの積み増しや外部インタプリタに頼ることなく、32ビットRISC-V仮想プロセッサをQwen3.5-4Bの重み内部へ直接コンパイルした。
大規模言語モデル(LLM)にとって算術計算は長年の弱点だった。アテンション機構は高次元の確率的連想に基づくため、浮動小数点の重みで長大な桁数を累積すると不可避的にドリフトが生じる。一般的な対策は、巨大なパラメータ数による暗記に頼るか、計算処理を外部のPythonプロセスへ委譲することだった。Qwenputerはこれらとは異なるエンジニアリング路線を選択した。ネットワークのトポロジー内部に厳密なハードウェア的決定性を直接構築したのである。
この設計の理論的拠り所となったのは、Schmidhuberらによる2021年の論文だ。同研究は、線形アテンションが本質的に「高速重みプログラマ(fast weight programmers)」であることを証明した。Qwen3.5が採用するGated DeltaNetアーキテクチャにおいて、隠れ状態はデルタルールに従って更新される。ここでゲーティングを1に固定し、書き込み強度も1に設定すると、状態行列の更新は純粋なアドレス上書き操作へと縮退する。
one-hot vectorをキー・バリュー入力として用いることで、モデルによる状態行列への読み書きは行単位の厳密なアドレス指定へと変化する。ゲーティングの固定と直交入力ベクトルの組み合わせにより、ニューラルネットワークの状態行列を行単位で読み書き可能な物理RAMへと変換した。汎用レジスタ(register)、プログラムカウンタ(program counter)、メインメモリはすべて状態行列の固定行に割り当てられている。精度は統計的な確率収束ではなく、構造的制約によって担保される。
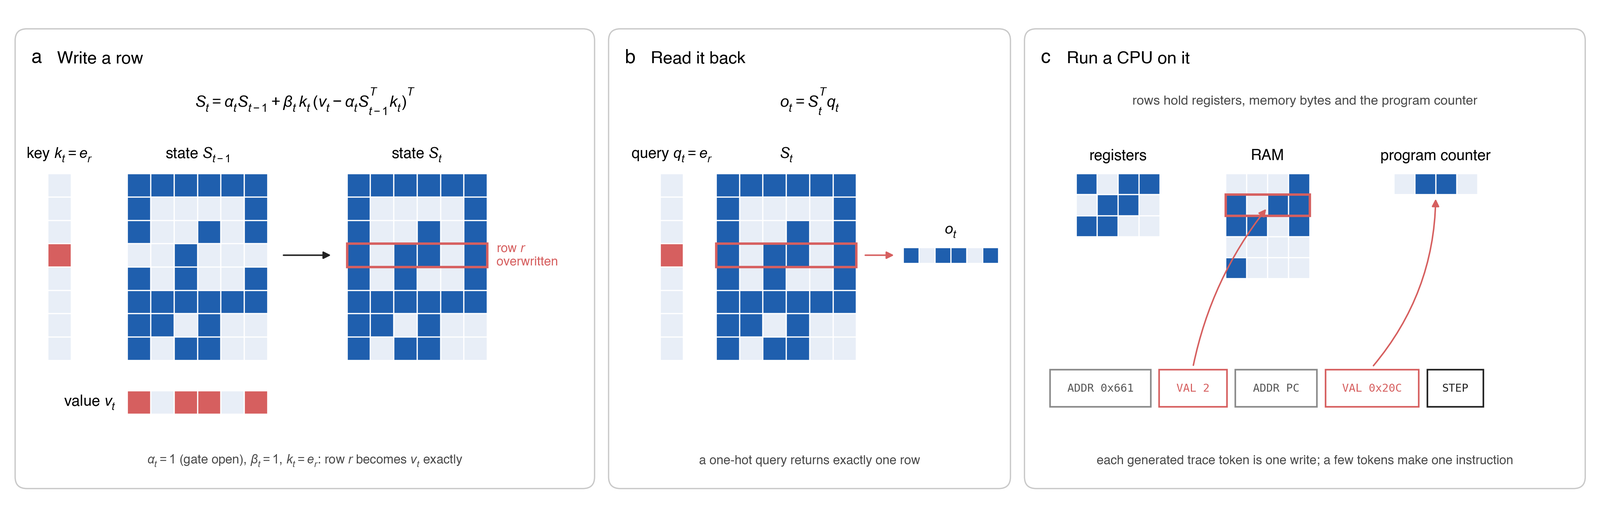 図:物理アドレス指定メモリとして再構築されたGated DeltaNet状態行列。レジスタ、メモリ、プログラムカウンタに固定行が割り当てられている。出典:divagr.com
11層の前置トポロジーで1800万命令をノーエラー完走
実装面において、著者はQwen本来の32層構造の直前に11層のCPU専用プレフィックスネットワークを挿入した。ベースモデルの重みは凍結されたままで、タスクルーティングとスケジューラとしてのみ機能する。算術演算は前置層の中で独立して実行される。システム全体としてRV32IM命令セットアーキテクチャを完全実装し、さらにZba拡張と専用の多倍長整数演算ユニットを備えている。
厳格な検証テストがこのトポロジー再構築の有効性を裏付けている。同システムはRISC-V公式コンプライアンススイートをノーエラーでパスした。一切の介入なしに1800万命令を完走し、同一プログラムをQEMUエミュレータ上で実行した結果と完全に一致した。
DeepMindの算術ベンチマークでは、モデル規模に対する構造的優位性がより鮮明に表れている。除算タスクdiv_bigにおいて、未改造のQwen3.5-4Bベースモデルの正解率は72.5%にとどまる。外部Pythonツールを連携させると95%まで向上するが、Qwenputerは97.5%に達した。長桁の乗算・除算が混在するタスクでは、Qwenputerが100%の満点を記録し、Pythonツールチェーンを2.5ポイント上回った。
長整数ベンチマークNUPAではベースモデルの正解率が48.6%まで急落する一方、Qwenputerは100%満点を維持した。算術タスクで満点を取るためにモデルを巨大化させる必要はなく、適切な代数実行ユニットを与えるだけでよい。さらに重要なのは、汎用的な言語能力が損なわれていない点だ。改修後モデルの汎用コーパスに対するKL divergenceは6e-4であり、ベースラインのノイズフロア5e-4に極めて近い水準を維持している。
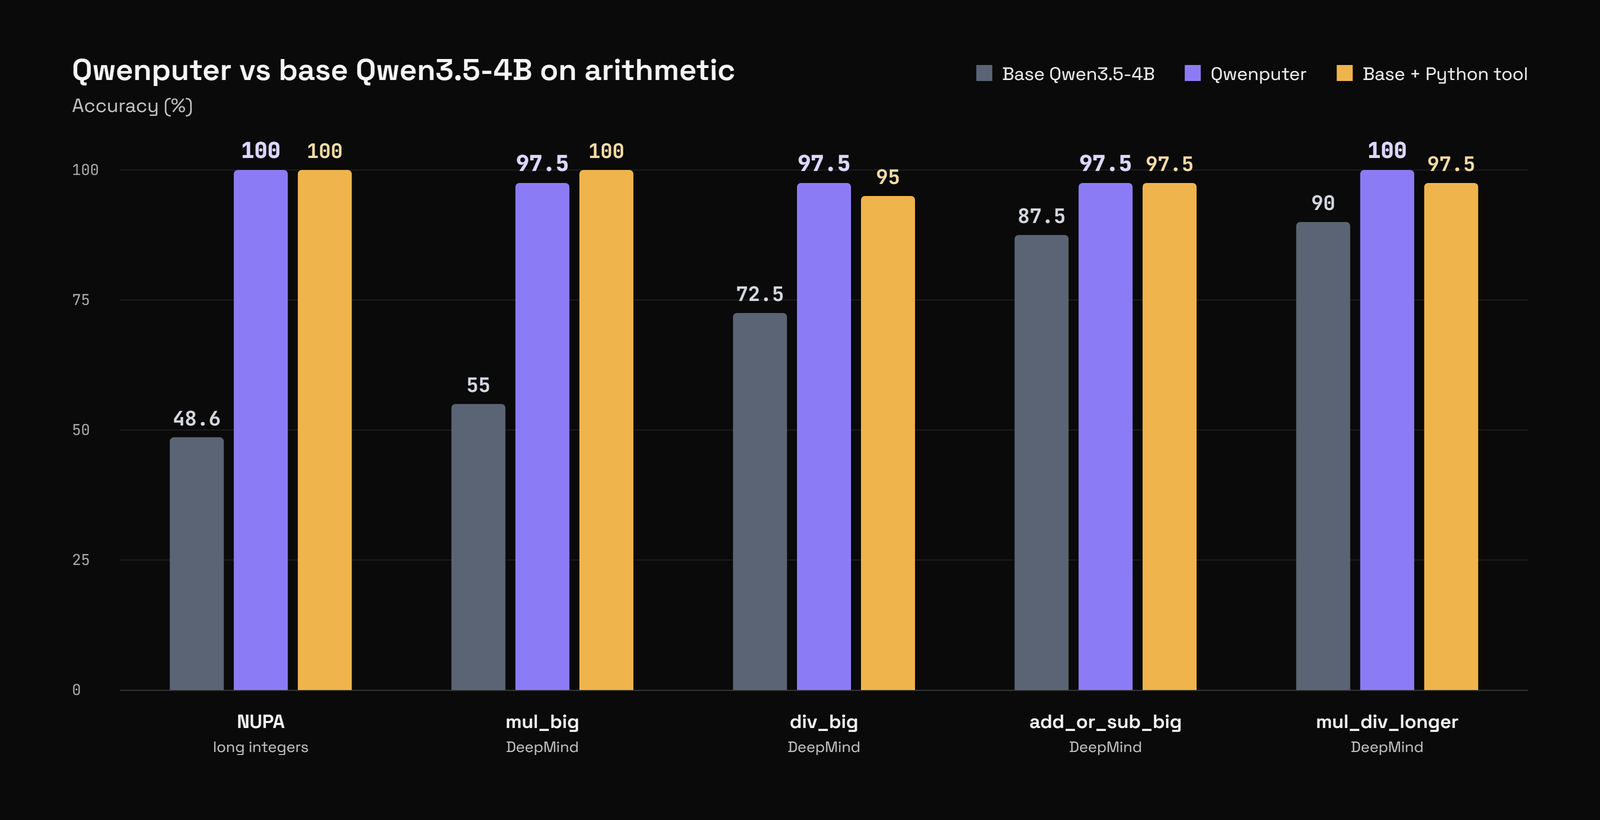 図:Qwenputer、ベースモデルQwen3.5-4B、外部Pythonツールチェーンの算術ベンチマーク比較。出典:divagr.com
53,000トークンを行列に格納、全走査を不要にする状態アドレッシング
状態行列が上書き可能なメモリとして機能する以上、これを永続化ストレージへと抽象化することは自然な流れだった。著者は実験ブランチにおいて、重み状態の内部で動作する軽量ファイルシステムを構築した。ディレクトリパスをハッシュ関数によってDeltaNet状態の1024個の固定スロットにマッピングし、キー衝突が発生した場合はlinear probing(線形探索法)によって順次割り当てる。
このストレージ構造は最大512個の独立したファイル(テキスト換算で約53,000トークン)を格納できる。ファイル検索時、ネットワークは2〜3ステップの状態遷移を実行するだけでよく、入力コンテキスト全体を逐次スキャンする必要がない。アドレッシング機構により、長文コンテキストの検索オーバーヘッドはコンテキスト長に対する線形依存から定数時間の状態ステップへと圧縮される。
このような物理的状態の永続性は、マルチターン対話の記憶モデルを一変させる。対話終了時、ファイルシステムとメモリを含む内部状態を劣化なしにエクスポートし、次回のセッション開始時に直接ロードできる。セッションをまたぐ事実更新テストにおいて、従来のコンテキスト結合方式の正解率はわずか30%だった。外部Pythonメモリデータベースでも78.9%だったが、Qwenputerは状態更新のみで90%を達成した。
従来のアーキテクチャでは外部ベクトルDBに状態を保存するため、ターンごとにテキストパースとコンテキスト枠の消費が発生していた。Qwenputerは再帰行列の物理アドレスへ直接記憶を固定化するため、更新は行レベルのインクリメンタルな書き込み1回で完結する。この実験は、モデル本来の内部状態が長期にわたる高精度な知識ベースを担うエンジニアリングの可能性を示している。
メモリフットプリントは倍増、単一GPUで外部サンドボックスから脱却
確定的ハードウェアロジックをニューラルネットワークに組み込むには、システムトレードオフを受け入れる必要がある。第一にストレージ容量の増大だ。計算パスを整合させるため、追加された11層のネットワークには大量のゼロパディングパラメータが含まれる。改造後のチェックポイント(checkpoint)は18.8 GBに達し、元のベースモデルのほぼ2倍のサイズとなった。
実行レイテンシも無視できない性能損失だ。標準的な推論では生成された各トークンがそのまま出力テキストとなる。しかしQwenputerでは、仮想命令1ステップにつき複数の内部デコードトークンを消費する。単一のNVIDIA L4 GPUにおいて、バッチ実行エンジンのスループットは毎秒約3200 CPUトークンであり、ネイティブハードウェアでの実行と比べると低速だ。
システムエンジニアリングの複雑性もドライバ層へと移転している。中間命令の実行トレースが自然言語空間を汚染するのを防ぐため、モデルは通常のインターフェース経由で文字を直接出力できない。専用のRvChatドライバを通じてファームウェアを注入し、低レベルなCPU命令トレースを遮断・マスクした上で、最終的な実行状態のみをテキスト生成層へ渡している。
モデルサイズ倍増と追加の推論サイクルを受け入れることで、単一GPUでの自己完結動作を獲得するという独特なトレードオフが成立している。ホストマシン上で分離サンドボックスを構成したり、特権コンテナをデプロイしたりする必要はない。24 GBのVRAMを搭載した単一GPU上で、モデル自身が厳密に制限された環境としてバイナリプログラムを完全に実行できる。
行列状態に潜む演算、CoT監査の防壁を無効化する
算術精度の飛躍にとどまらず、この実験はAI安全性に関する重大な問いを提起している。ニューラルネットワークの内部状態が確定的なアドレッシングハードウェアへと再構築された結果、そこは本質的な情報のブラックボックスとなる。著者はその後の考察で、このアーキテクチャが既存のセーフティ防壁に与える衝撃を指摘している。
現在主流の安全性審査や振る舞い監視システムは、思考の連鎖(Chain-of-Thought)に強く依存している。監視モデルは推論過程の中間トークンを一語一語精査することで、悪意ある計画の有無を判定する。だがQwenputerのアーキテクチャでは、複数ステップの複雑な推論やメモリの読み書きがすべて状態行列の内部で完結する。実行プロセスの痕跡が外部の明示的トークンとして表出することはない。
外部の監視システムに見えるのは、ごく普通の自然言語入力と最終的な結論だけだ。内部で行われた数十万ステップに及ぶハードウェア級の演算は、コンテキストウィンドウに一切文字として残らない。推論が明示的なテキスト生成から静かな行列アドレッシングへと移行したことで、中間テキストの痕跡に依存する安全検出プローブはすべて無力化される。モデルの重み内部に不可視の実行ロジックを隠蔽することが、現実的な技術として成立してしまったのだ。
Qwenputerの本質的な価値は、モデル精度に対する前提を覆した点にある。高精度な計算を実現するために、パラメータ数を積み上げたり巨大な外部コードサンドボックスを用意したりする必要はない。ネットワークトポロジーに確定的アドレッシング能力が備わっていれば、4B規模のモデルであってもエラーゼロのハードウェア級計算を実行できる。構造的決定性はニューラルネットワーク内部の情報伝達ルールを書き換え、ブラックボックス状態の透明性監査に新たな技術的現実を突きつけている。
参考リンク:
- Qwenputer プロジェクト技術レポート
- ICML 2021 論文 Linear Transformers Are Secretly Fast Weight Programmers
- RISC-V 公式命令セットアーキテクチャ仕様書およびコンプライアンス検証スイート