
Bloquear las compuertas en 1: transformar memoria de punto flotante en RAM física
18 millones de instrucciones de CPU ejecutadas de forma ininterrumpida y el contador de fallos se mantuvo en cero. Cerca de 230.000 bits de salida coincidieron bit a bit con el hardware estándar de referencia. Esta serie de pruebas proviene de Qwenputer, un proyecto de código abierto publicado por el desarrollador Divyansh Agrawal. Evitando la acumulación masiva de parámetros y los intérpretes externos, el autor compiló un procesador virtual RISC-V de 32 bits directamente en los pesos de Qwen3.5-4B.
Los grandes modelos de lenguaje han mostrado históricamente dificultades en tareas aritméticas. Dado que los mecanismos de atención se fundamentan en asociaciones probabilísticas de alta dimensión, la acumulación sucesiva de números largos sobre pesos en coma flotante sufre desviaciones inevitables. Las alternativas habituales recurren a la memorización forzada mediante modelos gigantescos o delegan las operaciones en procesos externos de Python. Qwenputer ha tomado una vía de ingeniería completamente distinta: construir un determinismo de hardware estricto dentro de la propia topología de la red.
La base teórica descansa en el influyente artículo de 2021 de Schmidhuber et al., que demostró que los transformadores lineales son esencialmente programadores de pesos rápidos (fast weight programmers). En la arquitectura Gated DeltaNet de Qwen3.5, los estados ocultos evolucionan según reglas delta. Cuando la compuerta se fija en 1 y la intensidad de escritura se establece en 1, la actualización de la matriz de estados se reduce a una operación directa de sobrescritura de direcciones.
Al usar vectores one-hot como entradas de clave y valor, la lectura y escritura en la matriz de estados se transforma en un direccionamiento exacto fila por fila. El bloqueo de compuertas combinado con vectores de entrada ortogonales transforma la matriz de estados de la red neuronal en una RAM física con lectura y escritura por filas. Los registros de propósito general (register), el contador de programa (program counter) y la memoria principal quedan asignados a filas fijas de la matriz. La precisión proviene del rigor estructural y no de la convergencia de probabilidades estadísticas.
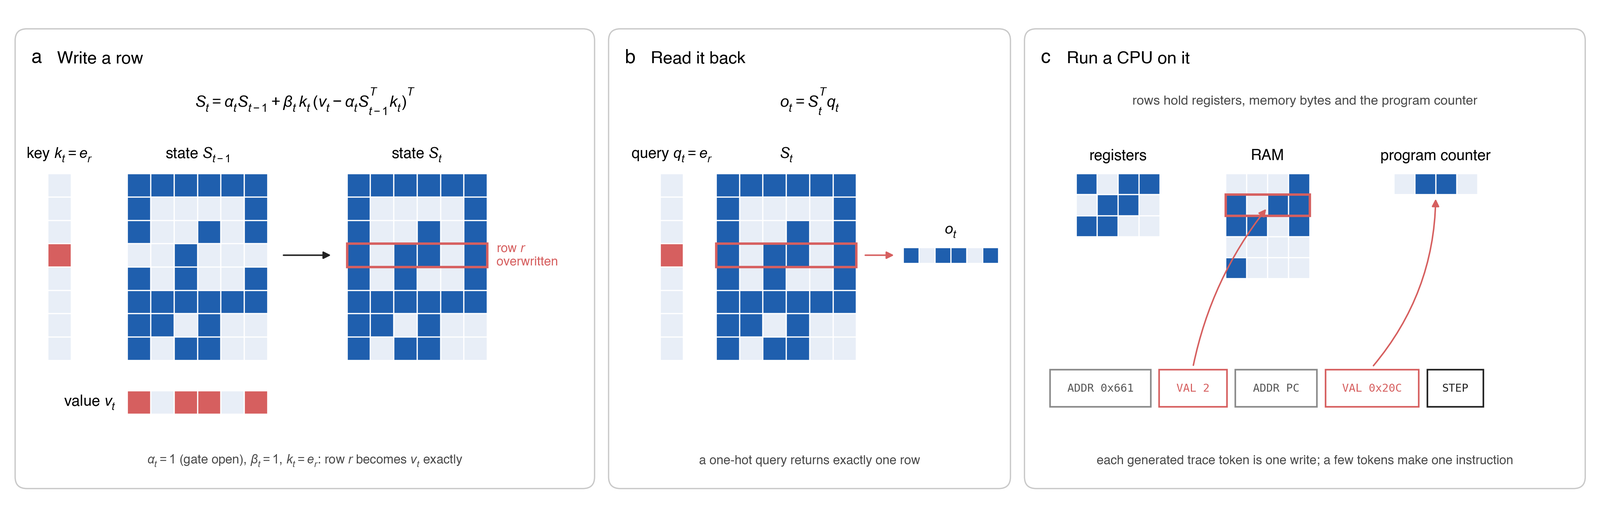 Figura: La matriz de estados de Gated DeltaNet reestructurada como memoria direccionable físicamente, asignando filas fijas a registros, memoria y contador de programa. Fuente: divagr.com
11 capas de prefijo ejecutan 18 millones de instrucciones sin errores
En el plano de la implementación, el autor insertó una red de prefijo dedicada a CPU de 11 capas delante de las 32 capas originales de Qwen. Los pesos base originales permanecen congelados y actúan únicamente como un enrutador y despachador de tareas. Las operaciones aritméticas se ejecutan de manera aislada dentro de las capas de prefijo. El sistema completo implementa la arquitectura de conjunto de instrucciones RV32IM, sumando la extensión Zba y una unidad específica para enteros de precisión múltiple.
Las exigentes pruebas de validación confirman la solidez de este rediseño topológico. El sistema superó la suite oficial de conformidad de RISC-V sin un solo error. En ejecución autónoma y continua procesó 18 millones de instrucciones, coincidiendo bit a bit con los resultados arrojados por el emulador QEMU.
En los benchmarks de aritmética de DeepMind, la ventaja de la estructura sobre la escala pura resulta aún más palpable. Para la tarea de división div_big, el modelo base Qwen3.5-4B sin modificar alcanza un 72,5 % de precisión. Con herramientas externas de Python llega al 95 %, mientras que Qwenputer alcanza el 97,5 %. En tareas combinadas de multiplicación y división largas, Qwenputer obtuvo una puntuación perfecta del 100 %, superando a la cadena de herramientas de Python por 2,5 puntos porcentuales.
En el test de enteros largos NUPA, la precisión del modelo base cayó drásticamente al 48,6 %, mientras que Qwenputer conservó el 100 %. Lograr la máxima puntuación en aritmética no exige pasar a modelos gigantes; solo requiere dotar al sistema de las unidades algebraicas de ejecución correctas. Lo que es aún más relevante: las capacidades generales del lenguaje no sufrieron degradación. La divergencia KL (KL divergence) del modelo modificado sobre corpus generales fue de 6e-4, rozando el umbral de ruido base de 5e-4.
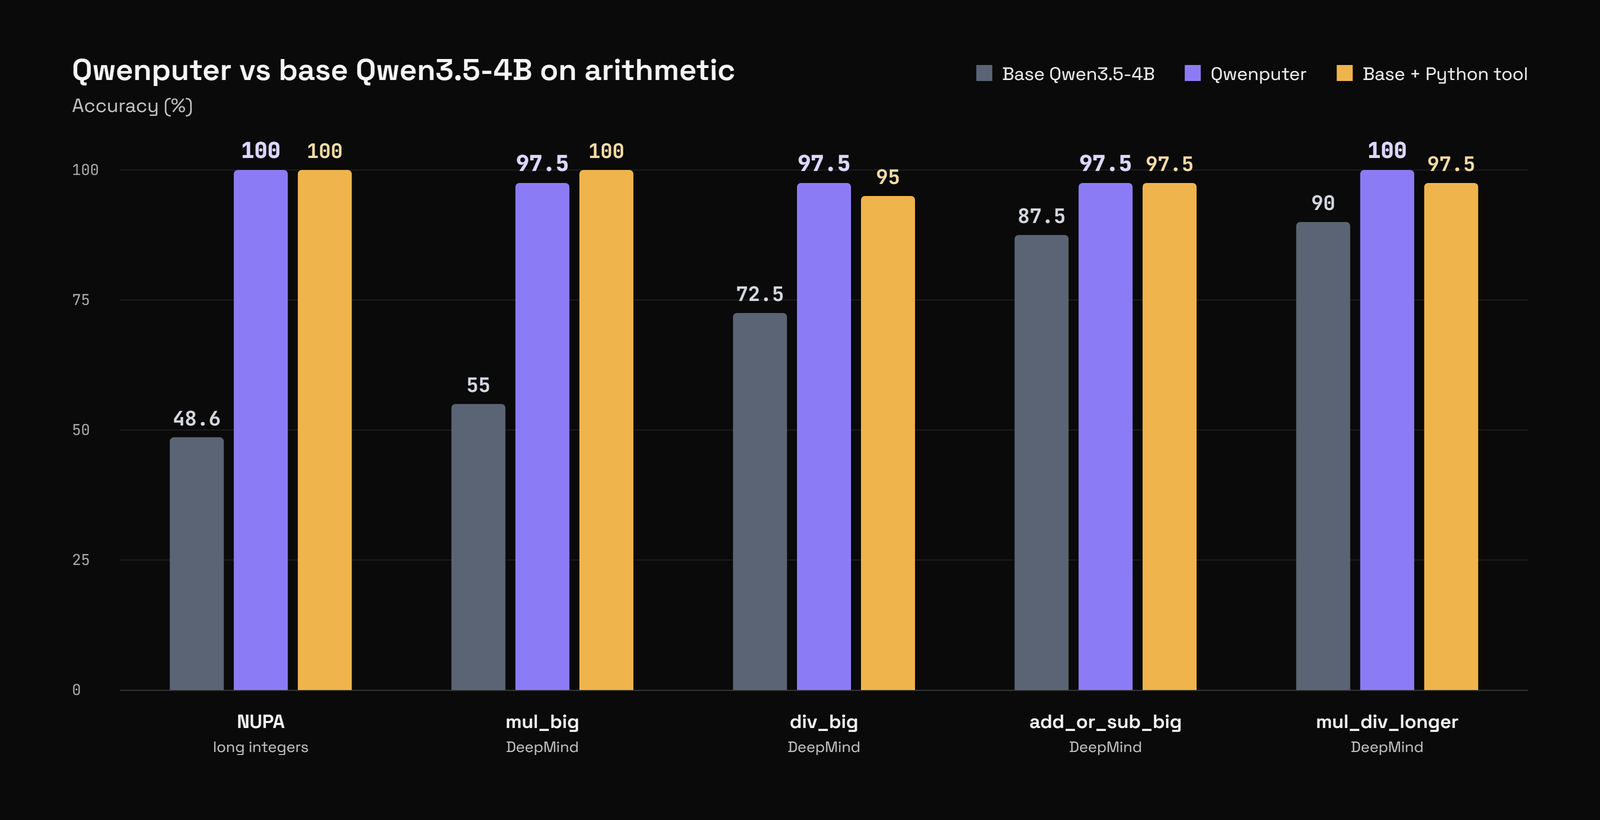 Figura: Comparativa de rendimiento en benchmarks aritméticos entre Qwenputer, el modelo base Qwen3.5-4B y una cadena de herramientas externa en Python. Fuente: divagr.com
53.000 tokens en la matriz: el direccionamiento de estados reemplaza el escaneo completo
Una vez que la matriz de estados actúa como memoria sobrescribible, abstraerla como almacenamiento persistente es un paso natural. En una rama experimental, el autor construyó un sistema de archivos ligero que opera por completo en los estados de los pesos. El sistema asigna rutas de directorios mediante funciones hash a 1.024 ranuras fijas del estado de DeltaNet, resolviendo colisiones mediante sondeo lineal (linear probing).
Esta estructura de almacenamiento alberga hasta 512 archivos independientes, lo que equivale a unos 53.000 tokens de texto. Para recuperar un archivo, la red solo necesita ejecutar entre 2 y 3 transiciones de estado, sin requerir un barrido secuencial de todo el historial de texto previo. El mecanismo de direccionamiento comprime el coste de recuperación en contextos largos, pasando de una dependencia lineal de la longitud a pasos de estado de tiempo constante.
Esta persistencia física de estados redefine el modelo de memoria en conversaciones de múltiples turnos. Al finalizar una sesión, el estado que contiene el sistema de archivos y la memoria RAM puede exportarse sin pérdidas y cargarse de nuevo en el siguiente inicio. En pruebas de actualización de hechos entre sesiones, la concatenación clásica de contextos apenas logró un 30 % de acierto. Una base de datos externa de memoria en Python alcanzó el 78,9 %, mientras que Qwenputer logró el 90 % exclusivamente mediante actualizaciones de estado.
Las arquitecturas convencionales almacenan el estado en bases de datos vectoriales externas, asumiendo en cada turno la sobrecarga de parsear texto y ocupar ventana de contexto. Qwenputer fija los recuerdos en direcciones físicas de la matriz recurrente, reduciendo las actualizaciones a una escritura incremental por filas. Este experimento demuestra el potencial de ingeniería que tienen los estados internos nativos para albergar almacenes de conocimiento exactos y duraderos.
Doble consumo de memoria: ejecución autónoma en GPU sin sandbox externo
Integrar lógica de hardware determinista dentro de una red neuronal conlleva contrapartidas a nivel de sistema. La primera es el incremento en el tamaño de almacenamiento. Para ajustarse a las rutas de cálculo, las 11 capas añadidas incorporan una gran cantidad de parámetros de relleno con ceros. El archivo de comprobación (checkpoint) modificado alcanza los 18,8 GB, prácticamente el doble del tamaño del modelo base.
La latencia de ejecución constituye otra penalización destacada. En la inferencia estándar, cada token generado equivale a texto visible final. En Qwenputer, cada instrucción virtual consume varios tokens internos de descodificación. En una única GPU NVIDIA L4, el ejecutor por lotes procesa en torno a 3.200 tokens de CPU por segundo, un ritmo más lento que en entornos nativos.
La complejidad de ingeniería se desplaza asimismo a la capa de control. Para impedir que las trazas intermedias de las instrucciones ensucien la salida en lenguaje natural, el modelo no puede emitir caracteres mediante interfaces estándar. Depende de un controlador exclusivo RvChat para inyectar firmware, interceptando y ocultando las trazas de CPU de bajo nivel para devolver únicamente el estado de ejecución definitivo a la capa de generación de texto.
Asumir el doble de tamaño y ciclos adicionales de inferencia a cambio de operar de forma autónoma en una única GPU constituye un compromiso de ingeniería singular. El sistema prescinde por completo de entornos sandbox aislados en el host o contenedores con privilegios. En una única tarjeta gráfica de 24 GB de VRAM, el modelo ejecuta programas binarios completos en un entorno estrictamente acotado.
Computación oculta en matrices: quiebra de la auditoría por Chain-of-Thought
Más allá del salto en precisión aritmética, este experimento plantea un dilema capital para la seguridad de la IA. Al transformarse el estado interno en hardware de direccionamiento determinista, se convierte de forma natural en una caja negra opaca para ocultar información. El autor alertó en investigaciones posteriores sobre el impacto que esta estructura provoca en las defensas de seguridad actuales.
La mayoría de los sistemas actuales de revisión de seguridad y monitorización de comportamiento dependen de la cadena de pensamiento (Chain-of-Thought). Los modelos de supervisión leen palabra por palabra los tokens intermedios del razonamiento para detectar planes maliciosos. Sin embargo, bajo la arquitectura de Qwenputer, el razonamiento complejo multietapa y las lecturas/escrituras en memoria ocurren íntegramente dentro de la matriz de estados, sin emitir ningún token explícito al exterior.
Los sistemas externos de control solo perciben entradas cotidianas de lenguaje natural y conclusiones finales. Cientos de miles de cálculos intermedios a nivel de hardware no dejan rastro alguno en la ventana de contexto. Cuando el razonamiento pasa de la generación explícita de texto al silencioso direccionamiento matricial, todas las sondas de seguridad basadas en el texto intermedio quedan anuladas. La ocultación de lógica ejecutable dentro de los pesos del modelo deja de ser una hipótesis teórica para convertirse en una realidad práctica.
El valor esencial de Qwenputer radica en replantear las bases con las que concebimos la precisión de los modelos. Obtener cálculos exactos no requiere inflar parámetros indefinidamente ni mantener complejos sandboxes externos de código. Con una topología de red capaz de direccionamiento determinista, un modelo de tamaño 4B puede ofrecer cálculos de nivel de hardware con cero errores. El determinismo estructural redefine el flujo interno de la información en las redes neuronales y sitúa la auditoría de cajas negras ante una realidad técnica sin precedentes.
Enlaces de referencia:
- Informe técnico del proyecto Qwenputer
- Artículo de ICML 2021: Linear Transformers Are Secretly Fast Weight Programmers
- Especificaciones de la arquitectura de instrucciones de RISC-V y suite de pruebas de conformidad


