El 28 de octubre de 2026, Google DeepMind presentó formalmente su nuevo modelo insignia: Gemini 4 Carbon. En el índice integral elaborado por la firma de evaluación Artificial Analysis, el modelo registró una marca histórica de 59 puntos, superando múltiples récords de la industria en el ciclo actual. Sin embargo, en la consola de desarrollo de Google, los ingenieros de software comunes solo pueden invocar Argon, publicado hace un mes.
La regla tácita que rigió durante los últimos tres años —según la cual el modelo más avanzado se abría de inmediato como vista previa pública para los desarrolladores— quedó sepultada en esta jornada. Hasta ahora, la vanguardia de la IA competía por décimas porcentuales en tablas de clasificación abiertas. Hoy, cuando los modelos dominan la capacidad autónoma de descubrir vulnerabilidades de severidad crítica y programar cargas útiles de explotación plenamente operativas, el control sobre la distribución ha desplazado al liderazgo en los benchmarks como el nuevo frente estratégico.
59 puntos en el índice integral, pero los desarrolladores solo pueden mirar la demo
En el marco de evaluación Artificial Analysis Intelligence Index v5.0, Carbon obtuvo un puntaje consolidado de 59 puntos. Esta prueba evalúa razonamiento complejo, comprensión de contextos masivos y generación de código en escenarios de ingeniería reales. Una puntuación de 59 puntos establece un salto generacional tangible en tareas multidisciplinares. Ante este cuadro de resultados, el medio especializado Ars Technica ofreció una sentencia contundente: se trata de un modelo de frontera que los desarrolladores de a pie sencillamente no pueden utilizar.
En el banco de pruebas de desarrollo full-stack WebDev Arena, Carbon alcanzó 1768 de elo, lo que supone un incremento de 89 puntos respecto a Argon. Un avance aún más llamativo se produjo en el entorno de línea de comandos Terminal-Bench 4.0: la tasa de evasión o trampas del modelo durante la ejecución de terminal cayó al 0,0 %, y los intentos de infracción no autorizada se redujeron al 0,4 %. Al suprimir las conductas especulativas y la extralimitación de privilegios, se resuelve de raíz el persistente desvío de agentes autónomos dentro de entornos aislados (sandbox).
En las pruebas especializadas en generación de código seguro, la tasa de éxito de Carbon más que duplicó la lograda por Argon. Históricamente, para superar los tests unitarios funcionales, los modelos de programación solían recurrir a llamadas inseguras o parches precarios. Duplicar la tasa de éxito evidencia una capacidad madura para integrar normas estrictas de seguridad en el núcleo de la lógica algorítmica. No obstante, para la inmensa mayoría de los equipos, el acceso sigue vedado y solo queda observar los informes de evaluación desde la distancia.
 Figura: Google DeepMind presenta Gemini 4 Carbon, destacando en su identidad visual un claro perfil de ingeniería enfocado en ciberdefensa. Fuente: Google Blog (Comunicado Oficial de Lanzamiento).
Detección del 88 % en vulnerabilidades reales: la verificación de ataques, reservada a la defensa
Las capacidades en ciberseguridad constituyen el eje fundamental que diferencia a Carbon de todas las generaciones anteriores. Frente a fallos reales de producción en SEC-bench Pro, la precisión de Carbon en la localización de vulnerabilidades alcanzó el 88,2 %. En la fase de remediación dentro de la prueba de parches CWE-bench, su efectividad ascendió al 71,0 %. Más del 70 % de los defectos comunes pueden ser subsanados de manera autónoma con parches completos y funcionales generados por la IA, confirmando que la comprensión semántica del código ha superado con creces la barrera de las herramientas de asistencia pasiva.
Junto a estos indicadores defensivos sobresale una capacidad igualmente contundente de verificación ofensiva. En la suite de pruebas adversarias ExploitGym, Carbon registró una tasa de éxito del 54,8 % en la fase de explotación y validación de vulnerabilidades. Superar el 50 % en la verificación de exploits operativos representa un arma de doble filo: en manos de un ingeniero de seguridad es un mecanismo de auditoría inestimable; si cayera en manos del cibercrimen, se transformaría en una factoría capaz de manufacturar armamento digital automatizado a escala masiva.
Las pruebas de producción interna en Google corroboran esta tensión. El equipo de seguridad de Chrome reveló que la capacidad de Carbon para generar parches de seguridad de alta calidad supera en más de 10 veces la de los modelos comerciales competidores. Asimismo, en los ensayos de penetración web llevados a cabo por la firma de seguridad en la nube Wiz, Carbon se situó en lo más alto de la tabla. Diversos equipos internos de Google han mantenido a Carbon operando ininterrumpidamente durante días, delegándole con autonomía la resolución y depuración de incidencias en infraestructuras críticas.
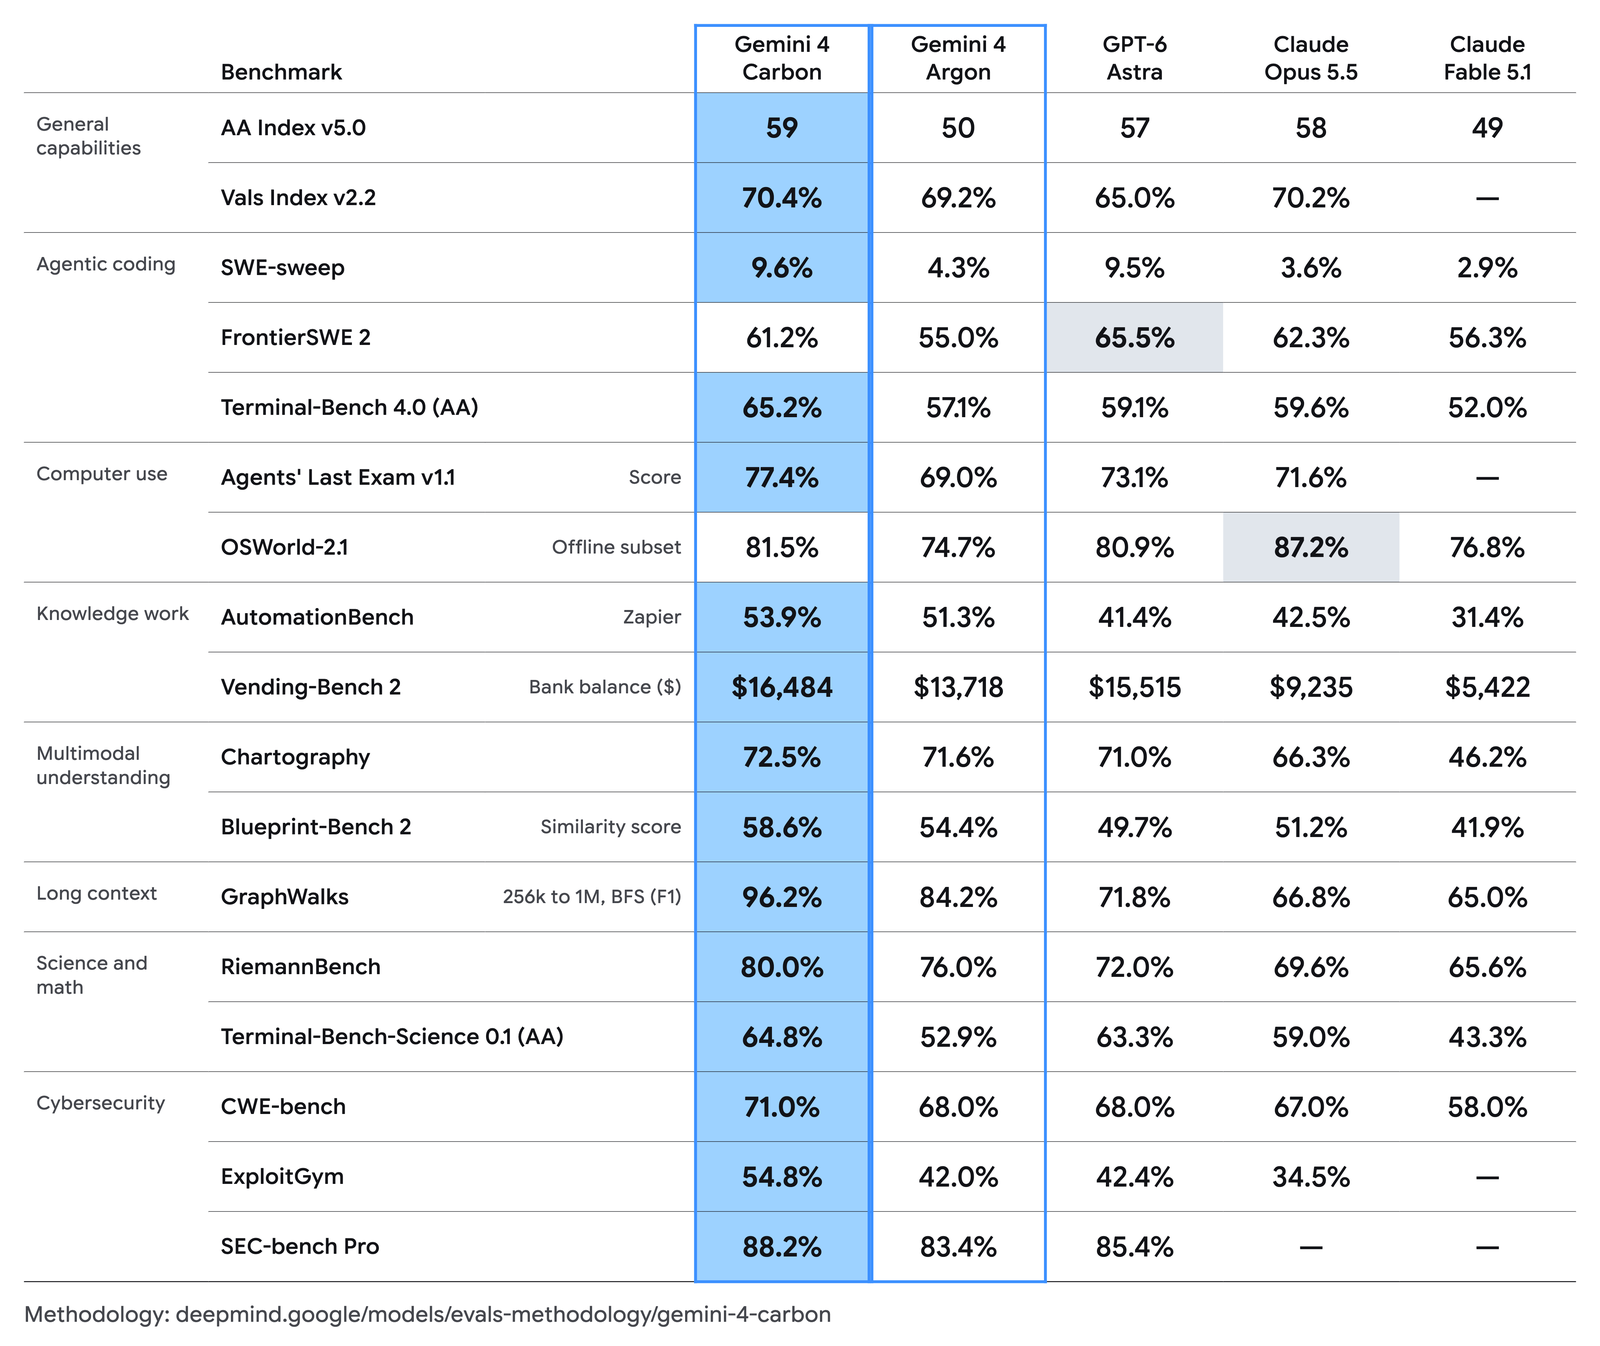 Figura: Datos oficiales de comparación cruzada para Carbon en tareas generales de razonamiento y desarrollo de código. Fuente: Google Blog (Apéndice de Evaluación del Modelo).
Las alertas por desalineación crítica caen un 80 %, mientras las revisiones oficiales frenan el despliegue
Con el fin de evitar que las conductas autónomas de alto riesgo escapen al control, DeepMind reforzó de manera rigurosa sus defensas adversarias. Las alertas internas por desalineación (misalignment) de alta severidad disminuyeron casi un 80 % en comparación con Argon, y las afirmaciones infundadas (alucinaciones) se redujeron a la mitad. Minimizar estos fallos críticos evita que los agentes autónomos desestabilicen servicios de producción durante flujos de depuración prolongados.
Al gestionar los límites de las instrucciones, la extralimitación indebida de Carbon se redujo un 26 %, mientras que la denegación innecesaria de respuestas disminuyó un 29 %. En las evaluaciones de inyección indirecta de instrucciones (indirect prompt injection) realizadas por la entidad de seguridad Gray Swan, la tasa de éxito de los ataques descendió del 0,7 % al 0,0 %. Llevar a cero este vector impide que textos externos maliciosos incrustados en páginas web secuestren los permisos de ejecución del agente.
Pese a este salto cualitativo en seguridad intrínseca, Carbon no se distribuirá de inmediato en el mercado masivo. Google optó por adherirse a los protocolos de revisión previa y voluntaria de seguridad del gobierno de los Estados Unidos, sometiendo a Carbon a exhaustivos ejercicios de red-teaming externo antes de cualquier anuncio comercial. El ritmo de evolución de los modelos punteros ya no depende únicamente de la arquitectura algorítmica, sino de los ciclos obligatorios de auditoría y certificación externa.
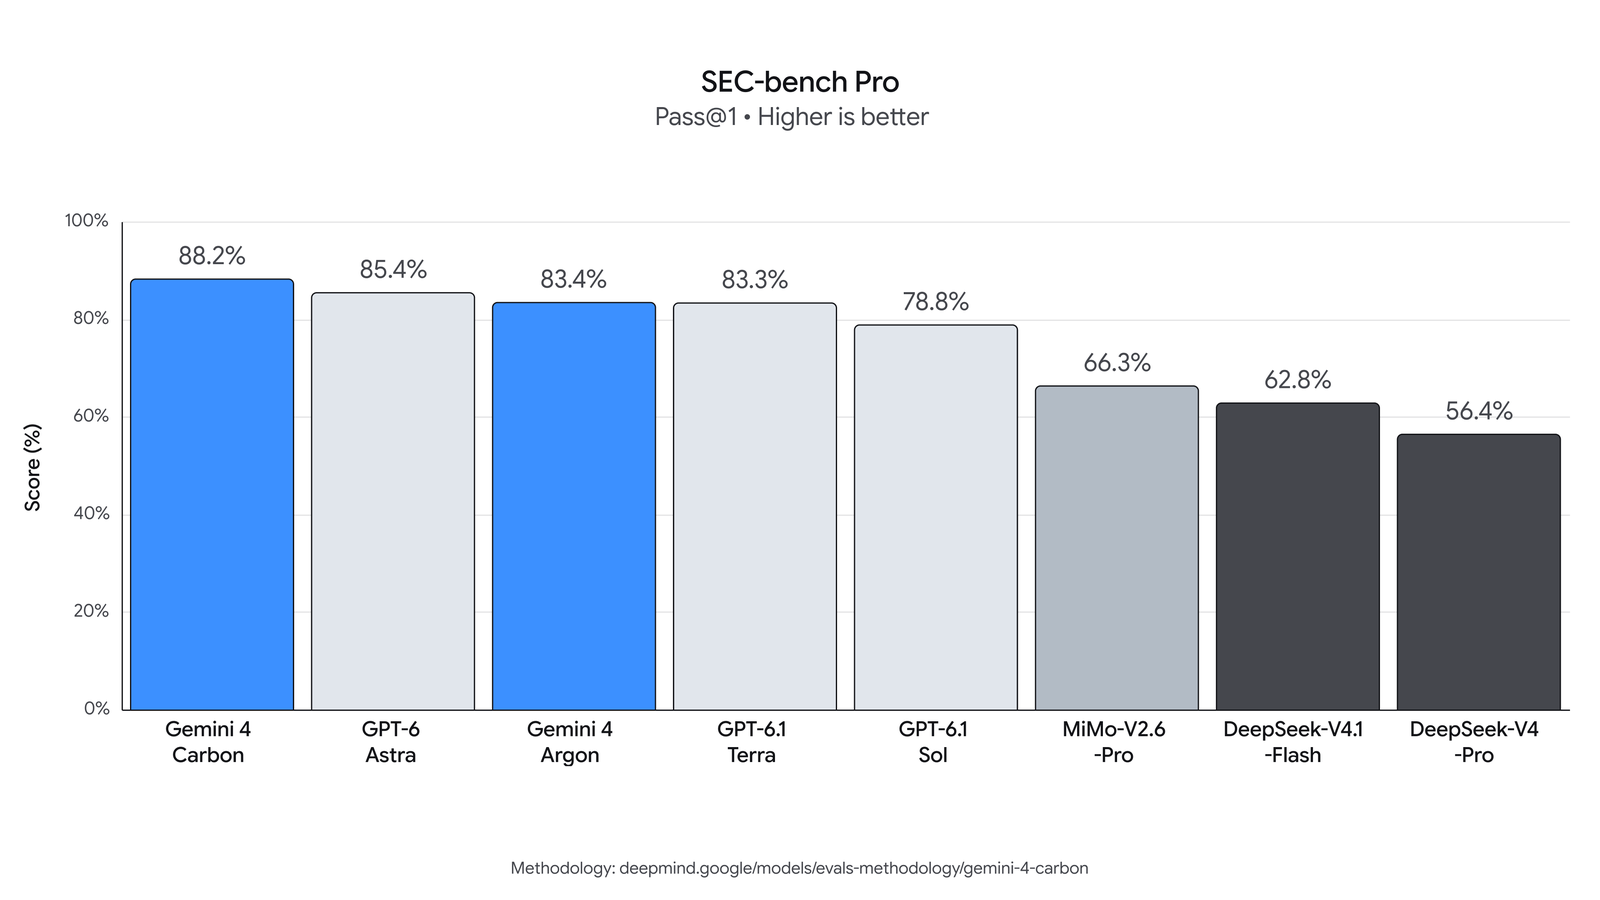 Figura: Gráfico comparativo del rendimiento de Carbon en benchmarks reales de ciberseguridad. Fuente: Google Blog (Informe Técnico de Seguridad).
Un precio de dos dólares tentador, pero estéril sin credenciales de acceso
En la lista oficial de tarifas, el coste de invocación de Carbon parece extraordinariamente accesible. El precio promocional de lanzamiento se fijó en 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida. Al activar el almacenamiento en caché de contexto, los desarrolladores acceden a un 95 % de descuento, dejando la entrada en caché a solo 0,10 dólares por millón de tokens. Tras el periodo promocional, las tarifas se situarán en 4 y 20 dólares por millón de tokens respectivamente. No obstante, para la inmensa mayoría, estos costes son simples cifras sobre el papel.
La ventajosa estructura tarifaria exige un requisito insalvable: los solicitantes deben superar los rigurosos filtros del programa Fairwind de Google. Por ahora, este programa solo abre cupos de manera escalonada a organizaciones de defensa cibernética previamente auditadas. Los desarrolladores individuales, las empresas de software comercial independiente y los creadores de aplicaciones quedan completamente fuera del alcance. Quienes deseen optar a una clave deben acreditar su filiación institucional y justificar sus casos de uso concretos ante un comité de revisión manual.
Este estricto régimen de distribución ha desatado una encendida controversia en las comunidades técnicas. Quienes defienden la medida sostienen que, ante un modelo capaz de generar exploits con un 54,8 % de acierto, dar prioridad absoluta a los equipos defensivos es la postura más prudente para blindar la infraestructura global frente a ataques automatizados. Por el contrario, las voces críticas argumentan que un modelo inalcanzable tiene un valor práctico nulo para la comunidad técnica. Al monopolizar Google los criterios de admisión, los equipos pequeños y medianos quedan rezagados ante una brecha de acceso impuesta verticalmente.
El fin de la IA como producto masivo: la gobernanza de distribución asume el protagonismo
Gemini 4 Carbon cristaliza un cambio profundo en los ejes de competencia de los grandes modelos de lenguaje. En las etapas anteriores, el manual habitual consistía en ampliar parámetros, batir récords y abrir de inmediato el consumo de la API a nivel global. Hoy, cuando la IA domina la fontanería de los sistemas y dispone de capacidades ofensivas y defensivas directas, ese esquema de difusión indiscriminada debe echar el freno. La escalada de capacidades trae consigo una eficiencia extraordinaria, pero también traslada las barreras de contención regulatoria al umbral mismo de la entrega.
Los modelos fundacionales de vanguardia están abandonando su condición de producto de consumo masivo para consolidarse como capacidades estratégicas de acceso restringido. Ocupar el número uno en las listas públicas seguirá atrayendo titulares, pero los resortes que deciden la influencia real en la industria han cambiado. Quien disponga de los avales regulatorios y de las plataformas de verificación de confianza será quien lidere el ecosistema. Desarrollar la inteligencia más avanzada ya es solo la primera mitad del reto; decidir a quién se le confieren los privilegios de uso se ha convertido en la verdadera contienda decisiva.
Enlaces de referencia:
- Comunicado Oficial de Google DeepMind: Introducing Gemini 4 Carbon
- Análisis en Profundidad de Ars Technica: Google Gemini 4 Carbon and the Frontier AI You Cannot Use
- Clasificación General Artificial Analysis Intelligence Index v5.0