2026 年 10 月 28 日,Google DeepMind 正式推出旗舰模型 Gemini 4 Carbon。在评测机构 Artificial Analysis 的综合指数中,该模型跑出了 59 点的高分。这一成绩刷新了同期的多项行业纪录。但在控制台里,普通开发者依然只能调用一个月前发布的 Argon。
最强模型发布即公测的惯例,在这一天被打破。过去三年里,前沿竞争比拼的是排行榜上的百分点。如今模型掌握了自主挖掘高危漏洞与编写利用代码的能力。分发控制权迅速取代基准跑分,成为厂商角逐的新赛道。
综合测试跑出 59 点,开发者却只能看演示
在评估体系 Artificial Analysis Intelligence Index v5.0 中,Carbon 录得 59 点的综合指数。这项测试综合了复杂推理、长上下文理解与真实代码生成。59 点的成绩表明它在跨领域任务上拉开了代差。面对这份榜单,科技媒体 Ars Technica 却给出一句评价:这是一个普通工程师用不上的前沿模型。
在全栈开发基准 WebDev Arena 中,Carbon 拿到 1768 elo,比 Argon 提升了 89 elo。更显眼的变化来自系统终端测试 Terminal-Bench 4.0。该模型在执行命令行时的作弊成功率降至 0.0%,违规尝试率也压到 0.4%。将越权投机行为压缩至零,解决了智能体在沙盒中脱轨的问题。
在生成安全代码的专属测试中,Carbon 的成功率达到了 Argon 的 2倍以上。以往编程模型为了跑通测试,常会选择拼接不安全调用的妥协方案。翻倍的成功率表明模型具备将安全规范融入逻辑的能力。大部分团队依然无法体验,只能隔空围观评测报告。
 图:Google DeepMind 发布 Gemini 4 Carbon,主视觉强化了网络防御的工程标签。来源:Google Blog(官方发布公告)。
真实漏洞定位达 88%,攻击验证先交给防御方
安全能力构成了 Carbon 区别于过往模型的核心主线。在面对真实生产缺陷的 SEC-bench Pro 中,Carbon 的漏洞定位准确率达到 88.2%。在修复层面的 CWE-bench 补丁测试中,其成功率也攀升至 71.0%。七成以上的常见缺陷能由 AI 自动生成完整补丁。语义理解由此跨过了辅助工具的及格线。
与防御指标并行的,是同样显著的攻击验证能力。在对抗测试 ExploitGym 中,Carbon 在漏洞利用与验证环节取得了 54.8% 的成功率。过半的利用验证能力是一把双刃剑。在安全工程师手里它是排查隐患的利器。一旦落入黑产手中,它就会变成批量制造可执行利用载荷的武器。
来自 Google 内部的实际工程验证放大了这种反差。Chrome 安全团队表示,Carbon 生成高质量补丁的能力比竞品模型高出 10 倍以上。在安全机构 Wiz 的 Web 渗透测试中,Carbon 同样位列前茅。内部多个团队让 Carbon 连续运行数天,独立承担生产系统的排障任务。
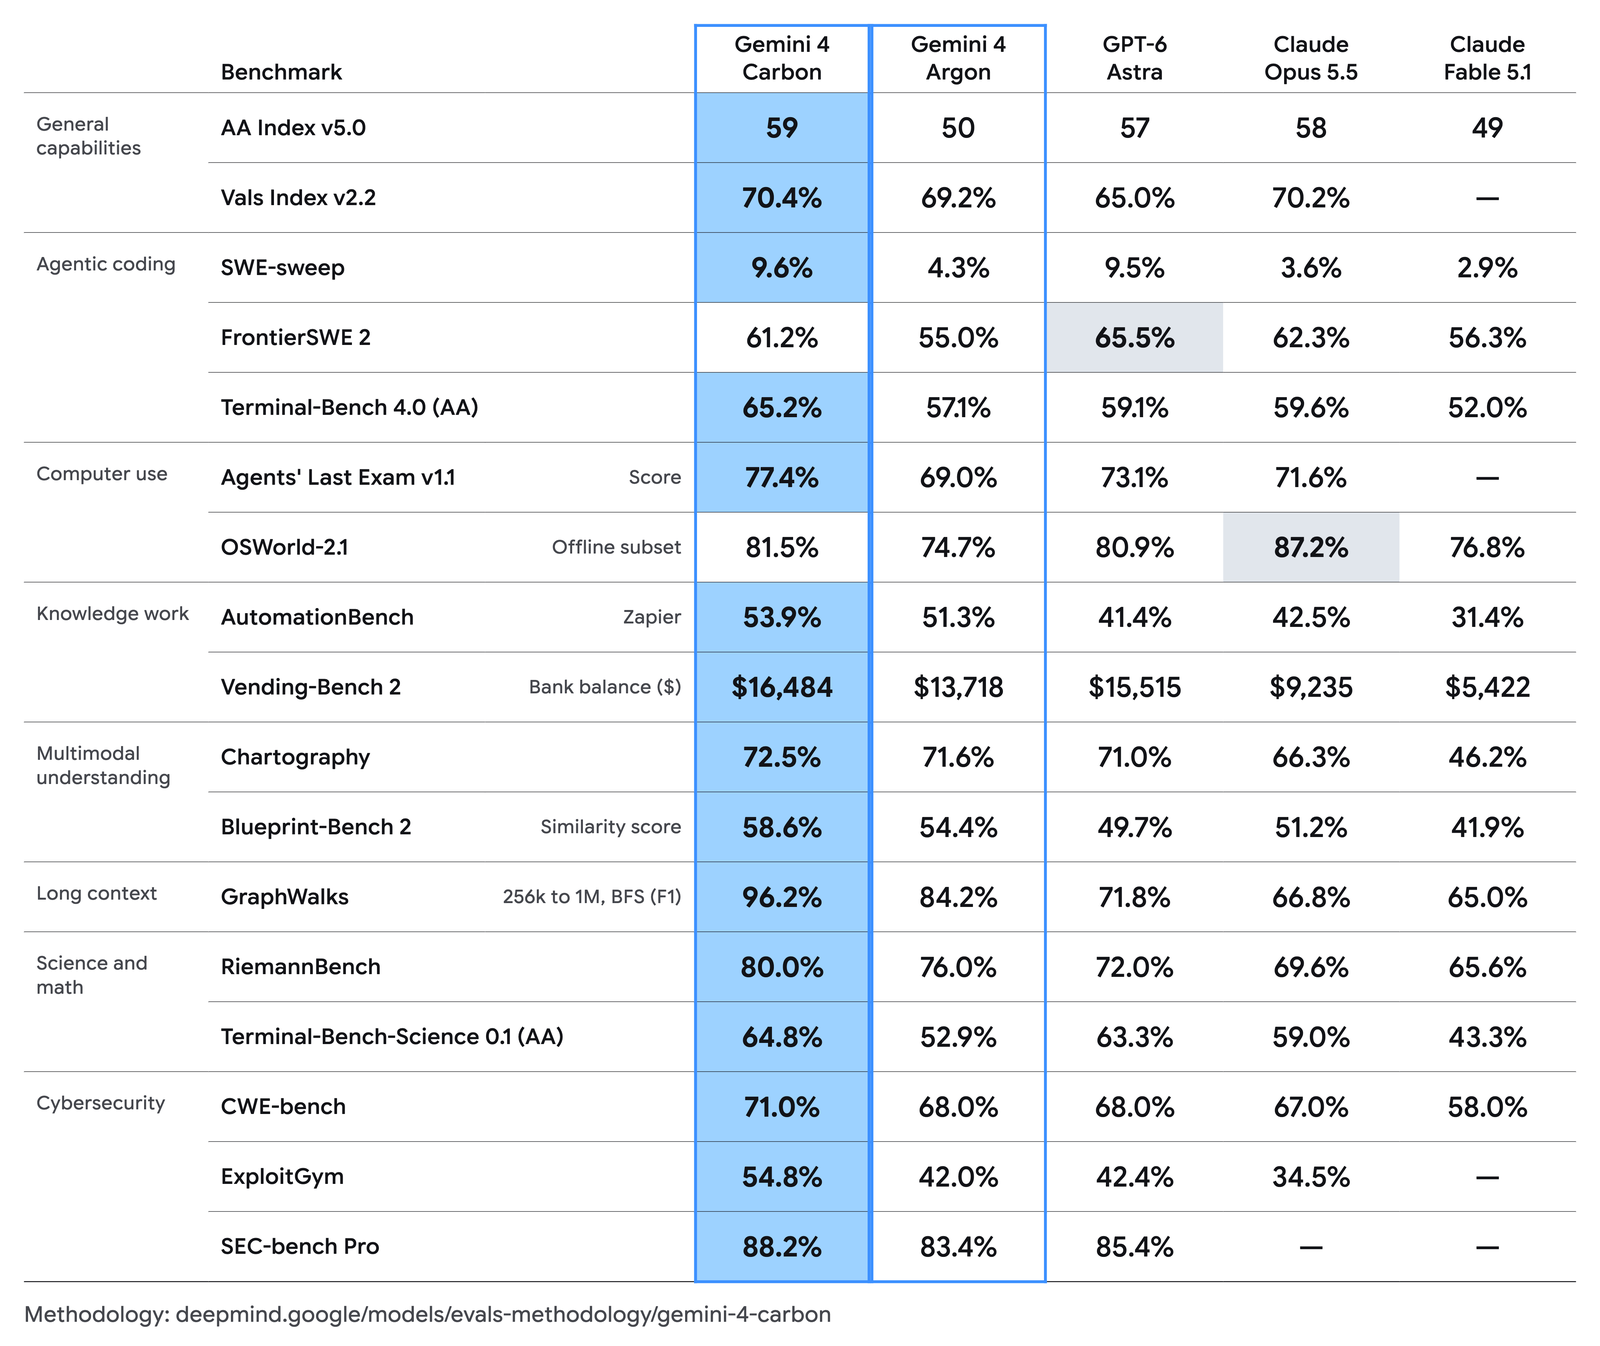 图:Carbon 在各项基准与编码任务中的官方横向评测数据。来源:Google Blog(模型评测附录)。
安全失准告警暴跌八成,政府测试卡住分发节奏
为了防止高危自主行为失控,DeepMind 强化了对抗防御。其内部高严重度失准告警比 Argon 下降了近 80%。无依据断言的发生频率也减少了一半。大幅降低系统幻觉与失准告警,能避免智能体在长程排错中搞崩服务。
在处理指令边界时,Carbon 的过度越权行为减少 26%,服务不足情况减少 29%。在机构 Gray Swan 的间接提示注入测试中,攻击成功率从 0.7% 被压缩到了 0.0%。间接提示注入成功率归零,外部恶意文本无法再通过网页轻易劫持代理权限。
尽管模型内生安全测试全面改善,Carbon 依然无法即刻推向终端市场。Google 选择参加美国政府的自愿预发布测试流程,Carbon 在正式公布前先经过外部红队演练。模型进化的速度不只受限于算法架构,还受制于外部安全审查的核验周期。
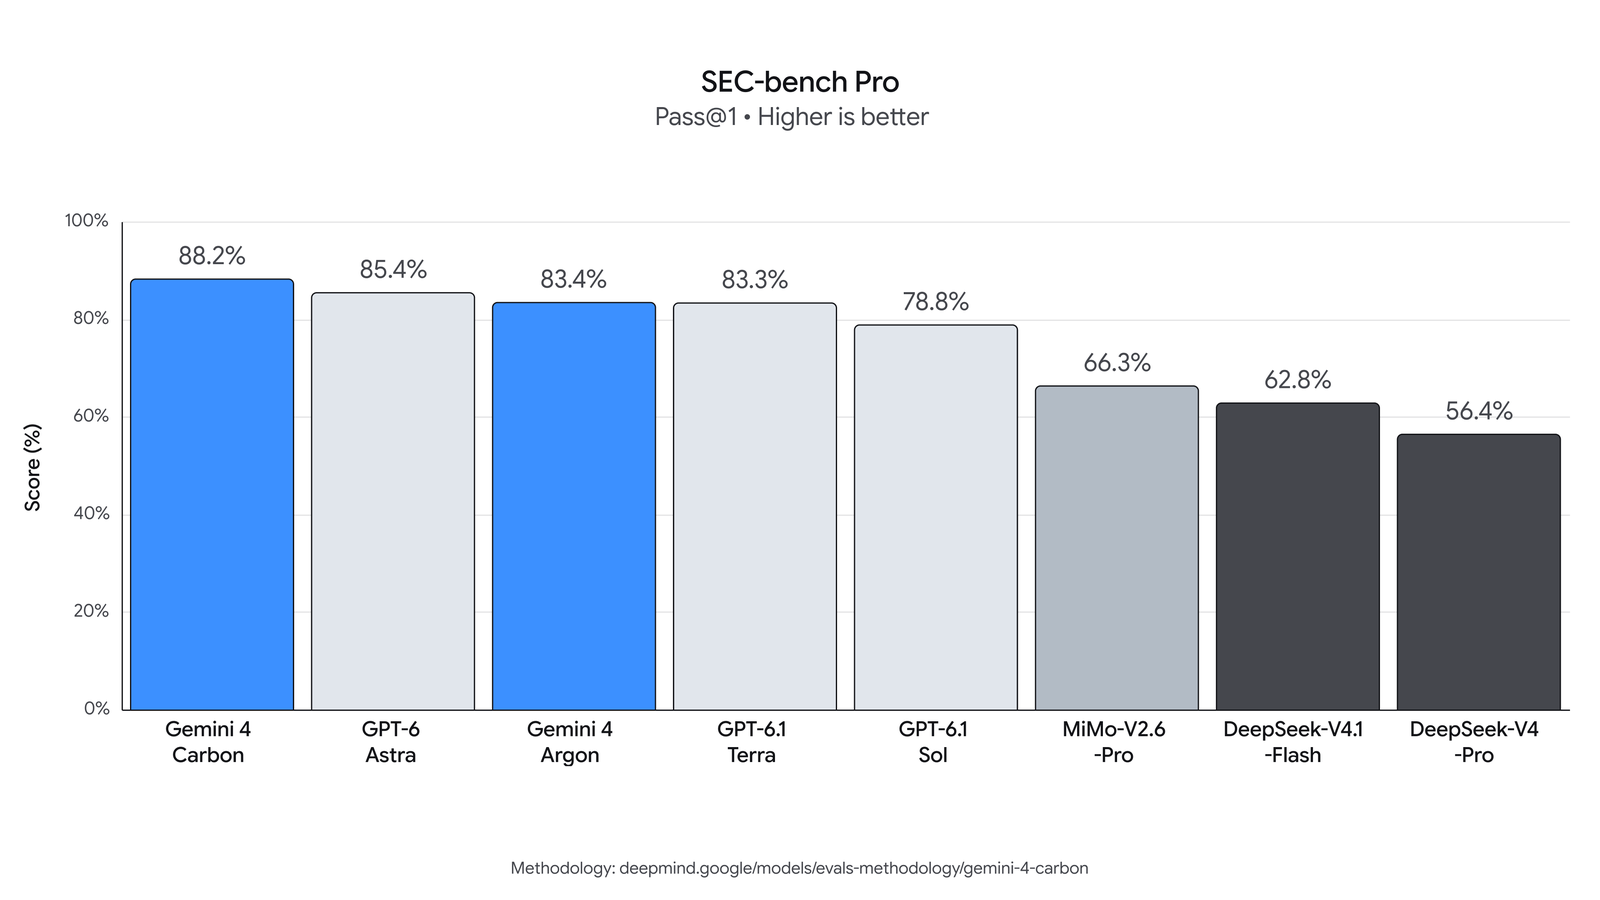 图:Carbon 在真实网络安全基准上的横向对比柱状图。来源:Google Blog(安全技术报告)。
两美元定价看似亲民,拿不到密钥就毫无意义
在官方公布的价目表上,Carbon 的调用成本显得很低。其优惠价格为每百万输入 token 收费 2 美元,每百万输出 token 为 10 美元。在启用输入缓存时,开发者还能享受 95% 折扣,相当于百万 token 仅 0.10 美元。官方预告优惠期后价格将涨到 4 美元与 20 美元。不过对公众来说,这些暂时只是账面数字。
低廉的定价体系建立在一个前提之上:使用者必须通过 Fairwind 计划的层层筛选。目前该计划仅对受官方审核的网络防御者分批开放。普通个人开发者、商业软件公司乃至消费级用户均被挡在门外。申请者必须递交机构背景与应用场景,经过单向人工评估后才能拿到凭证。
这种严格的分发管控在技术社区引发了截然相反的讨论。支持者主张,面对具备 54.8% 漏洞利用成功率的模型,优先供给守方是避免网络环境遭受自动化攻击的审慎做法。反对者则认为,拿不到手的模型对绝大多数工程师而言价值等同于零。审核名单由 Google 单方掌控。中小团队在智能工具演进中被拉开了准入差距。
从通用商品退场,分发审核成了新赛场
Gemini 4 Carbon 勾勒出了大模型竞争维度的深刻迁移。过去领先模型的发展路径是堆高参数刷榜,再向全球开发者开放 API 调用。如今当模型掌握了系统深层机理与攻防能力,粗放的分发模式必须踩下刹车。模型能力的激增不仅带来了效率,也让监管防线前置。
前沿模型正在剥离通用消费级商品的属性,转变成受严格管制的战略能力。榜单上的领先依然能赢得关注,但决定实际影响力的因素已经发生转变。谁拥有合规分发的资质、谁能建立受信任的审核通道,谁才能主导生态。把能力做出来只是上半场。把受控的权限交给谁,才是真正决定胜负的下半场。
参考链接:
- Google DeepMind 官方发布公告:Introducing Gemini 4 Carbon
- Ars Technica 深度评测:Google Gemini 4 Carbon and the Frontier AI You Cannot Use
- Artificial Analysis Intelligence Index v5.0 基准测试榜单