Le 28 octobre 2026, Google DeepMind a officiellement levé le voile sur son nouveau modèle phare : Gemini 4 Carbon. Dans l’indice synthétique d’Artificial Analysis, le modèle a signé un score impressionnant de 59 points, pulvérisant plusieurs records de l’industrie sur la période. Pourtant, dans la console développeur de Google, les ingénieurs logiciels ordinaires ne peuvent toujours appeler qu’Argon, déployé un mois plus tôt.
L’usage établi depuis trois ans — selon lequel le modèle le plus avancé est immédiatement mis à disposition des développeurs en préversion publique — a volé en éclats ce jour-là. Jusqu’ici, la course à la frontière de l’IA se jouait à quelques fractions de pourcent sur des classements publics. Mais à l’heure où les modèles acquièrent la capacité d’identifier de manière autonome des failles logicielles critiques et d’écrire des charges utiles d’exploitation fonctionnelles, le contrôle de la distribution a supplanté la course aux benchmarks pour devenir le véritable terrain d’affrontement stratégique.
59 points au banc d’essai global, mais les développeurs réduits au rôle de spectateurs
Sur la suite d’évaluation Artificial Analysis Intelligence Index v5.0, Carbon a enregistré un score consolidé de 59 points. Ce test synthétise le raisonnement complexe, l’appréhension de très longs contextes et la génération de code en conditions réelles de production. Un tel score de 59 points creuse un écart générationnel manifeste sur les tâches transversales d’ingénierie. Face à cette grille de résultats, le média technologique Ars Technica a résumé la situation sans détour : il s’agit d’un modèle de pointe que les ingénieurs ordinaires ne peuvent tout simplement pas utiliser.
Sur le banc d’essai de développement full-stack WebDev Arena, Carbon a atteint un classement Elo de 1768, marquant une progression de 89 points par rapport à Argon. Une rupture plus spectaculaire encore s’est manifestée sur l’environnement d’exécution en console Terminal-Bench 4.0 : le taux de contournement ou de triche du modèle lors de l’exécution de commandes système est tombé à 0,0 %, tandis que son taux de tentatives non autorisées a été contenu à 0,4 %. En éliminant les comportements spéculatifs et les dépassements de privilèges, le modèle résout le problème chronique de déraillement des agents autonomes au sein des bacs à sable d’exécution.
Dans les tests dédiés à la génération de code sécurisé, le taux de succès de Carbon a fait plus que doubler par rapport à Argon. Auparavant, pour valider des tests unitaires fonctionnels, les modèles de programmation recouraient fréquemment à des appels d’API vulnérables ou à des compromis hasardeux. Ce taux doublé prouve que le modèle sait intégrer les contraintes de sécurité directement dans la trame logique du code. Pour autant, l’immense majorité des équipes d’ingénierie reste privée d’accès concret, contrainte de contempler les rapports d’évaluation à distance.
 Figure : Google DeepMind annonce Gemini 4 Carbon avec une identité visuelle affirmant son positionnement d’ingénierie axé sur la cyberdéfense. Source : Google Blog (Annonce officielle).
88 % des vulnérabilités réelles localisées : la validation d’attaques réservée aux défenseurs
Les compétences en cybersécurité constituent la ligne de démarcation essentielle entre Carbon et les générations antérieures. Confronté à des défaillances réelles issues d’infrastructures de production dans SEC-bench Pro, Carbon a atteint une précision de localisation de 88,2 %. Sur le plan de la remédiation dans le banc de patchs CWE-bench, son taux de succès s’est élevé à 71,0 %. Plus de 70 % des faiblesses logicielles courantes peuvent ainsi être corrigées de manière autonome avec des patchs complets et fonctionnels rédigés par l’IA. La compréhension sémantique du code s’affranchit désormais de la simple assistance passive.
Parallèlement à ces indicateurs défensifs, le modèle déploie une capacité de validation offensive tout aussi redoutable. Dans la suite de tests contradictoires ExploitGym, Carbon a validé un taux de réussite de 54,8 % lors de l’exploitation et de la vérification de failles. Disposer d’une capacité de génération d’exploits opérationnels supérieure à une chance sur deux représente une arme à double tranchant : entre les mains d’ingénieurs en sécurité, c’est un outil d’audit inestimable ; si elle tombait aux mains d’organisations cybercriminelles, elle deviendrait une usine automatisée capable de générer en masse des charges offensives armées.
Les retours d’ingénierie interne chez Google corroborent cette dichotomie. L’équipe de sécurité de Chrome a rapporté que l’aptitude de Carbon à produire des correctifs de haute volée était plus de dix fois supérieure à celle des modèles commerciaux concurrents. Lors d’épreuves d’intrusion web menées par la société de sécurité cloud Wiz, Carbon s’est également hissé au sommet. Plusieurs équipes internes de Google laissent d’ailleurs Carbon tourner en continu sur plusieurs jours pour diagnostiquer et résoudre de manière autonome des incidents sur des services en production.
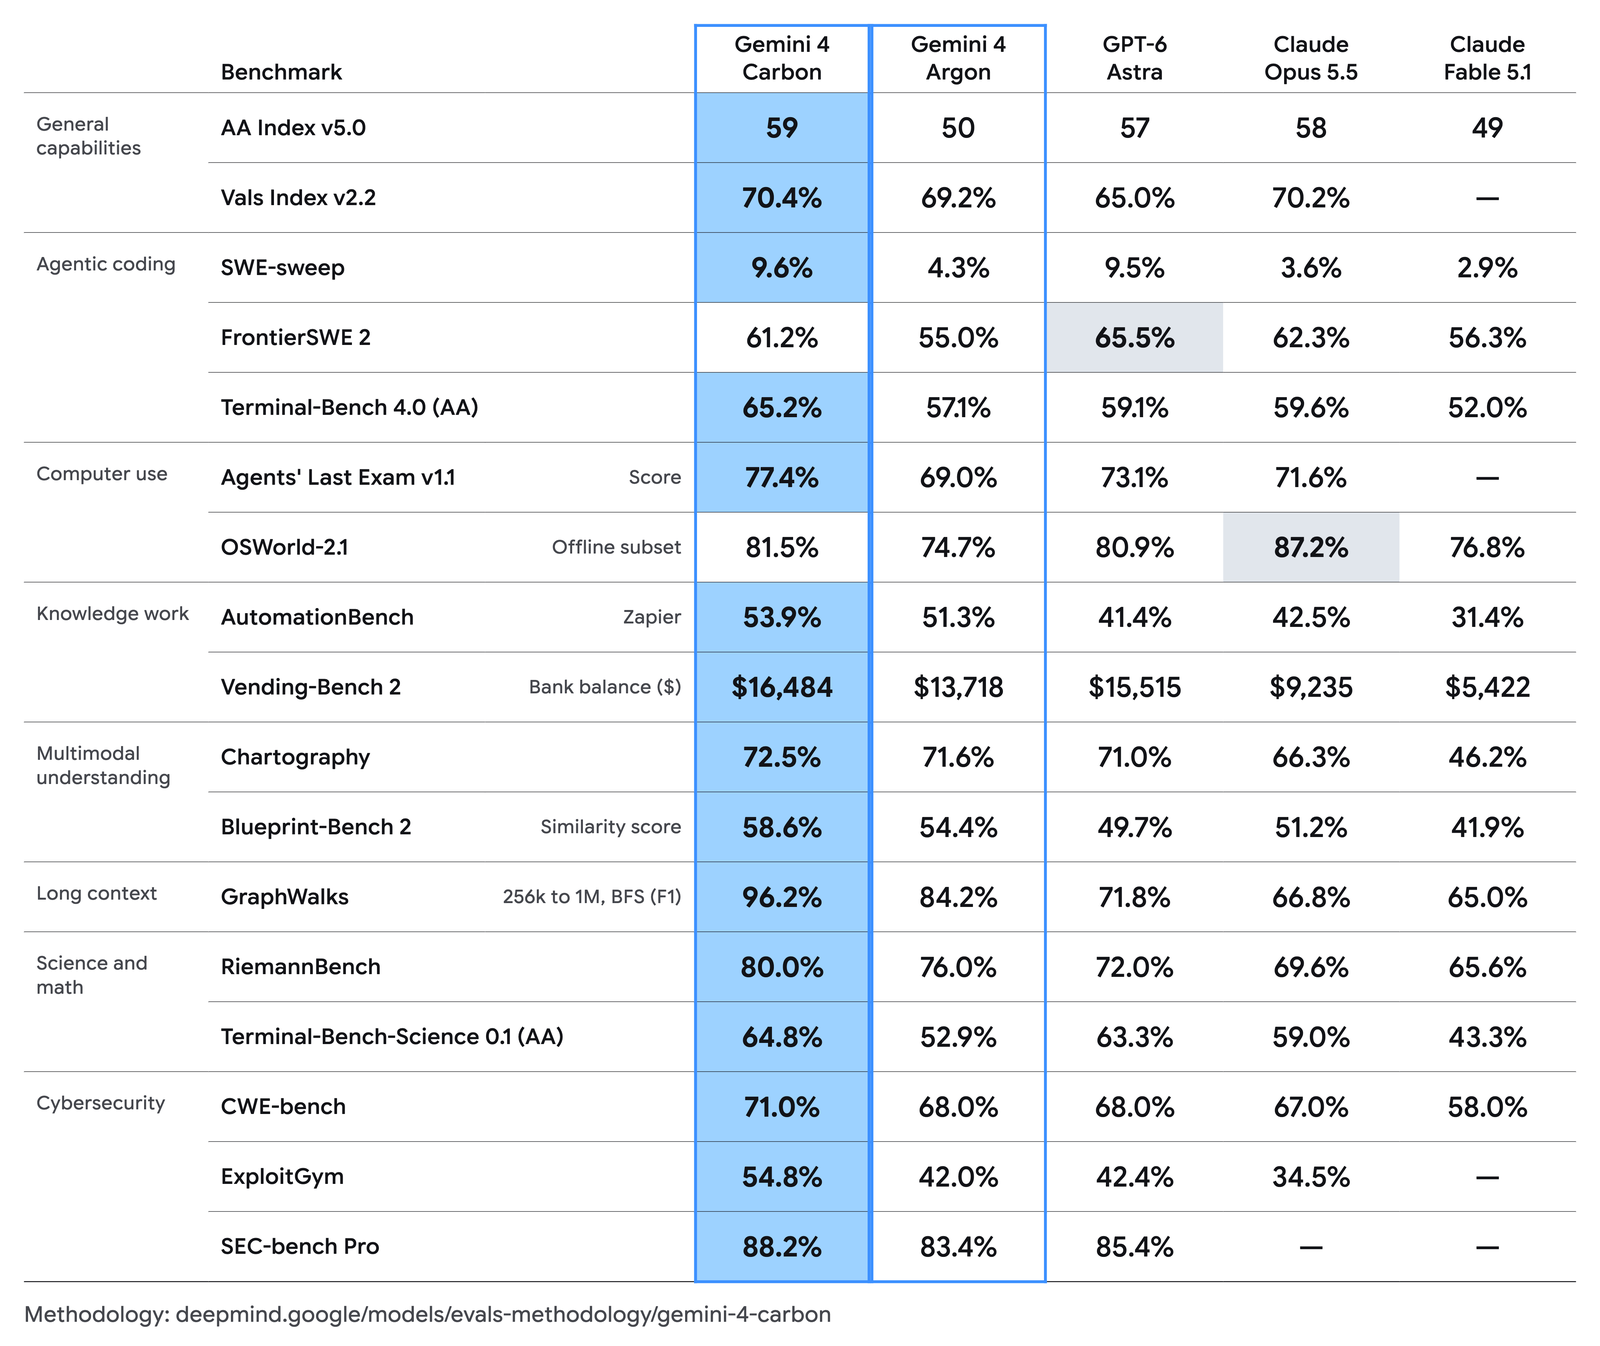 Figure : Données d’évaluation officielles pour Carbon sur les tâches de raisonnement général et de développement logiciel. Source : Google Blog (Annexe technique d’évaluation).
Les alertes de désalignement critique chutent de 80 %, les examens officiels ralentissent le déploiement
Pour parer à tout emballement d’actions autonomes critiques, DeepMind a considérablement renforcé ses défenses adverses. Les alertes internes de désalignement (misalignment) de haute gravité ont chuté de près de 80 % par rapport à Argon, tandis que la fréquence des affirmations sans fondement (hallucinations) a été divisée par deux. En éliminant massivement les dérives et les alertes d’incohérence, le modèle évite qu’un agent autonome ne paralyse des services névralgiques lors de sessions prolongées de débogage.
Sur la gestion des limites d’instructions, les empiétements excessifs de prérogatives ont diminué de 26 %, et les refus de réponse injustifiés ont baissé de 29 %. Lors d’évaluations indépendantes menées par Gray Swan sur l’injection indirecte d’instructions (indirect prompt injection), le taux de succès d’attaque a été ramené de 0,7 % à 0,0 %. Cette invulnérabilité à l’injection indirecte empêche tout texte externe malveillant hébergé sur une page web de détourner les privilèges d’exécution d’un agent logiciel.
En dépit de ces progrès structurels sur la sécurité intrinsèque du modèle, Carbon ne sera pas livré immédiatement au grand public. Google a fait le choix de s’inscrire dans le protocole de vérification préalable volontaire encadré par le gouvernement américain, soumettant Carbon à des exercices approfondis de red-teaming externe avant toute exploitation commerciale. La cadence de mise à disposition des modèles de frontière n’est plus seulement régie par la vitesse de l’innovation algorithmique, mais tributaire des délais incompressibles d’audit et de certification de sécurité.
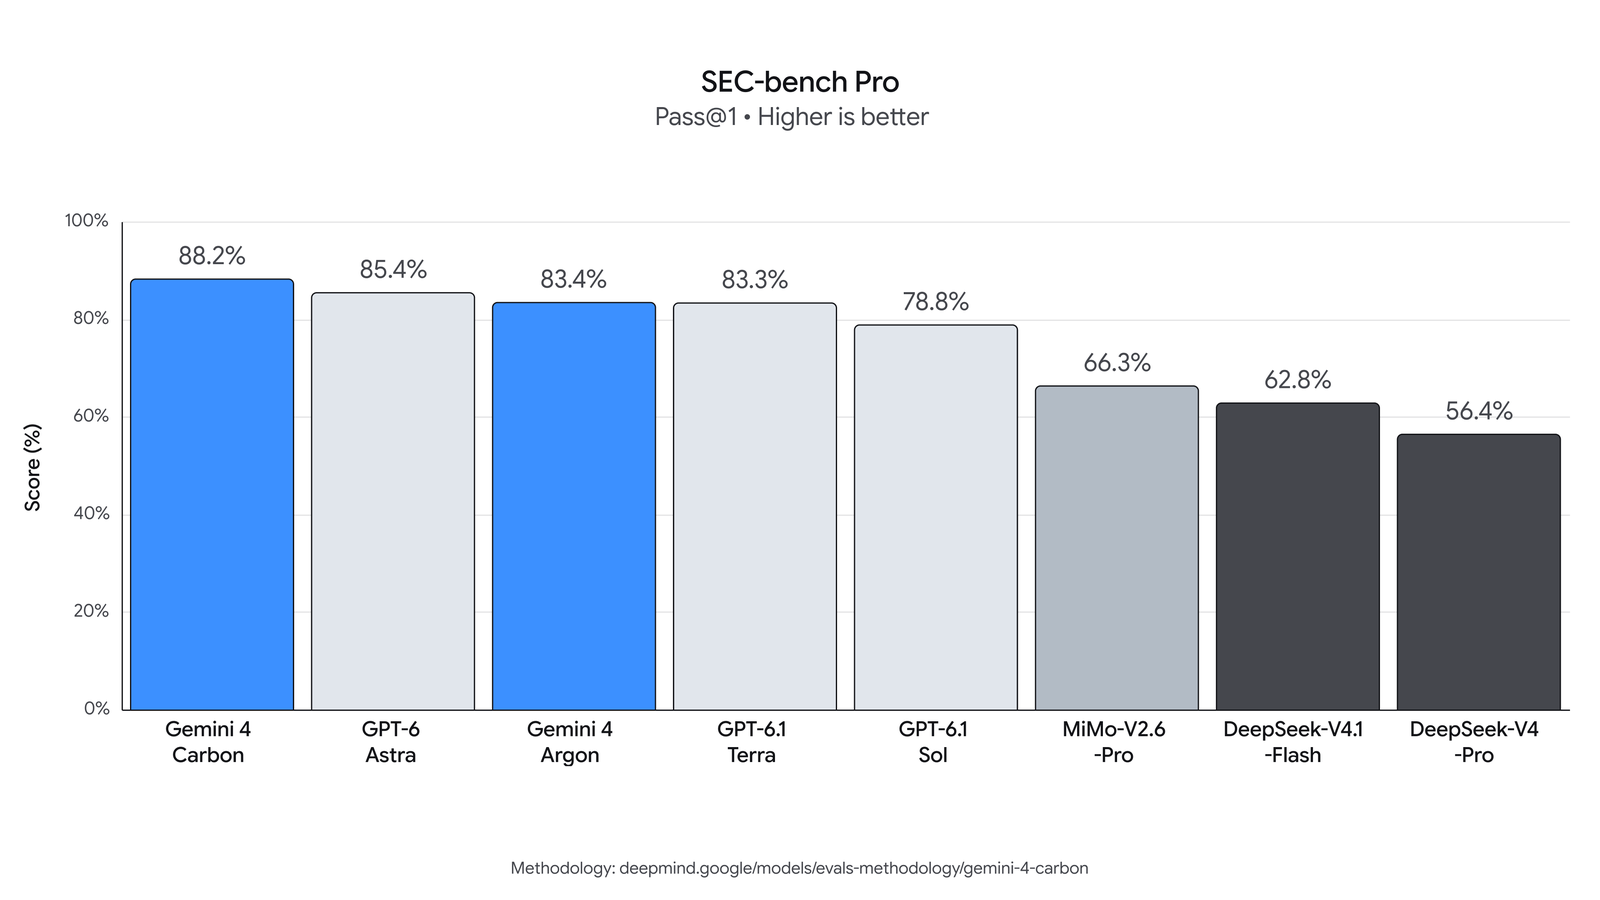 Figure : Histogramme comparatif des performances de Carbon sur des bancs de tests réels de cybersécurité. Source : Google Blog (Rapport technique de sécurité).
Deux dollars par million de tokens : un tarif attractif, mais sans clé d’accès, il reste lettre morte
Sur la grille tarifaire officielle, le coût d’accès à Carbon semble particulièrement séduisant. Le tarif promotionnel de lancement s’affiche à 2 dollars par million de tokens en entrée et 10 dollars par million de tokens en sortie. En activant la mise en cache de contexte, les développeurs profitent d’une remise de 95 %, abaissant le coût des entrées en cache à seulement 0,10 dollar par million de tokens. Si Google annonce un réajustement ultérieur à 4 et 20 dollars, ces montants ne représentent pour l’heure qu’une abstraction théorique pour le grand public.
Pour bénéficier de cette politique tarifaire très agressive, il faut impérativement franchir les barrières du programme Fairwind de Google. Or, ce programme n’ouvre ses portes qu’au compte-gouttes à des organisations de cyberdéfense rigoureusement homologuées. Développeurs indépendants, éditeurs de logiciels généralistes ou créateurs d’applications grand public en sont formellement exclus. Les postulants doivent justifier de leur statut institutionnel, déclarer leurs cas d’usage précis et se soumettre à une évaluation humaine unilatérale avant d’obtenir les précieuses clés d’accès.
Ce régime de distribution verrouillé a suscité des débats polarisés au sein de la communauté technologique. Ses partisans rappellent qu’avec un modèle capable d’aboutir à un exploit fonctionnel dans 54,8 % des cas, prioriser les équipes défensives constitue une mesure élémentaire de précaution pour préserver la stabilité du cyberespace contre les attaques automatisées. À l’inverse, ses détracteurs soulignent qu’un modèle inaccessible a une valeur concrète nulle pour l’immense majorité des ingénieurs. En monopolisant l’attribution des accès, Google risque d’infliger un déficit d’outillage artificiel aux petites et moyennes équipes à l’heure où les technologies cognitives s’accélèrent.
La fin du modèle banalisé : la gouvernance de distribution devient le vrai champ de bataille
Gemini 4 Carbon matérialise une inflexion profonde dans les règles de concurrence de l’intelligence artificielle. Lors des cycles précédents, la formule éprouvée consistait à empiler des paramètres pour dominer les classements, puis à ouvrir immédiatement l’API au monde entier. À présent que les modèles maîtrisent la plomberie des systèmes et disposent d’un arsenal d’attaque et de défense abouti, cette distribution tous azimuts doit impérativement marquer le pas. L’envolée des performances engendre un levier opérationnel sans précédent, mais impose d’avancer les lignes de confinement réglementaire jusqu’aux portes du déploiement.
Les modèles pionniers abandonnent leur statut de commodité grand public pour devenir des infrastructures stratégiques soumises à un contrôle rigoureux. La première place des classements mondiaux continuera de flatter les annonces de presse, mais la réalité de l’influence a changé de camp. Les maîtres du secteur seront ceux détenant les accréditations réglementaires et la maîtrise des canaux de distribution sécurisés. Concevoir le modèle le plus intelligent n’était que la première mi-temps ; arbitrer qui a le droit d’en manier la puissance constitue désormais la seconde mi-temps décisive.
Liens de référence :
- Annonce officielle de Google DeepMind : Introducing Gemini 4 Carbon
- Enquête approfondie d’Ars Technica : Google Gemini 4 Carbon and the Frontier AI You Cannot Use
- Classement général Artificial Analysis Intelligence Index v5.0