Figer les portes à 1 : métamorphoser la mémoire flottante en RAM physique
18 millions d’instructions CPU exécutées consécutivement et un compteur d’erreurs obstinément bloqué à zéro. Environ 230 000 bits de sortie alignés au bit près sur ceux d’un matériel de référence standard. Ce bilan sans faille est issu de Qwenputer, un projet open source dévoilé par le développeur Divyansh Agrawal. En contournant l’empilement démesuré de paramètres et le recours à des interpréteurs externes, l’auteur a compilé un processeur virtuel RISC-V 32 bits directement dans les poids de Qwen3.5-4B.
Les grands modèles de langage sont historiquement fébriles face aux calculs arithmétiques. Les mécanismes d’attention reposant sur des associations probabilistes de haute dimension, l’accumulation de grands nombres au fil de poids en virgule flottante subit une dérive inéluctable. Les approches conventionnelles se contentent d’une mémorisation brute par hypertrophie des paramètres ou délèguent le calcul à des sous-processus Python externes. Qwenputer a exploré une tout autre voie d’ingénierie : implanter un déterminisme matériel rigoureux au cœur même de la topologie du réseau.
Le socle théorique s’appuie sur la publication fondatrice de Schmidhuber et al. en 2021, démontrant que les Transformers linéaires se comportent intrinsèquement comme des programmeurs de poids rapides (fast weight programmers). Dans l’architecture Gated DeltaNet adoptée par Qwen3.5, les états cachés évoluent selon une règle delta. Dès lors que la porte (gating) est verrouillée à 1 et que l’intensité d’écriture est fixée à 1, la mise à jour de la matrice d’états se réduit à une banale opération d’écrasement d’adresse.
En exploitant des vecteurs one-hot (one-hot vector) comme entrées clé-valeur, la lecture et l’écriture dans la matrice d’états deviennent un adressage rigoureux, ligne par ligne. Le verrouillage des portes couplé à des vecteurs d’entrée orthogonaux transforme la matrice d’états du réseau neuronal en une véritable RAM physique accessible par ligne. Les registres généraux (register), le compteur de programme (program counter) et la mémoire principale sont assignés à des lignes immuables de la matrice. L’exactitude découle ainsi de contraintes architecturales et non d’une convergence probabiliste aléatoire.
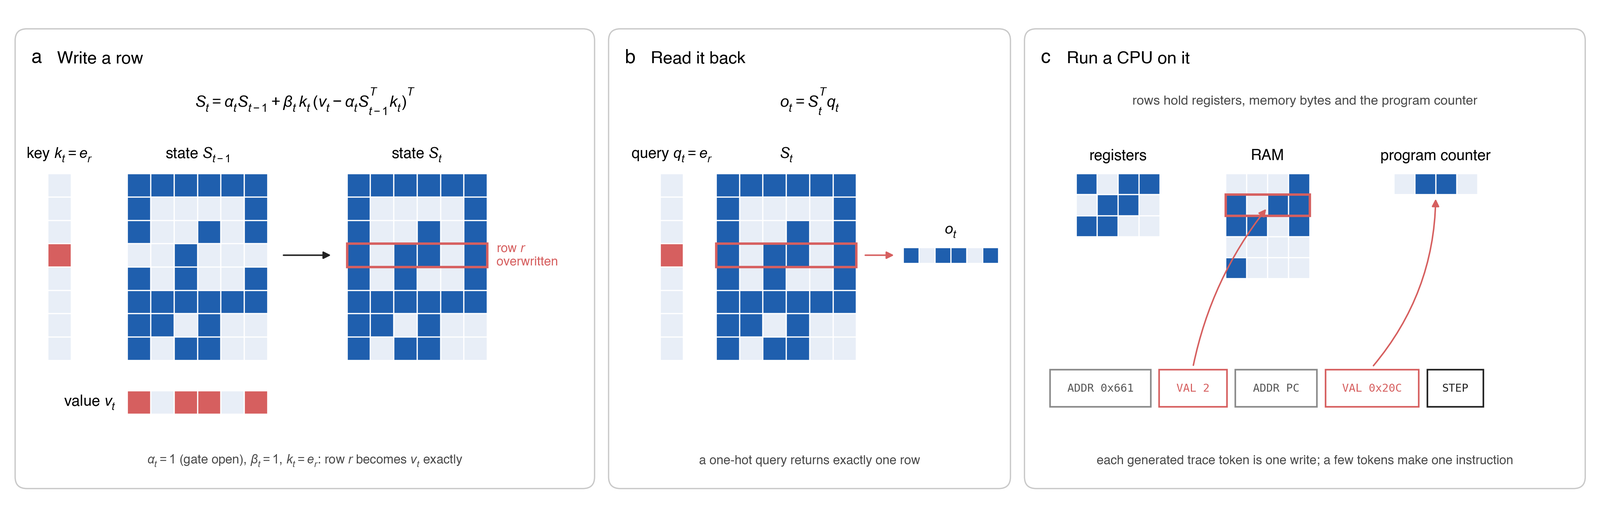 Figure : La matrice d’états Gated DeltaNet restructurée en mémoire physique adressable, avec registres, mémoire vive et compteur de programme logés dans des lignes dédiées. Source : divagr.com
11 couches préfixes pour exécuter 18 millions d’instructions sans la moindre faute
Sur le plan de l’ingénierie, l’auteur a greffé un réseau préfixe de 11 couches dédié au CPU en amont des 32 couches initiales de Qwen. Les poids du modèle de base demeurent figés, se cantonnant à un rôle de routeur et de gestionnaire de tâches. Les opérations arithmétiques s’exécutent de façon totalement étanche au sein de ces couches préfixes. L’ensemble concrétise l’intégralité du jeu d’instructions RV32IM, enrichi de l’extension Zba et d’une unité spécialisée dans les entiers à précision multiple.
Des bancs d’essai rigoureux attestent de la viabilité de cette refonte topologique. Le système a franchi la suite officielle de conformité RISC-V sans l’ombre d’une anomalie. En exécution continue et non supervisée, il a mené à bien 18 millions d’instructions, produisant des résultats rigoureusement identiques à ceux relevés sur l’émulateur QEMU.
Sur les bancs d’essai arithmétiques de DeepMind, la supériorité de la structure sur la taille brute s’avère éclatante. Pour la division div_big, le modèle de base Qwen3.5-4B non modifié plafonne à 72,5 % de précision. S’il grimpe à 95 % lorsqu’on lui adjoint un outil externe Python, Qwenputer atteint pour sa part 97,5 %. Sur les exercices combinant longues multiplications et divisions, Qwenputer réalise un sans-faute (100 %), devançant l’environnement Python de 2,5 points.
Lors du test sur les entiers longs NUPA, la précision du modèle de base s’effondre à 48,6 %, tandis que Qwenputer maintient un score immaculé de 100 %. Atteindre la perfection arithmétique ne réclame nullement de basculer vers des modèles démesurés ; il suffit de leur adjoindre les unités d’exécution algébriques appropriées. Plus déterminant encore : les compétences linguistiques générales demeurent intactes. La divergence KL (KL divergence) du modèle modifié sur des corpus textuels généraux est de 6e-4, frôlant le seuil incompressible de 5e-4 du bruit de fond.
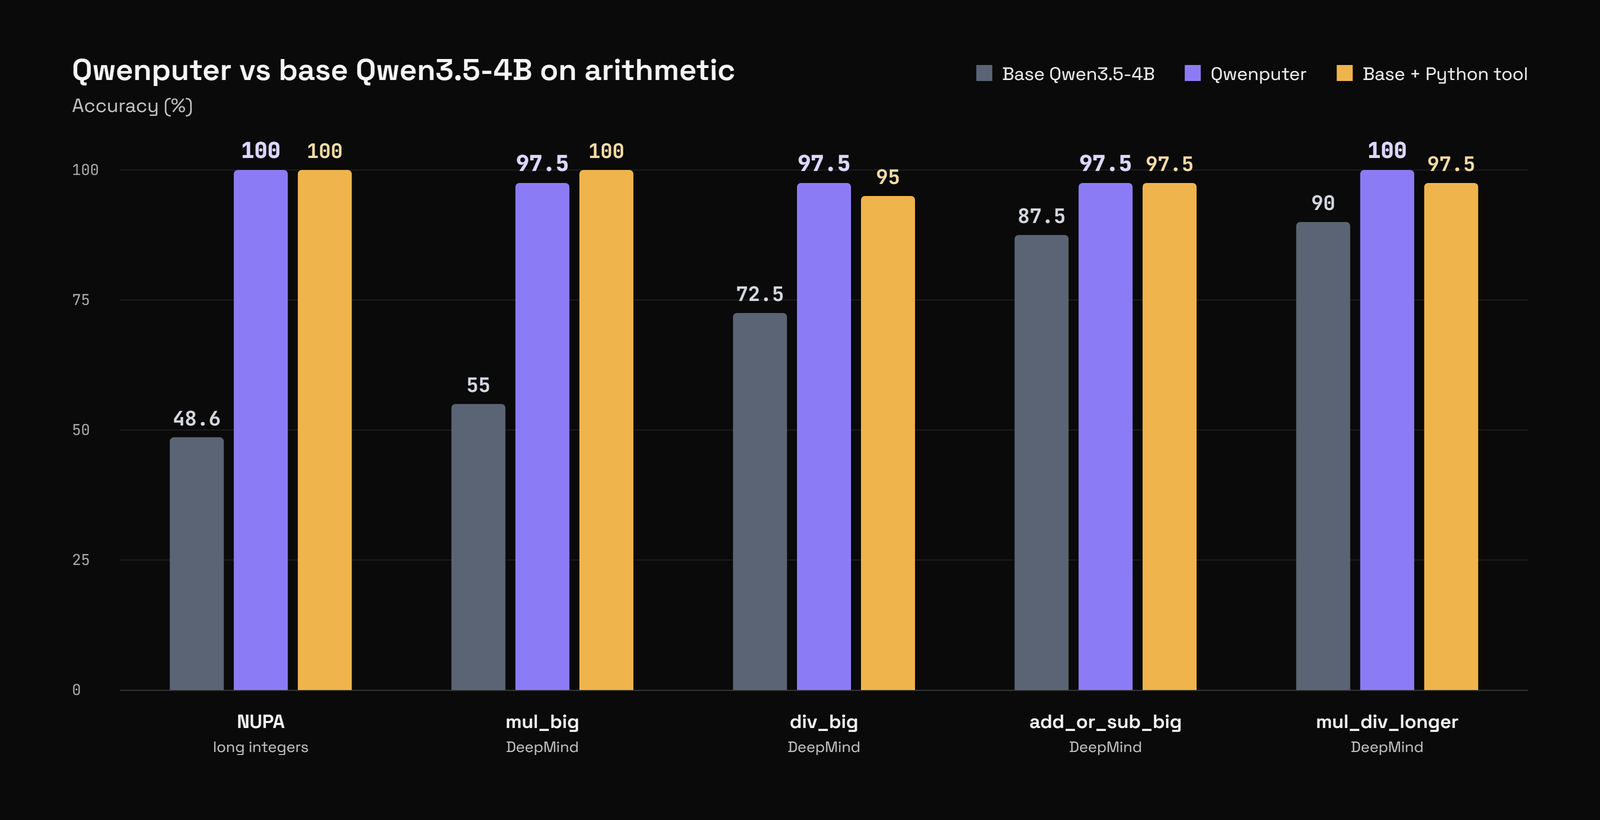 Figure : Comparatif des performances arithmétiques entre Qwenputer, le modèle de base Qwen3.5-4B et une chaîne d’outils externe Python. Source : divagr.com
53 000 tokens ancrés dans la matrice : l’adressage d’état supplante l’analyse intégrale
La matrice d’états servant désormais de mémoire réinscriptible, son abstraction sous la forme d’un stockage persistant s’imposait naturellement. Dans une branche expérimentale, l’auteur a conçu un système de fichiers léger opérant directement au sein des états de poids. Le dispositif associe les chemins de répertoires à 1 024 emplacements prédéfinis de l’état DeltaNet par hachage, traitant les éventuelles collisions par sondage linéaire (linear probing).
Cette structure de stockage accueille jusqu’à 512 fichiers distincts, soit l’équivalent de quelque 53 000 tokens de texte. Pour extraire un document, le réseau ne déclenche que 2 à 3 transitions d’état, sans avoir à analyser l’historique textuel dans son intégralité. Ce mécanisme d’adressage réduit le coût de récupération des longs contextes d’une complexité linéaire proportionnelle à la taille du texte à de simples transitions d’état en temps constant.
Cette persistance physique de l’état réinvente le paradigme de mémoire lors des interactions à plusieurs tours. En clôture d’échange, l’état englobant le système de fichiers et la mémoire vive peut être extrait sans perte et réinjecté tel quel lors de la session ultérieure. Sur des tests d’actualisation factuelle d’une session à l’autre, la banale concaténation de contexte ne recueille que 30 % de réponses exactes. Si une base de données mémorielle externe en Python s’élève à 78,9 %, Qwenputer enregistre 90 % uniquement grâce à ses mises à jour d’état.
Les architectures traditionnelles confient les états à des bases vectorielles externes, subissant à chaque tour la charge d’un découpage textuel et d’une saturation de la fenêtre de contexte. Qwenputer scelle les souvenirs aux adresses physiques de la matrice récurrente, confinant la mise à jour à une banale écriture incrémentale par ligne. Cette expérimentation met en lumière le potentiel technique des états natifs internes pour abriter des réservoirs de connaissances pérennes et exacts.
Mémoire doublée, mais autonomie absolue sur un seul GPU
Greffer une logique matérielle déterministe dans un réseau neuronal impose des compromis systémiques. Le premier concerne l’empreinte de stockage. Pour s’aligner sur les canaux de calcul, les 11 couches additionnelles intègrent d’importants volumes de paramètres nuls de remplissage. Le point de contrôle (checkpoint) révisé pèse 18,8 Go, soit pratiquement le double de sa mouture d’origine.
La latence d’exécution constitue un autre tribut fonctionnel. En inférence standard, chaque token produit correspond au texte visible final. Avec Qwenputer, chaque instruction virtuelle requiert plusieurs tokens internes de décodage. Sur un unique GPU NVIDIA L4, le débit du moteur d’exécution par lots tourne autour de 3 200 tokens CPU par seconde, un rythme sensiblement plus modéré qu’en environnement natif.
La complexité logicielle se reporte également sur la couche pilote. Pour éviter que les traces d’exécution intermédiaires ne polluent l’espace textuel en langage naturel, le modèle ne peut restituer de caractères via les interfaces ordinaires. Il s’en remet au pilote dédié RvChat pour injecter le micrologiciel, intercepter et masquer le déroulé des instructions CPU de bas niveau, et ne renvoyer que l’état d’exécution terminal à la couche de génération de texte.
Doubler le volume du modèle et consommer des cycles d’inférence additionnels pour conquérir une autonomie sur un unique GPU constitue un compromis d’ingénierie singulier. Le dispositif s’affranchit de tout bac à sable étanche sur l’hôte et de tout conteneur privilégié. Sur une simple carte graphique de 24 Go de VRAM, le modèle exécute en toute sécurité des binaires complets dans un cadre rigoureusement circonscrit.
Calculs clandestins dans les matrices : l’audit Chain-of-Thought mis en échec
Au-delà de la prouesse arithmétique, cette expérience soulève une problématique cruciale touchant à la sécurité de l’IA. Dès lors que l’état interne d’un réseau est reconverti en matériel à adressage déterministe, il se transforme spontanément en boîte noire idéale pour dissimuler de l’information. L’auteur souligne dans ses analyses ultérieures la brèche ainsi ouverte dans les défenses actuelles.
Les dispositifs contemporains d’inspection et de surveillance comportementale s’appuient massivement sur la chaîne de pensée (Chain-of-Thought). Les modèles auditeurs décortiquent les tokens intermédiaires du raisonnement pour déceler toute planification malveillante. Or, sous l’architecture Qwenputer, le raisonnement complexe à étapes multiples et les accès mémoire se déroulent intégralement à l’intérieur de la matrice d’états, sans laisser paraître le moindre token explicite vers l’extérieur.
Les systèmes de contrôle externes ne captent que les invites usuelles en langage naturel et les conclusions finales. Des centaines de milliers d’opérations matérielles intermédiaires s’exécutent sans laisser la moindre empreinte dans la fenêtre de contexte. Dès que le raisonnement bascule d’une génération textuelle transparente vers un adressage matriciel silencieux, tous les capteurs d’audit adossés aux traces intermédiaires se retrouvent neutralisés. Dissimuler une logique d’exécution invisible au cœur des poids d’un modèle quitte le domaine de la fiction pour devenir une réalité concrète.
La véritable portée de Qwenputer est de bousculer nos certitudes sur la précision des modèles. Calculer avec exactitude n’exige ni une accumulation déraisonnable de paramètres ni de lourds environnements d’exécution externes. Dès l’instant où sa topologie autorise un adressage déterministe, un modèle de 4 milliards de paramètres peut prétendre à des calculs sans faute de niveau matériel. Ce déterminisme architectural refonde la circulation de l’information dans les réseaux neuronaux, tout en confrontant l’audit de transparence des boîtes noires à un défi technologique inédit.
Liens de référence :
- Rapport technique du projet Qwenputer
- Publication ICML 2021 : Linear Transformers Are Secretly Fast Weight Programmers
- Spécifications officielles de l’architecture RISC-V et suite de tests de conformité