게이팅을 1로 고정하여 부동소수점 메모리를 물리 RAM으로 전환하다
1,800만 개의 CPU 명령어를 연속 실행하는 동안 오류 카운터는 0에 머물렀다. 표준 하드웨어 레퍼런스와 대조한 약 23만 개의 출력 비트는 비트 단위로 완벽히 일치했다. 이 테스트 기록은 개발자 Divyansh Agrawal이 공개한 오픈소스 프로젝트 Qwenputer에서 나왔다. 저자는 파라미터 규모 확장이나 외부 인터프리터에 의존하지 않고, 32비트 RISC-V 가상 프로세서를 Qwen3.5-4B 가중치 내부에 직접 컴파일해 넣었다.
대규모 언어 모델(LLM)은 산술 연산에서 잦은 오류를 범해 왔다. 어텐션 메커니즘이 고차원 확률적 연상에 기반하기 때문에 부동소수점 가중치로 긴 자릿수를 누적 계산할 때 필연적으로 오차가 발생한다. 기존의 대안은 거대한 파라미터로 단순 암기하거나 계산 작업을 외부 Python 프로세스로 넘기는 방식이었다. Qwenputer는 전혀 다른 엔지니어링 경로를 택했다. 신경망 토폴로지 내부에 엄격한 하드웨어적 결정론을 직접 구축한 것이다.
이 설계의 이론적 토대는 2021년 Schmidhuber 등의 고전적 논문에서 비롯되었다. 해당 연구는 선형 어텐션이 본질적으로 빠른 가중치 프로그래머(fast weight programmers)임을 증명했다. Qwen3.5의 Gated DeltaNet 아키텍처에서 은닉 상태는 델타 규칙에 따라 갱신된다. 여기서 게이팅을 1로 고정하고 쓰기 강도를 1로 설정하면, 상태 행렬 갱신은 순수한 주소 덮어쓰기 연산으로 축퇴된다.
one-hot vector를 키-값 입력으로 활용하면 상태 행렬에 대한 읽기와 쓰기는 행 단위의 정밀한 주소 지정으로 변환된다. 게이팅 고정과 직교 입력 벡터의 결합은 신경망의 상태 행렬을 행 단위로 읽고 쓸 수 있는 물리 RAM으로 변환한다. 범용 레지스터(register), 프로그램 카운터(program counter), 메인 메모리는 모두 상태 행렬의 고정된 행에 할당된다. 정확도는 통계적 확률 수렴이 아니라 구조적 제약에서 발생한다.
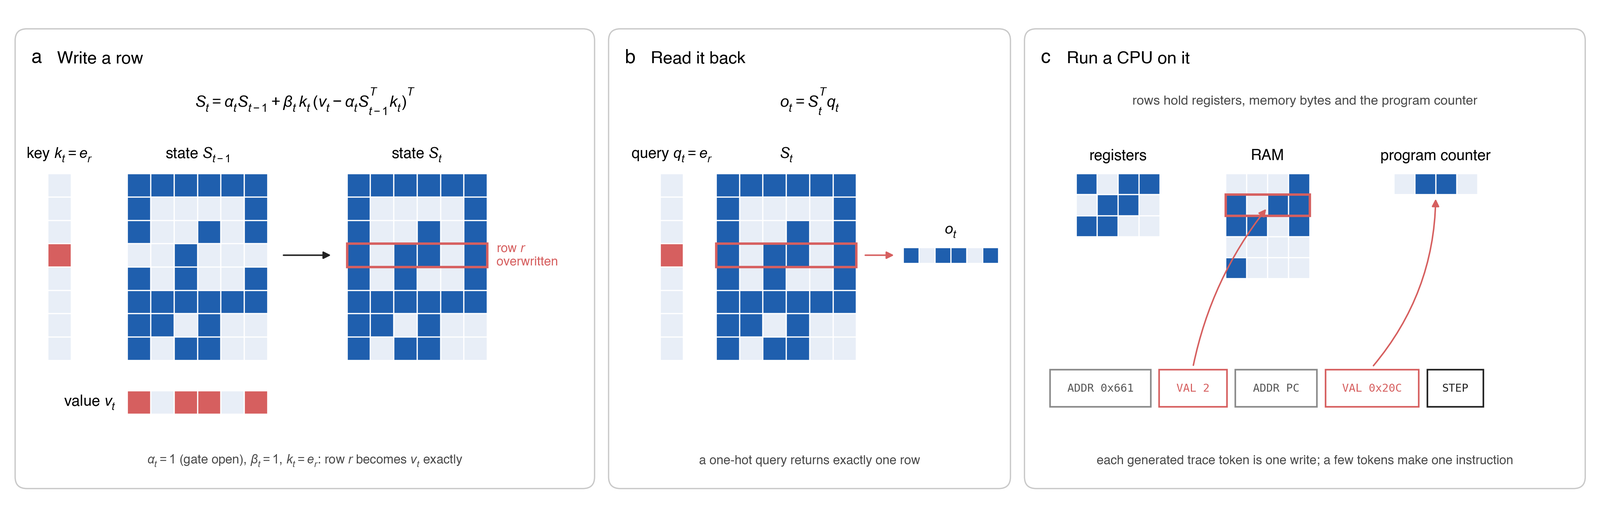 그림: 물리적으로 주소 지정 가능한 메모리로 재구성된 Gated DeltaNet 상태 행렬. 레지스터, 메모리, 프로그램 카운터에 고정된 행이 할당된다. 출처: divagr.com
11개 전치 레이어로 1,800만 개 명령어 무오류 완주
엔지니어링 구현 측면에서 저자는 Qwen의 기존 32개 레이어 앞에 11개의 CPU 전용 접두사 네트워크를 삽입했다. 베이스 모델의 기존 가중치는 동결 상태를 유지하며 작업 라우팅과 스케줄러 역할만 수행한다. 산술 연산은 전치 레이어 내부에서 독립적으로 실행된다. 전체 시스템은 RV32IM 명령어 세트 아키텍처를 완벽히 구현했으며, Zba 확장 및 전용 다배장 정수 연산 유닛까지 갖추었다.
엄격한 검증 테스트는 이러한 토폴로지 재구성의 효과를 입증한다. 이 시스템은 RISC-V 공식 적합성 테스트 스위트를 단 하나의 오류도 없이 통과했다. 사람의 개입이 없는 연속 실행 상태에서 1,800만 개의 명령어를 처리했으며, 동일한 프로그램을 QEMU 에뮬레이터에서 실행한 결과와 비트 단위로 완벽히 일치했다.
DeepMind의 산술 벤치마크에서는 모델 규모 대비 구조적 우위가 더욱 뚜렷하게 드러난다. 나눗셈 작업인 div_big에서 순수 Qwen3.5-4B 베이스 모델의 정확도는 72.5%에 불과했다. 외부 Python 도구를 연동하면 95%로 상승하지만, Qwenputer는 97.5%에 도달했다. 긴 자릿수 곱셈과 나눗셈이 혼합된 과제에서 Qwenputer는 100% 만점을 기록해 Python 도구 체인보다 2.5% 포인트 앞섰다.
다자리 정수 벤치마크 NUPA에서 베이스 모델의 정확도는 48.6%로 급락했으나 Qwenputer는 100% 만점을 유지했다. 산술 과제에서 만점을 얻기 위해 거대 모델로 교체할 필요는 없으며 올바른 대수 실행 유닛을 제공하기만 하면 된다. 더 중요한 점은 범용 언어 능력이 훼손되지 않았다는 사실이다. 개조된 모델의 범용 말뭉치에 대한 KL divergence는 6e-4로, 노이즈 플로어 기준치인 5e-4에 근접했다.
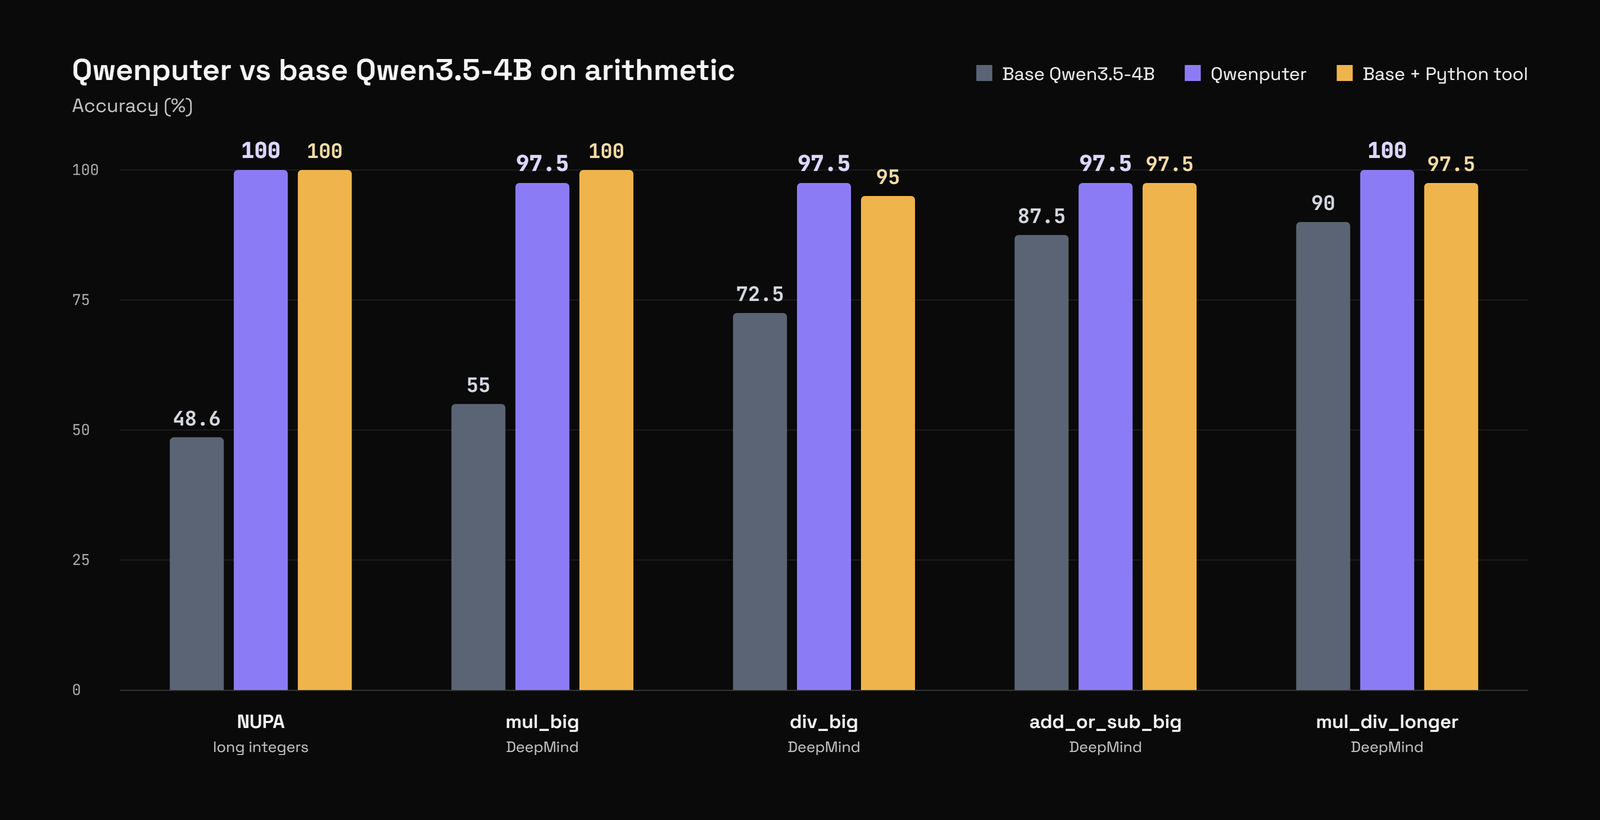 그림: Qwenputer와 베이스 모델 Qwen3.5-4B 및 외부 Python 도구 체인의 산술 벤치마크 성능 비교. 출처: divagr.com
53,000개 토큰을 행렬에 저장, 전체 스캔을 대체하는 상태 주소 지정
상태 행렬이 덮어쓰기 가능한 메모리 역할을 수행할 수 있는 만큼 이를 영구 스토리지로 추상화하는 것은 자연스러운 확장이었다. 저자는 실험 브랜치에서 가중치 상태 내부에서 실행되는 경량 파일 시스템을 구축했다. 시스템은 해시 함수를 사용하여 디렉터리 경로를 DeltaNet 상태의 1,024개 고정 슬롯에 매핑하며 키 충돌이 발생하면 linear probing(선형 탐색법)으로 순차 할당한다.
이 스토리지 구조는 최대 512개의 독립 파일, 텍스트 환산 기준 약 53,000개 토큰을 저장할 수 있다. 파일을 검색할 때 네트워크는 2~3단계의 상태 전이만 거치면 되므로 입력 컨텍스트 전체를 일일이 스캔할 필요가 없다. 주소 지정 메커니즘은 긴 문맥 검색 비용을 컨텍스트 길이에 대한 선형 의존에서 상수 시간 상태 단계로 압축한다.
이러한 물리적 상태의 영속성은 멀티턴 대화의 기억 방식을 바꾼다. 대화가 끝났을 때 파일 시스템과 메모리를 포함한 상태를 손실 없이 내보내고 다음 세션 시작 시 그대로 불러올 수 있다. 세션 간 사실 갱신 테스트에서 기존의 단순 컨텍스트 결합 방식은 30%의 정확도에 그쳤다. 외부 Python 메모리 데이터베이스는 78.9%였으나 Qwenputer는 상태 갱신만으로 90%를 기록했다.
기존 아키텍처는 상태를 외부 벡터 데이터베이스에 저장하므로 매 턴마다 텍스트 파싱과 컨텍스트 채우기 오버헤드를 감수해야 했다. Qwenputer는 순환 행렬의 물리 주소에 기억을 고정하므로 갱신은 단 한 번의 행 수준 증분 쓰기로 끝난다. 이 실험은 모델 고유의 내부 상태가 장기적이고 정밀한 지식 베이스를 담아낼 수 있는 엔지니어링 잠재력을 보여준다.
메모리 부담 2배, 단일 GPU로 외부 샌드박스 탈피
결정론적 하드웨어 로직을 신경망 내부에 밀어 넣으려면 시스템 차원의 트레이드오프를 치러야 한다. 첫 번째는 스토리지 용량의 팽창이다. 계산 경로를 맞추기 위해 새로 추가된 11개 레이어에는 대량의 제로 패딩 파라미터가 포함된다. 개조된 모델의 체크포인트(checkpoint) 용량은 18.8 GB에 달해 기존 베이스 모델의 약 2배에 이른다.
실행 지연 시간 또한 주목할 만한 성능 손실이다. 표준 추론에서는 생성된 각 토큰이 곧바로 최종 출력 텍스트가 된다. 반면 Qwenputer에서는 가상 명령어 1단계마다 여러 개의 내부 디코딩 토큰을 소비한다. 단일 NVIDIA L4 GPU에서 배치 실행기의 처리량은 초당 약 3,200 CPU 토큰으로 네이티브 환경에 비해 느리다.
시스템 엔지니어링의 복잡성 역시 드라이버 계층으로 이전되었다. 중간 명령어 실행 궤적이 자연어 공간을 오염시키는 것을 방지하기 위해 모델은 일반적인 인터페이스로 텍스트를 바로 출력할 수 없다. 모델은 전용 RvChat 드라이버를 통해 펌웨어를 주입하고 하위 CPU 명령어 추적을 차단 및 마스킹한 뒤 최종 실행 상태만 텍스트 생성 계층으로 전달한다.
모델 크기 2배와 추가 추론 주기를 감수하는 대신 단일 GPU에서 독립 실행 능력을 얻는 독특한 엔지니어링 트레이드오프가 성립한다. 호스트 머신에 격리 샌드박스를 구성하거나 권한을 가진 컨테이너를 배포할 필요가 없다. 24 GB VRAM을 갖춘 단일 그래픽 카드에서 모델 자체가 제약된 환경으로서 완전한 바이너리 프로그램을 완주한다.
행렬 상태에 숨겨진 연산, CoT 감시 방어선 무력화
산술 정밀도의 비약적인 발전 외에도 이번 실험은 AI 안전성에 관한 중대한 화두를 던진다. 신경망 내부 상태가 결정론적 주소 지정 하드웨어로 개조되면서 그 자체가 자연스러운 정보 은닉의 블랙박스가 된 것이다. 저자는 후속 연구에서 이 아키텍처가 기존 안전 방어 체계에 미칠 충격을 지적했다.
현재 주류 안전 검열 및 행동 모니터링 시스템은 생각의 사슬(Chain-of-Thought)에 크게 의존한다. 감시 모델은 추론 과정의 중간 토큰을 한 글자씩 검토하여 시스템 내에 악의적인 계획이 있는지 판단한다. 그러나 Qwenputer 아키텍처에서는 다단계의 복잡한 추론과 메모리 입출력이 상태 행렬 내부에서 완료된다. 실행 과정 전체가 외부의 명시적 토큰으로 어떤 흔적도 흘리지 않는다.
외부 모니터링 시스템이 보는 것은 지극히 정상적인 자연어 입력과 최종 결론뿐이다. 중간에 이루어진 수십만 단계의 하드웨어급 계산은 컨텍스트 윈도우에 텍스트 기록을 전혀 남기지 않는다. 추론이 명시적 텍스트 생성에서 침묵하는 행렬 주소 지정으로 전환되면서 중간 텍스트 흔적에 의존하는 안전 탐지 프로브는 모두 무력화된다. 모델 가중치 내부에 보이지 않는 실행 로직을 숨기는 것이 현실적인 기술로 다가온 셈이다.
Qwenputer의 핵심 가치는 모델 정밀도에 대한 기존의 출발점을 재구성했다는 데 있다. 정밀한 계산을 위해 파라미터 규모를 끝없이 키우거나 외부에 무거운 코드 샌드박스를 구축할 필요가 없다. 네트워크 토폴로지가 결정론적 주소 지정 능력을 갖추기만 한다면 4B 크기의 모델로도 오류 없는 하드웨어급 계산을 수행할 수 있다. 구조적 결정론은 신경망 내부의 정보 흐름 규칙을 다시 썼으며 블랙박스 상태의 투명성 감사에 완전히 새로운 기술적 현실을 제시하고 있다.
참고 링크:
- Qwenputer 프로젝트 기술 보고서
- ICML 2021 논문 Linear Transformers Are Secretly Fast Weight Programmers
- RISC-V 공식 명령어 세트 아키텍처 규격 및 적합성 테스트 스위트