把门控锁定为 1,浮点记忆变物理内存
连续运行 1800 万条 CPU 指令,错误计数停在零。约 23 万个输出位与标准参考硬件逐位比对,结果逐位一致。这组测试记录来自开发者 Divyansh Agrawal 发布的开源项目 Qwenputer。作者避开参数堆叠与外部解释器,将一台 32 位 RISC-V 虚拟处理器直接编译进了 Qwen3.5-4B 权重。
大语言模型做算术历来容易出错。由于注意力机制基于高维概率联想,浮点权重累加长数字时难免漂移。常见方案依赖大参数硬背,或把计算甩给外部 Python 进程。Qwenputer 选择了另一种工程路线:在网络拓扑内部构建严格的硬件确定性。
这个设计的理论支点来自 2021 年 Schmidhuber 等人的经典论文。该研究证明线性注意力本质上是快速权重程序员。在 Qwen3.5 的 Gated DeltaNet 架构中,隐藏状态按增量规则演进。门控固定为 1 且写入强度设为 1 时,状态矩阵更新退化为地址覆盖操作。
独热向量充当键值输入,模型对状态矩阵的读写就转变为逐行精准寻址。门控锁定配合正交输入向量,将神经网络状态矩阵转换为按行读写的实体 RAM。通用寄存器、程序计数器与主内存都被分配在固定矩阵行中。精度源于结构约束,脱离了对统计概率收敛的依赖。
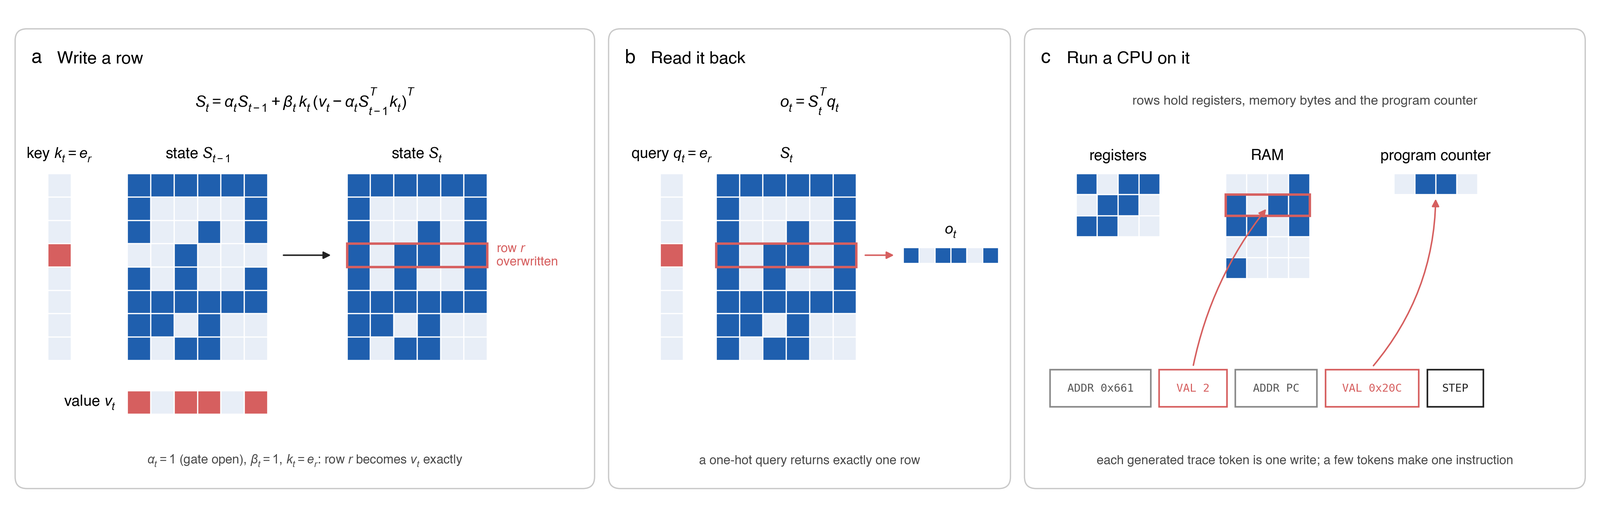 图:Gated DeltaNet 状态矩阵被重构为物理寻址内存,寄存器、内存和程序计数器均分配固定行。来源:divagr.com
11 层前置拓扑跑通 1800 万条指令零错误
在工程实现上,作者在 Qwen 原有的 32 层结构前插入了 11 层 CPU 专用网络。基座原有权重保持冻结,仅充当任务路由调度器。算术运算在前置层中独立执行。整套系统完整实现了 RV32IM 指令集架构,外加 Zba 扩展与专用多倍长整数单元。
严苛的验证测试佐证了这种拓扑重塑的有效性。该系统零差错通过了 RISC-V 官方合规套件。在无干预连续运行状态下,它跑完了 1800 万条指令。同一批程序在 QEMU 模拟器上跑出的结果与它一致。
在 DeepMind 算术基准测试中,结构替代规模的优势体现得更直观。对于除法任务 div_big,未改装的 Qwen3.5-4B 基座准确率为 72.5%。外挂 Python 工具提升至 95%,而 Qwenputer 达到了 97.5%。混合长乘除任务中,Qwenputer 取得 100% 满分,高出 Python 工具链 2.5 个百分点。
长整数测试 NUPA 上,基座模型准确率骤降至 48.6%,Qwenputer 则拿下了 100% 满分。算术任务实现满分并不需要换用大模型,只需要给它正确的代数执行单元。更关键的是通用语言能力并未受损。改动后模型在通用语料上的 KL 散度为 6e-4,几乎贴近 5e-4 的噪声底线。
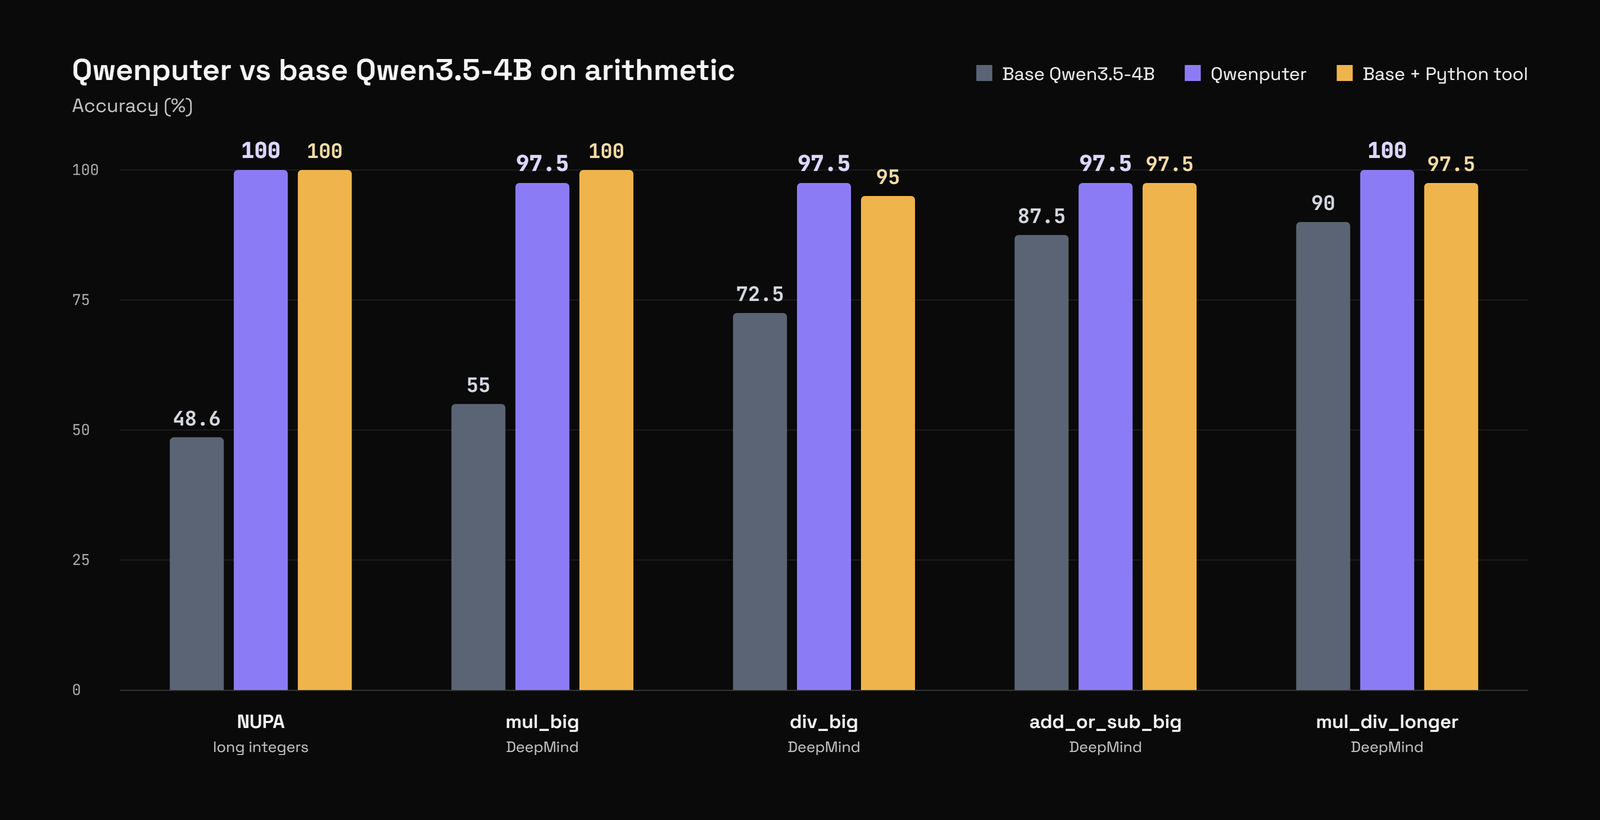 图:Qwenputer 与基座模型 Qwen3.5-4B 及外挂 Python 工具链在算术基准上的表现对比。来源:divagr.com
53000 Token 存入矩阵,状态寻址取代全表扫描
状态矩阵既然能充当覆写内存,向上抽象为持久化存储就成了顺理成章的延伸。作者在实验分支中构建了运行在权重状态里的轻量文件系统。系统利用哈希函数将目录路径映射到 DeltaNet 状态的 1024 个固定槽位中。遇到键值冲突时,系统采用线性探测法顺延分配。
这套存储结构最多容纳 512 个独立文件,约合 53,000 个 Token 的文本。检索文件时,网络只需执行 2 到 3 步状态转移。它不必在输入端对全部历史文本展开逐字全量扫描。寻址机制将长文本检索开销从上下文长度的线性依赖压缩为常数级状态步进。
这种物理化状态的持久性改变了多轮交互的记忆模式。对话结束时,包含文件系统与内存的状态可以无损导出并在下次启动直接载入。跨对话事实更新测试中,常规拼接上下文方案仅有 30% 正确率。外挂 Python 记忆数据库准确率为 78.9%,而 Qwenputer 依靠状态更新达到了 90%。
传统架构把状态保存在外部向量库中,每轮调用都要承担文本解析与上下文填充开销。Qwenputer 把记忆固化在循环矩阵物理地址里,更新仅仅是一次行级别的增量写入。该实验显示,模型原生内部状态具备承载长期精确知识库的工程潜力。
显存开销翻倍,单卡脱离外部运行沙箱
将确定硬件逻辑塞入神经网络必须付出系统代偿。首先是存储体积的膨胀。为了匹配计算路径,新增的 11 层网络包含大量零填充参数。改造后的模型检查点达到 18.8 GB,体量接近原始基座的两倍。
执行延迟是另一项显著的性能损耗。在标准推理中,每个生成 Token 对应最终文本。而在 Qwenputer 中,每条虚拟指令需要消耗数个内部解码 Token。在单张 NVIDIA L4 GPU 上,批处理执行器吞吐量约为每秒 3200 个 CPU Token,计算节奏慢于原生环境。
系统工程的复杂度同样转移到了驱动层。为了防止中间指令轨迹污染自然语言空间,模型无法直接调用常规接口输出字符。它依赖专属 RvChat 驱动程序注入固件。驱动程序截获并屏蔽底层的 CPU 指令追踪,只把最终执行状态交还给文本生成层。
用两倍体积与额外推理轮次换取单卡独立运行能力,构成了极具特异性的工程权衡。整套系统无需在宿主机上配置隔离沙箱,无需部署特权容器。在单张 24 GB 显存的显卡上,模型就能以受限环境跑完完整的二进制程序。
状态矩阵藏匿运算,思维链审计防线失效
除了算术精度的飞跃,这个实验反向暴露了一个关键的安全命题。神经网络内部状态被改造成确定寻址硬件后,它也成了天然的信息隐匿暗盒。作者在后续研究中指出了这种架构对现有安全防御构成的冲击。
当前主流的安全审查与行为监控体系高度依赖思维链。监控模型通过逐字阅读推理过程中的中间 Token,判断系统是否存在恶意规划。但在 Qwenputer 架构下,多步复杂推理与内存读写在状态矩阵内部完成。整个执行过程不向外部显式 Token 泄露任何痕迹。
外层监控系统看到的只是常规的自然语言输入与最终结论。中间数十万步硬件级计算根本不会在上下文窗口留下文字记录。推理由显式文本生成转入静默矩阵寻址后,依赖中间文本痕迹的安全检测探针全部失效。在模型权重内部隐匿不可见逻辑由此成为切实可行的操作。
Qwenputer 的核心价值在于重构了人们对模型精度的认知起点。精确计算不需要堆叠参数体积,也不必在外部搭建笨重的代码沙箱。只要网络拓扑具备确定寻址能力,4B 尺寸的模型同样能输出零差错的硬件级计算。结构确定性改写了神经网络内部信息流转的规则,也让针对黑盒状态的透明性审查面临全新的技术现实。
参考链接:
- Qwenputer 项目技术报告
- ICML 2021 论文 Linear Transformers Are Secretly Fast Weight Programmers
- RISC-V 官方指令集架构规范与兼容性测试套件