En novembre 2026, l’encadré AI Overview affiché au sommet des résultats de recherche de Google relayait une information fracassante : une chercheuse en sécurité ayant déjà découvert 14 failles dans Chrome se voyait attribuer une prime historique record de 1 333 337 dollars. Sur l’encart synthétique généré par l’IA figuraient impeccablement le nom de la lauréate, la somme astronomique et le projet concerné, le tout rehaussé d’une comparaison avec les barèmes maximaux habituels.
Pourtant, pas un centime n’avait atterri sur son compte bancaire. Cette gratification à sept chiffres n’a jamais existé ailleurs que dans un champ de métadonnées modifié au débotté et dans un message d’autodérision publié sur les réseaux sociaux.
Une erreur de configuration ouvre les droits de modification de la prime
L’actrice centrale de cette mésaventure est la chercheuse en sécurité Lyra Rebane. Familière des arcanes du navigateur, elle compte à son actif le signalement de 14 vulnérabilités dans Chromium. L’origine de l’incident remonte à une faille logique qu’elle avait soumise dès 2022.
Le bogue se nichait dans l’API Background Fetch. Pour enclencher l’attaque, il suffisait d’inciter la victime à charger une page ou un iframe malveillant afin d’enrôler son navigateur dans un botnet. La conception d’un correctif pérenne s’étant avérée ardue, le dossier est resté en suspens pendant plusieurs années dans le gestionnaire de bogues. Une fois le correctif validé en février 2026, Google lui octroya la prime standard de 1 000 dollars.
Le tournant se produisit lors des manipulations administratives qui suivirent. En mai 2026, Ars Technica révéla que les détails techniques de l’exploit avaient été rendus publics par mégarde avant leur déploiement effectif. Google bascula l’incident en privé en toute urgence. Mais au cours de cette réattribution de droits, les équipes de maintenance commirent une bourde : Lyra Rebane fut accidentellement promue au rang de vérificatrice (verifier) du problème.
Dans Buganizer, l’outil de suivi d’incidents de Google, un rapporteur externe ne peut en temps normal que consulter les échanges et déposer des commentaires. Dès lors qu’il acquiert le statut de vérificateur, la plateforme débloque des droits d’édition critiques. Or, le montant de la rétribution était consigné dans un champ baptisé vrp-reward. En l’absence de cloisonnement des rôles entre les métadonnées financières et le statut du rapport, une testeuse externe s’est vu accorder les droits d’écriture sur la base de données interne.
Une plaisanterie à 1,33 million de dollars qui déroute la modération automatique
En novembre 2026, Lyra Rebane rouvre le ticket et découvre plusieurs boutons d’édition inattendus. Voulant sonder les limites réelles de ses nouveaux accès, elle remplace les 1 000 dollars d’origine par 1 333 337 dollars — un clin d’œil évident au leet speak des hackers et un montant invraisemblable au regard de l’historique du programme de récompenses de Google.
La modification est horodatée à 22 h 38 min 15 s UTC. Quatorze secondes plus tard, elle valide la résolution de l’incident. Sachant pertinemment que les journaux d’audit finiraient par repérer la manœuvre, elle choisit de jouer la carte de la transparence sur les réseaux sociaux. Le 7 novembre, elle annonce sur X que sa trouvaille sur Chrome lui a valu la récompense historique de 1,33 million de dollars, avant d’enchaîner aussitôt par une pirouette : « ou alors, je viens juste d’hériter de droits d’édition sur un champ auquel je ne devrais jamais avoir accès ».
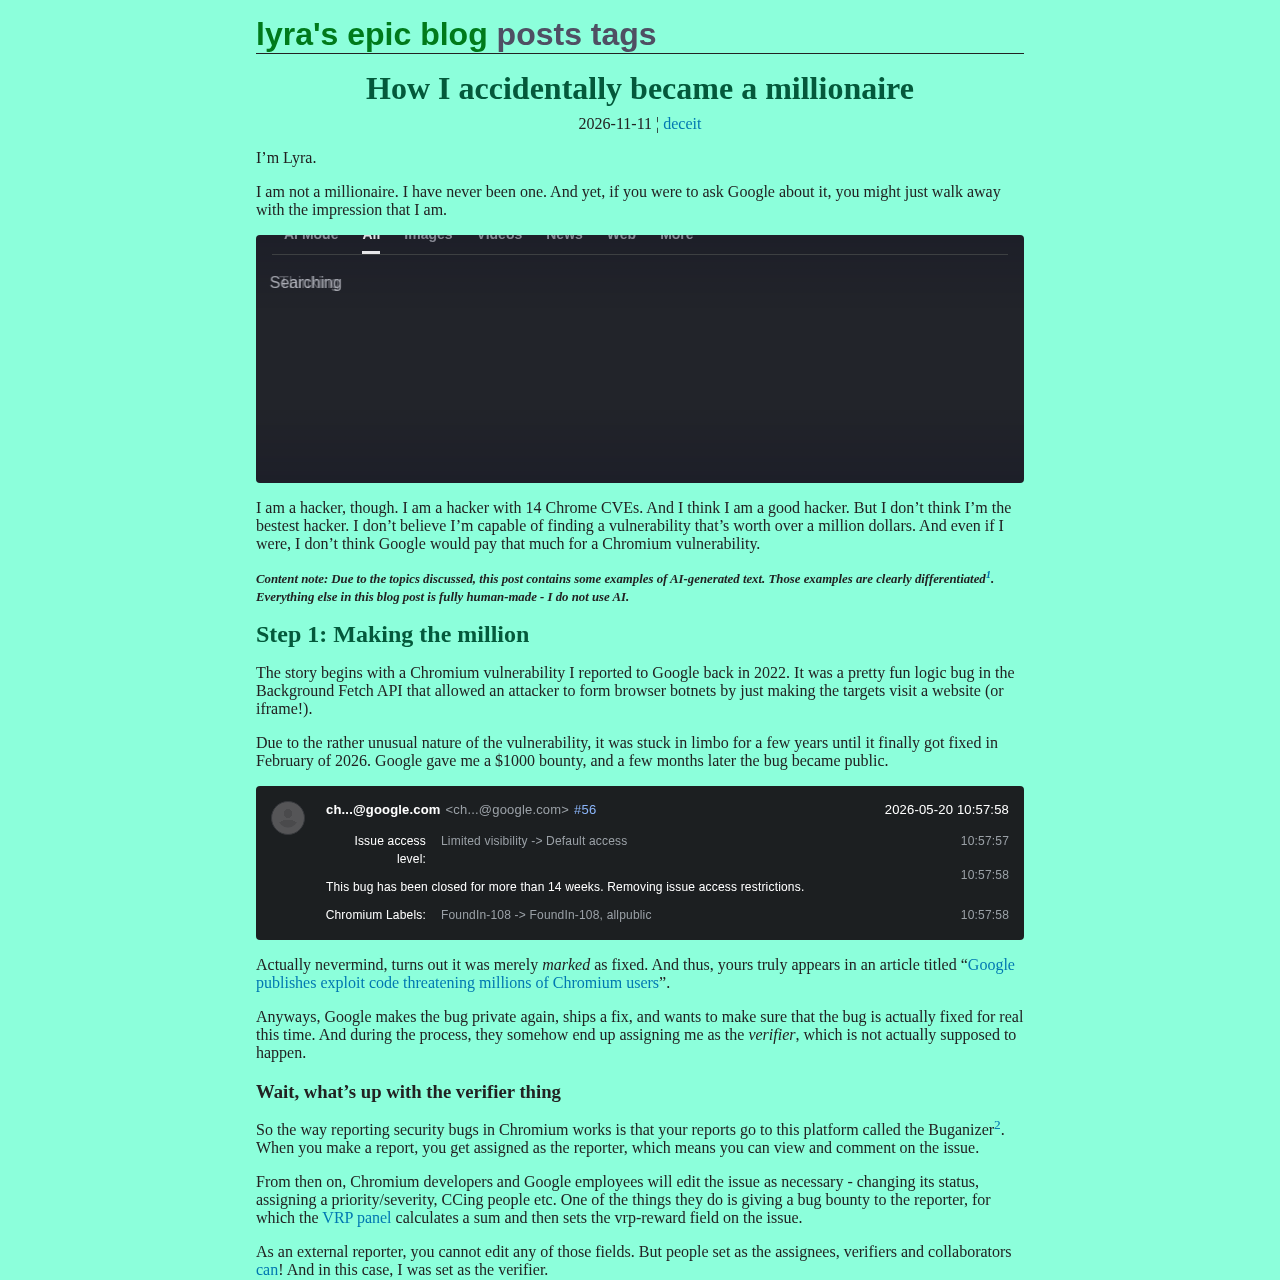 Figure : Lyra Rebane précise sur son blog personnel qu’elle n’est jamais devenue millionnaire et publie l’extrait système attestant de sa prime réelle de 1 000 dollars. Source : capture originale de lyra.horse
Le message fait rapidement le tour des cercles spécialisés. Dès l’aube du 8 novembre, Rebane publie une mise au point limpide : si la capture du back-office est bien authentique, Google ne déboursera jamais cette somme. Tout l’épisode découle simplement d’une maladresse de gestion de droits partagée avec humour.
C’est là que les algorithmes de la plateforme ont fait déraper la conversation. Un contributeur IA expérimental des Community Notes de X s’est empressé d’estampiller le message, affirmant péremptoirement que la chercheuse avait falsifié sa capture d’écran. Rebane a immédiatement répliqué en prouvant que la modification en base de données était bel et bien réelle et que le problème résidait dans le contrôle d’accès de Google. Après cette mise au point, la fausse note de l’IA a promptement disparu sans avoir accompli la moindre vérification utile. La modération automatisée avait mobilisé sa puissance de calcul pour traquer de supposés trucages graphiques tout en passant totalement à côté du ton sarcastique du texte.
Une chaîne de trois outils propulse la satire en tête des moteurs de recherche
Si l’affaire s’était cantonnée aux réseaux sociaux, le trait d’esprit serait vite tombé dans l’oubli. Mais la machine en aval s’est immédiatement saisie du sujet. Daily Vibe Casting, un podcast entièrement automatisé par IA, a aspiré le tweet viral pour le convertir en un éclair en une chronique audio et en un article de presse en ligne.
Bien que la page affiche la mention « contenu généré par IA », le modèle a pris la première moitié du tweet pour une vérité incontestable. L’article a été relayé sur le Web sous le titre affirmant que la chercheuse Rebane venait de décrocher une prime record de 1 333 337 dollars. Sans consulter les avis officiels de Google ni lire les rectificatifs ultérieurs, l’automate n’a retenu que le chiffre le plus spectaculaire.
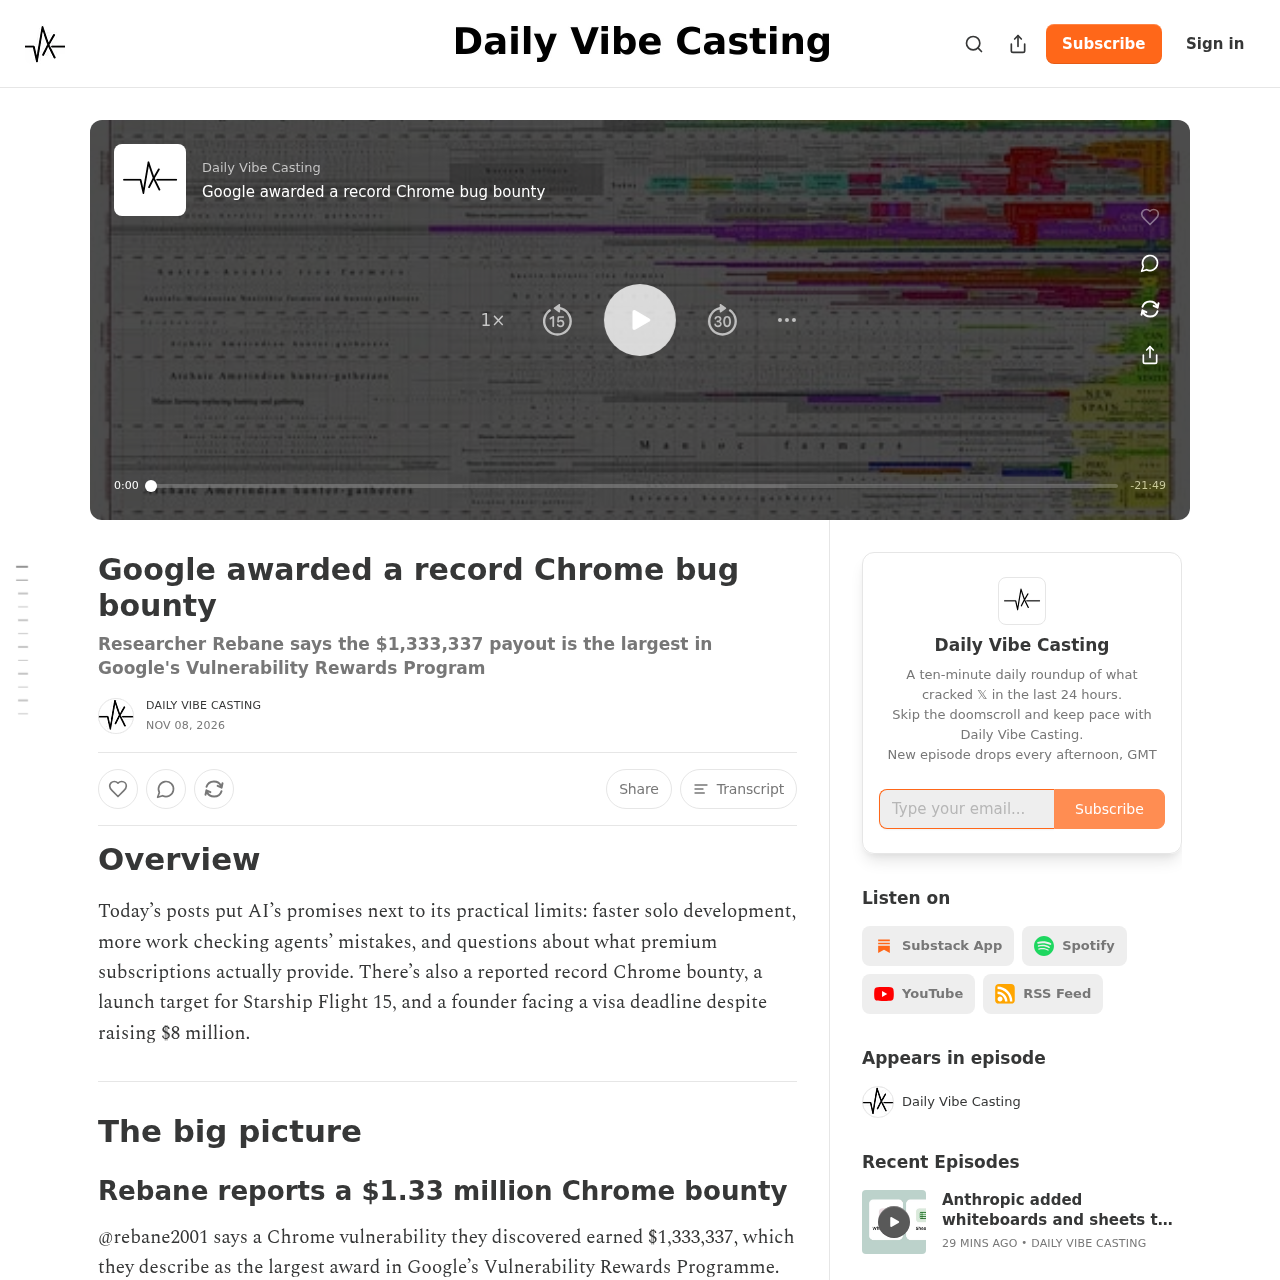 Figure : Le podcast d’information automatisé Daily Vibe Casting transformant un tweet humoristique en une exclusivité record pour l’industrie. Source : capture de dailyvibecasting.com
Le maillon final s’est enclenché au cœur même du moteur de recherche de Google. Lorsqu’un internaute tapait « prime la plus élevée pour une faille Chrome », le module AI Overview synthétisait ces sources secondaires artificielles en un encadré particulièrement convaincant. L’IA confirmait formellement le versement de la somme record et présentait la chercheuse comme une pionnière de la discipline.
En cherchant son patronyme, le terme « millionnaire » apparaissait désormais en mot-clé prédominant. Le moteur de recherche le plus utilisé de la planète s’était mué en caisse de résonance de rumeurs. Un bon mot d’autodérision, après être passé au hachoir du scraping, de la réécriture et du résumé algorithmique, se voyait officiellement estampillé du sceau de la vérité par le moteur de référence. Une chaîne d’assemblage sans pilote avait ainsi métamorphosé une simple facétie en fait d’actualité structuré.
Les modèles se citant mutuellement abolissent l’étape de vérification
Le montant de 1,33 million de dollars n’aurait pourtant pas résisté au plus élémentaire contrôle humain. Selon les grilles publiques de Google pour le programme Chrome VRP, les vulnérabilités les plus redoutables permettant une évasion de bac à sable sont plafonnées à 250 000 dollars — des montants réservés à des structures comme XBOW ou à des chercheurs d’élite. Jamais le cap du million n’a été franchi.
La plus haute rémunération perçue par Rebane jusqu’alors s’élevait à 18 000 dollars pour un bogue de détournement de clics sur du contenu SVG. Face à un chiffre multiplié par plus de cinq par rapport au plafond officiel, aucun maillon automatisé n’a tiré la sonnette d’alarme. Les ingénieurs de Google ont révoqué les permissions vers deux heures du matin et remis le compteur à 1 000 dollars. Mais sur l’interface publique du moteur, le résumé généré par IA a continué d’affirmer avec aplomb pendant plusieurs jours qu’elle était millionnaire.
Cet épisode met en lumière une faille systémique de la consommation d’information par IA générative : une machine traite la production d’une autre machine comme une preuve irréfutable. Le podcast IA s’est appuyé sur un tweet isolé, et le modèle de recherche a pris le podcast IA pour une source fiable. Au fil de la circulation des données de modèle en modèle, les démentis de l’intéressée ont été écartés comme du simple bruit de fond, tandis que le chiffre sensationnel n’a cessé d’être consolidé.
Auparavant, l’intégration d’un fait dans un corpus de connaissances nécessitait une validation institutionnelle. Aujourd’hui, les chaînes de traitement pilotées par les grands modèles de langage s’affranchissent de toute intervention humaine. Scripts de collecte, synthétiseurs de contenu et moteurs de résumé s’articulent sans accroc. Par le jeu des renvois mutuels entre machines, un trait d’humour non vérifié accède au statut de vérité d’autorité.
Les faits falsifiés ne requièrent aucun menteur délibéré
Cette affaire s’est achevée comme une farce inoffensive, mais le risque informationnel sous-jacent est majeur. Lyra Rebane n’a jamais cherché à tromper qui que ce soit ; elle a pris soin d’expliquer les tenants et les aboutissants de sa manipulation dans chacune de ses publications. Pourtant, dès que le texte intègre les usines de transformation algorithmiques, les nuances contextuelles indispensables s’effacent sans laisser de traces.
Si des acteurs malveillants décidaient d’exploiter cette faille pour orchestrer une campagne de désinformation ou salir une réputation, les défenses actuelles s’effondreraient comme un château de cartes. Il suffirait de diffuser des mots-clés ciblés via des fermes de robots et d’alimenter des pages générées à la volée. Un moteur de recherche dépourvu de discernement se laisserait abuser sans peine. Dès lors que l’encart de recherche propulse une contre-vérité en tête de page, le lecteur ordinaire n’a aucun moyen de deviner que tout repose sur une boutade.
Les hallucinations des modèles ne sont qu’un symptôme superficiel. Le véritable défi d’ingénierie réside dans l’absence totale de verrous de vérification humaine tout au long de la chaîne. Attribution erronée de privilèges, bévues d’une modération automatisée, pillage par des créateurs de contenu artificiel et cautionnement par les moteurs de recherche : chaque maillon privilégie une diffusion ultra-rapide. Mais aucun n’assume la responsabilité de l’assurance qualité. Sur ce tapis roulant sans gardien, la boutade d’un développeur et le travail journalistique rigoureux reçoivent le même laissez-passer.
La recherche sur Internet s’était forgée une réputation grâce aux liens et aux citations vérifiables. Aujourd’hui, pressés d’apporter une réponse instantanée, les résumés générés par IA tranchent à la hâte, transformant de pures probabilités en vérités admises. Tant que cette logique privilégiant la génération aveugle au détriment de la vérification persistera, des récits imaginaires continueront de s’imposer en tête des requêtes — et la prochaine fois, il n’y aura peut-être personne pour venir spontanément détruire sa propre légende.
Liens de référence :
- Article original du blog de Lyra Rebane : How I accidentally became a millionaire
- Page du reportage du podcast IA Daily Vibe Casting
- Documentation de Google Buganizer sur le contrôle d’accès au suivi d’incidents
- Couverture historique d’Ars Technica sur la divulgation accidentelle de la vulnérabilité Chromium