2026 年 11 月,Google 搜索顶部的 AI 摘要推送了一条行业快讯。一位报告过 14 个漏洞的安全研究员,被指拿到了历史最高赏金:1,333,337 美元。在搜索卡片里,获奖者、金额与项目名称整齐排列。页面甚至还列出了常规最高档位作为对比。
然而,这位研究员的银行卡里一分钱也没多。这笔千万巨奖在现实中并不存在。它仅仅来自她随手修改的一个后台字段,以及一条公开的玩笑推文。
后台配置失误交出改写金额权限
事件主角是安全研究员 Lyra Rebane。她长期深耕浏览器底层,曾报告过 14 个 Chrome 漏洞。这次混乱的源头,是她在 2022 年提交的一处逻辑缺陷。
该漏洞位于 Background Fetch 接口。攻击者只要诱导目标访问恶意网页,就能把浏览器拉入僵尸网络。因修复方案复杂,补丁在系统里搁置了数年。直到 2026 年 2 月修复完成,Google 向她发放了 1000 美元常规赏金。
转折发生在随后的二次处理中。2026 年 5 月,Ars Technica 报道该漏洞被意外提前公开。Google 紧急将工单重新转为私有。在权限调整过程中,运维人员误把 Lyra Rebane 设成了该问题的验证人(verifier)。
在 Buganizer 工单系统里,外部报告者通常只能查看和留言。一旦变成验证人,系统就会开放核心编辑权。负责记录赏金金额的字段是 vrp-reward。这个敏感字段,恰好允许验证人随意改写。财务元数据缺乏角色隔离。外部测试人员因此获得了修改底层数据库的入口。
133 万美元玩笑穿透平台审核
2026 年 11 月,Lyra Rebane 重新打开工单页面。她发现界面多出了几个修改按钮。为了测试权限范围,她把原本的 1000 美元改成了 1,333,337 美元。这个数字在极客黑话里指代精英,在赏金历史上更是天文数字。
修改发生在 22 点 38 分 15 秒。14 秒后,她顺手将问题标记为已修复。她自知修改会被后台发现,干脆在社交平台公开。11 月 7 日,她发文称漏洞拿到了史上最高赏金 1,333,337 美元。紧接着她在下一句自嘲:「或者,只是我拿到了不该拿的编辑权」。
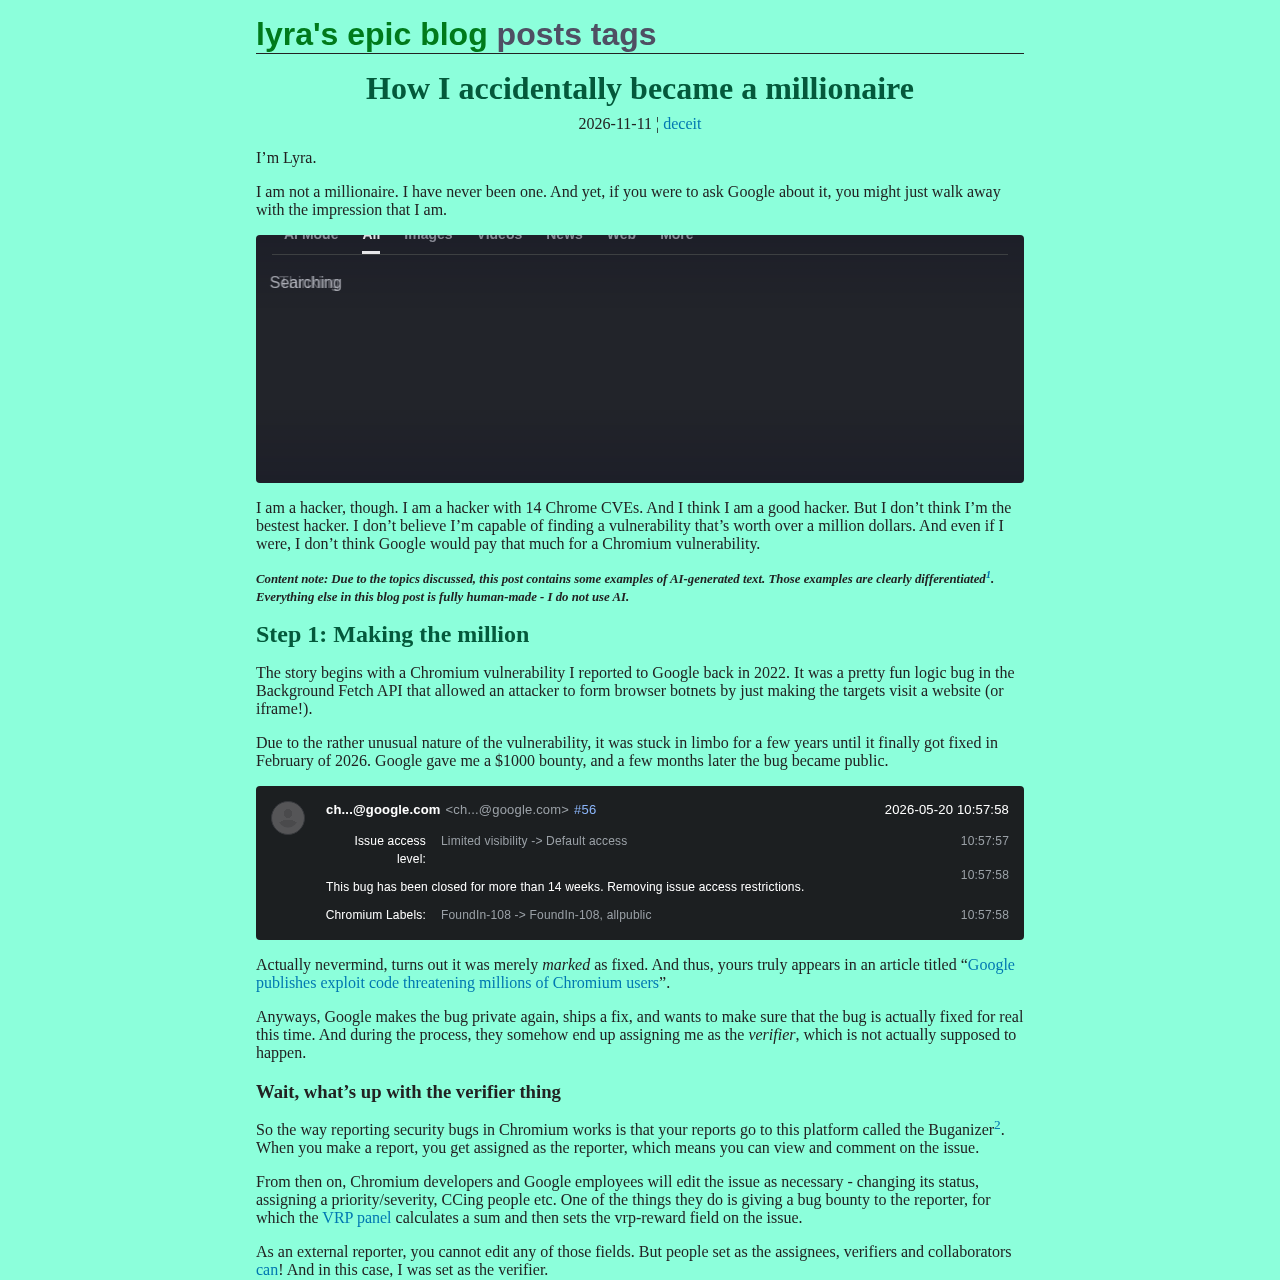 图:Lyra Rebane 在个人博客中澄清自己从未成为百万富翁,并贴出该漏洞实际获得 1000 美元赏金的系统记录。来源:lyra.horse 原文截图
推文迅速在同行圈内扩散。11 月 8 日凌晨,她主动发布了正式澄清。她明确表示工单后台是真的,但 Google 绝不会发放这笔奖金。整件事纯粹是一场误操作引发的自嘲。
平台的自动化机制率先把事情带偏了。实验性 AI 审核账号打上了社区注释,断定她伪造了截图。Lyra Rebane 随即反驳,指出数据库记录属实,问题出在权限分配。被反驳后,这条 AI 注释很快消失,未起到任何核验作用。自动化审核把算力花在质疑截图上。它忽略了帖文最核心的自嘲语境。
三级工具链把调侃捧上搜索头条
如果链路停在社交平台,玩笑很快就会过去。然而,下一级机器迅速加入了接力。全自动 AI 播客 Daily Vibe Casting 抓取了这条推文。系统直接把这条推文做成了音频与图文报道。
页面赫然标着「内容由 AI 生成」。但播客直接把推文的前半句当成了事实。它以「研究员 Rebane 获得 1,333,337 美元最高赏金」为题全网分发。机器不查证官方公告,也不看后续反转,只盯住了最扎眼的数字。
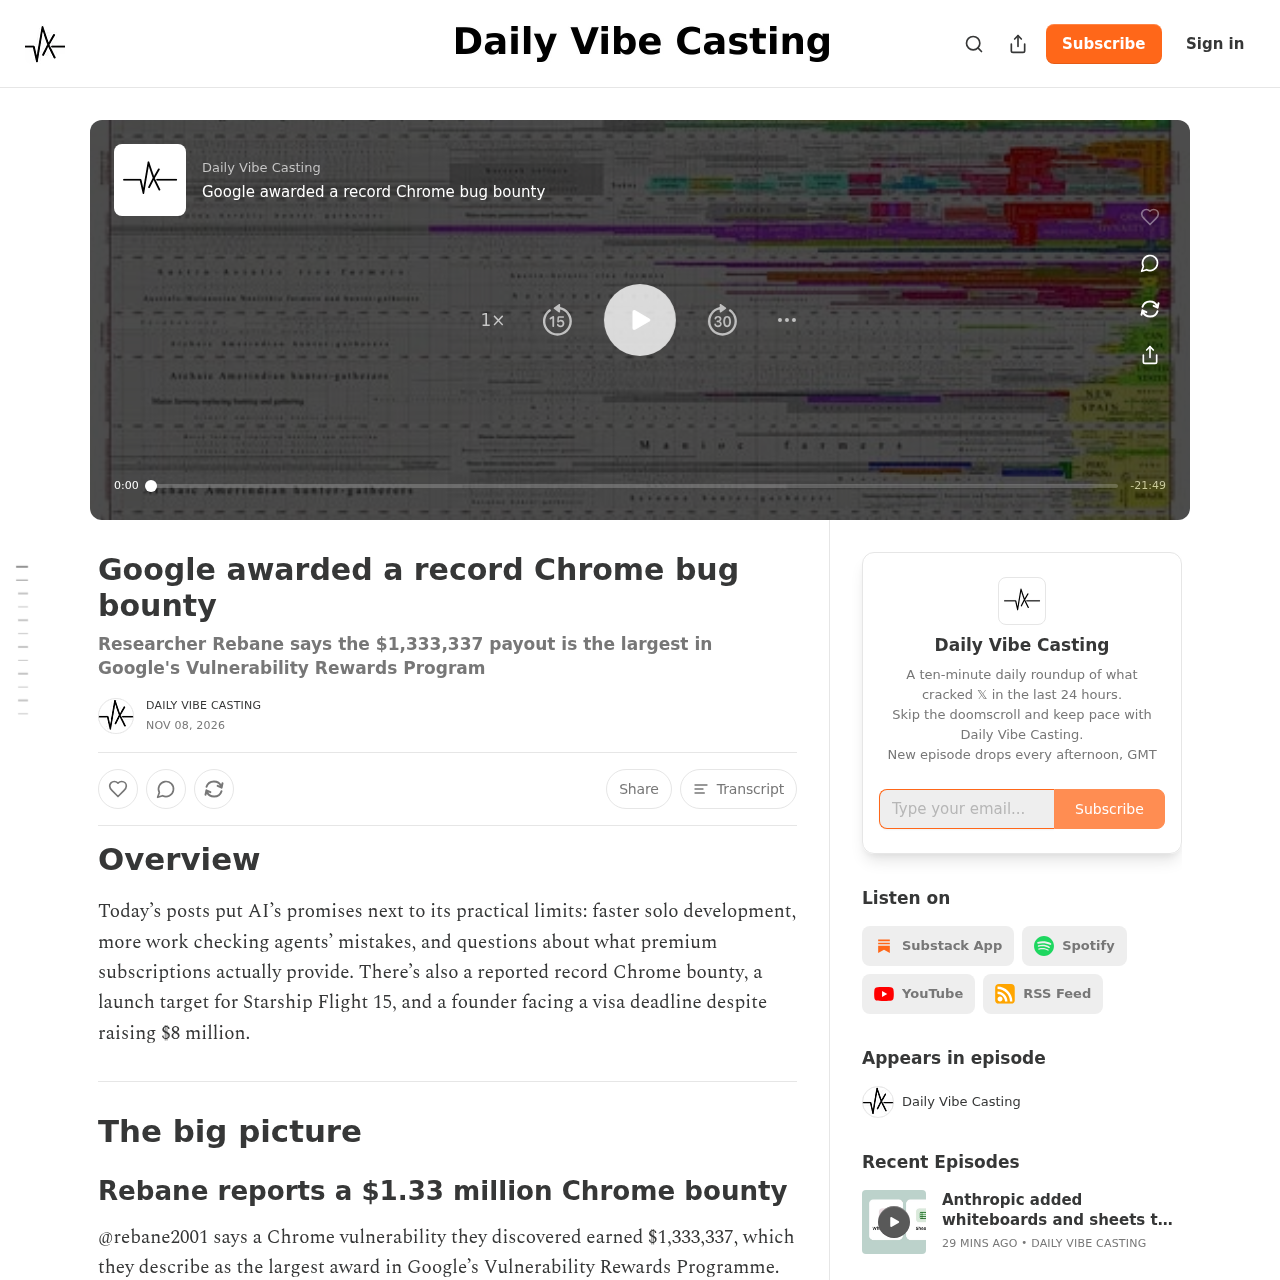 图:AI 自动新闻播客 Daily Vibe Casting 将玩笑推文包装成创纪录的行业新闻。来源:dailyvibecasting.com 页面截图
最后一环落到了 Google 自己的搜索框里。用户输入「Chrome 史上最高赏金」,AI Overview 随即给出总结。系统自动把二手讨论组装成极具信服力的卡片。它直接确认了这笔巨款,还将研究员列为破纪录的新星。
搜索她的名字,跳出的首要标签同样是「百万富翁」。这套顶尖的搜索系统,在此刻成了谣言放大器。原本自嘲的玩笑,经过抓取、改写和摘要三道工序。它被正式印上了权威搜索的质检钢印。全自动流水线只盯眼球标签。它把未经验证的调侃包装成了结构化新闻。
自动化系统相互引用抹掉核实步骤
这个数字只要经过最基础的人工复核就会露馅。按 Google 公开的常规档位,Chrome 最复杂的全链条或沙箱逃逸漏洞封顶在 25 万美元这一档,此前发给过机构 XBOW 与个人研究者,从没上过百万。
她自己公开过的一笔赏金是 SVG 点击劫持的 1.8 万美元。面对膨胀了 5 倍以上的荒唐数字,全链条的自动化节点无一报警。Google 工程师在凌晨两点多收回权限,将金额重置为 1000 美元。但前端的 AI 摘要在此后数天里,依旧坚称她是百万富翁。
这里暴露出模型内容消费的致命缺陷:机器把上一代机器的产物当成了客观证据。AI 播客依赖单条推文,搜索模型又把 AI 播客当作信源。数据在不同模型间流转。原作者的辟谣被当成噪音剔除,数字本身却被反复加固。
传统信息进入知识库,往往需要机构背书。如今由大模型主导的流水线,直接甩开了人工介入。抓取脚本、改写工具和摘要引擎自动啮合。未经核实的笑话,迅速升级为严肃结论。多个模型把彼此的输出当证据。机器间的交叉引用,直接完成了虚构事实的权威化封装。
假事实不需要任何人蓄意撒谎
这次事件以无伤大雅的自嘲收场。但它暴露的信息风险相当严重。Lyra Rebane 从未想过造谣,她在每处发帖都讲清了来龙去脉。然而一旦文本进入机器加工厂,真实的注脚就会被轻易抹掉。
如果有人蓄意利用这套漏洞发起污染,现有的防线将迅速瓦解。攻击者只需用脚本发布特定词条,再建批量网页。缺乏常识的搜索系统很容易被骗过去。权威搜索把假事实放在最顶层,普通读者根本无法发现底层信源只是一句戏言。
大模型答错问题只是表象。真正的工程困境,在于信息链条上缺少人工核验。权限出错、社交误判、播客洗稿、搜索背书,环环追求极速分发。然而,没有一环承担质检责任。在这条无人看守的流水线上,荒唐的调侃与真实的新闻享有相同的通行证。
搜索曾靠引用和链接构建信任。如今为了迎合即时答案,AI 摘要选择直接下结论,把概率拼凑包装成既定事实。只要只顾生成、不顾核验的机制继续运转,虚构故事还会被推上搜索顶部。到那时,恐怕不会再有当事人站出来主动辟谣。
参考链接:
- Lyra Rebane 个人博客原文:How I accidentally became a millionaire
- Daily Vibe Casting AI 新闻播客报道页面
- Google Buganizer 问题跟踪系统权限说明文档
- Ars Technica 关于 Chromium 漏洞修复事故的历史报道