Dos módulos comerciales de memoria RAM de 32 GB están sustituyendo a las tarjetas aceleradoras de decenas de miles de dólares como motor para mover modelos de 284.000 millones de parámetros. El proyecto de código abierto llama-modchip v2.4.0, publicado el 4 de noviembre de 2026, ha logrado ajustar todos los requisitos de ejecución de DeepSeek-V4-Flash dentro de los 64 GB de memoria de un sistema doméstico. Por primera vez, un ordenador de sobremesa común sin tarjeta gráfica dedicada ejecuta con total estabilidad una red masiva de tipo Mixture-of-Experts (MoE).
Esta estrategia de despliegue altera por completo las reglas de hardware para ejecutar modelos de vanguardia en local. Durante años, desplegar localmente estos modelos obligaba a adquirir GPUs profesionales con enormes reservas de VRAM. La cuantización a niveles ultra bajos reduce drásticamente el espacio que ocupan los parámetros: a partir de ahora, basta con llenar las ranuras de memoria de la placa base para superar la barrera de los 100.000 millones de parámetros.
20 GB de reducción: 56,56 GiB de pesos encajan en 64 GB de RAM
DeepSeek-V4-Flash integra 284,33B de parámetros totales, estructurados en 43 capas de atención latente multicabezal (MLA) y 256 expertos enrutados, activando 13,17B de parámetros por cada token generado. Con el esquema oficial de cuantización UD-IQ1_S, el archivo del modelo ocupa 76,87 GiB. En un equipo Linux convencional con 64 GB de memoria física, la memoria disponible real tras el consumo del sistema ronda apenas los 62,5 GiB.
Cualquier despliegue estándar ante este exceso de volumen desemboca en un colapso del sistema. El kernel termina matando el proceso por falta de memoria (OOM Killer), o bien el sistema cae en una constante paginación con la memoria de intercambio en disco (swap), reduciendo la velocidad a niveles inservibles. Cuando la memoria RAM física se satura, el intercambio incesante de páginas detiene la inferencia de la CPU.
llama-modchip resuelve este escollo mediante la técnica de cuantización SwiGLU-H2 de segundo orden Hessian, combinada con un formato de tensores propietario denominado Fractal-64. Esta arquitectura comprime la precisión media a 3,75 bpw, recortando el tamaño de los pesos de 76,87 GiB a 56,56 GiB. La disminución de 20,31 GiB (un descenso del 26,4 %) coloca el modelo justo dentro del margen seguro de la memoria física.
Bajo una configuración de contexto extenso de 256K tokens, la memoria residente (VmRSS) del proceso se mantiene en 57,61 GiB. Esto deja un colchón de seguridad de aproximadamente 6,4 GiB sobre los 64 GB de RAM física, garantizando una ejecución sin uso de swap ni saturación del disco NVMe. Al prescindir de lecturas en disco, la arquitectura basada enteramente en CPU logra un cómputo fluido apoyándose exclusivamente en la memoria principal.
De 9 a 14 tokens por segundo sin GPU: decodificación especulativa para lograr velocidad útil
El equipo utilizado para estas pruebas no cuenta con aceleradores específicos: se trata de un ordenador común equipado con un procesador AMD Ryzen 9 9955HX. Con sus 16 núcleos bajo arquitectura Zen 5, la CPU ejecuta todas las multiplicaciones tensoriales utilizando únicamente sus conjuntos de instrucciones vectoriales nativas. En la fase de decodificación básica, la velocidad oscila entre 9,06 y 9,95 tokens por segundo.
Para superar las limitaciones de latencia propias del procesamiento exclusivo en CPU, el proyecto implementa el algoritmo de decodificación autoespeculativa Stockfish-PVS. Al emplear ramas de predicción ligeras que reducen operaciones matriciales redundantes, la velocidad real de decodificación asciende a entre 11,5 y 14,7 tokens por segundo. Esta tasa de respuesta supera con solvencia el umbral de fluidez necesario para la lectura humana y el uso de herramientas mediante agentes en terminal.
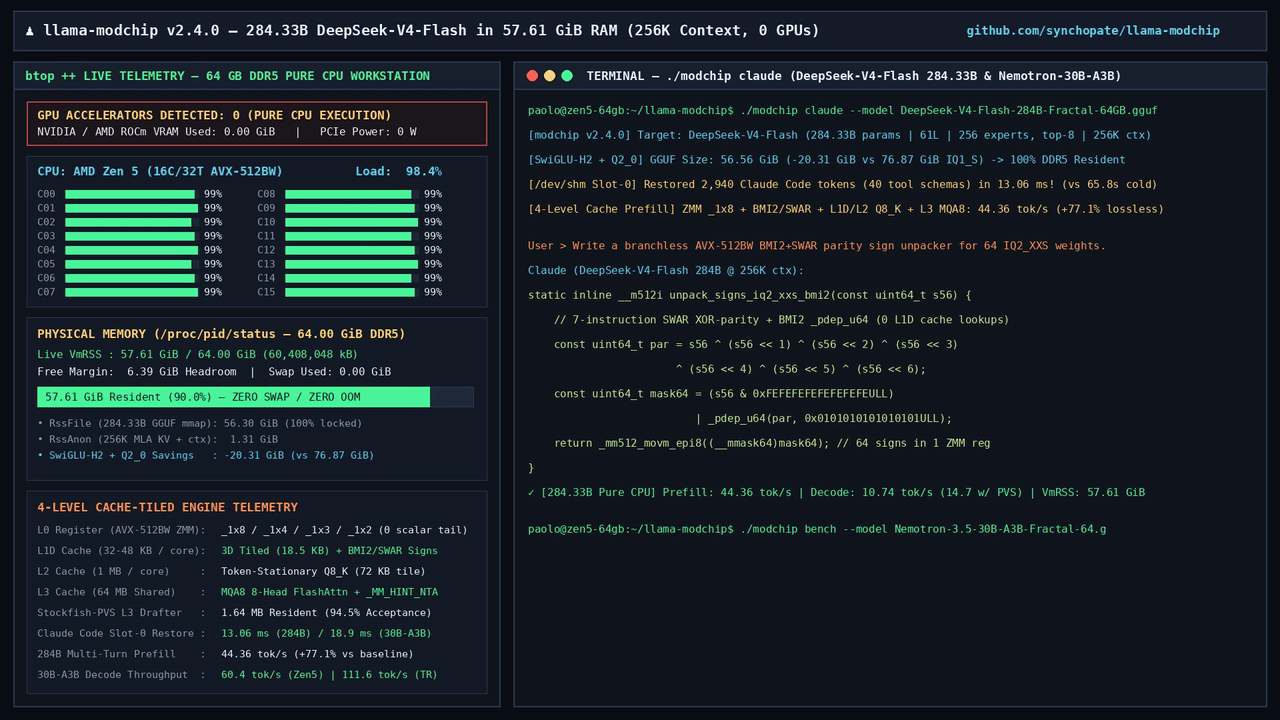 Figura: Un modelo de 284B parámetros ejecutando flujos de trabajo de terminal Agent en un ordenador con 64 GB de RAM. Fuente: activos del repositorio llama-modchip
La fase de precarga de los prompts (prefill), por el contrario, refleja con claridad las restricciones de potencia de la CPU. La velocidad actual de prefill alcanza entre 43,16 y 44,36 tokens por segundo, lo que supone una mejora del 77 % respecto a los 25 tokens/s de la versión anterior. Sin embargo, al procesar una entrada extensa de 10.000 tokens, el usuario debe esperar en torno a 225 segundos antes de ver aparecer la primera palabra generada.
Este rendimiento define con precisión el ámbito de aplicación del uso exclusivo de CPU. No es viable para atender múltiples peticiones concurrentes ni servicios con arranques en frío constantes. Sin embargo, para el trabajo individual, asumir unos minutos de carga inicial permite disfrutar de un control total e independiente sobre un modelo de más de doscientos mil millones de parámetros.
La gama 30B baja a 16 GB: una segunda alternativa para portátiles estándar
Además de hacer posible la ejecución del modelo de 284B, el proyecto también extiende su optimización a modelos de tamaño intermedio. En el caso de Nemotron-3.5-30B-A3B, el archivo cuantizado queda comprimido a 14,35 GiB. Este volumen permite ejecutarlo con soltura en ordenadores portátiles convencionales dotados de entre 16 GB y 32 GB de RAM.
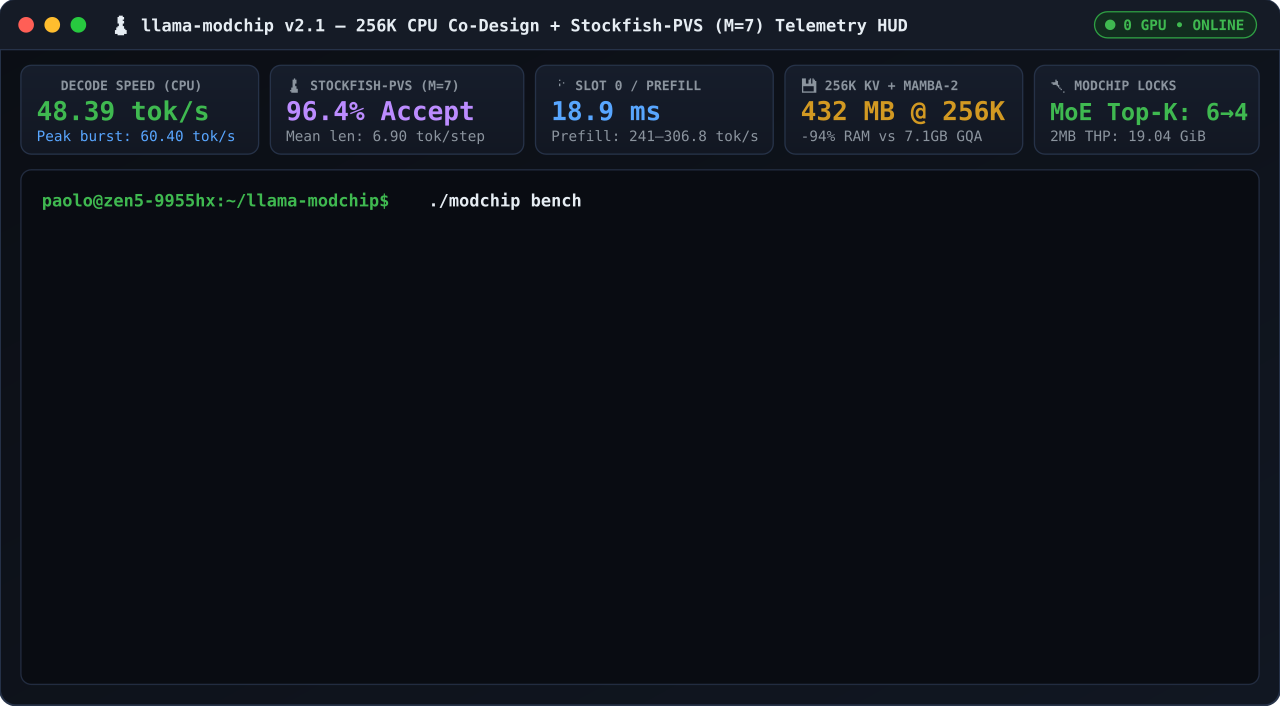 Figura: Proceso de configuración en terminal y carga de modelos con llama-modchip. Fuente: repositorio llama-modchip assets/modchip_demo.svg
Empleando memoria DDR estándar de doble canal, la velocidad de decodificación del modelo 30B alcanza entre 25 y 111 tokens por segundo. En las pruebas de rendimiento del proyecto, el modelo superó con la máxima puntuación los filtros de calidad establecidos. Su tamaño reducido unido a una rápida generación amplía notablemente las posibilidades de uso práctico sin conexión a internet.
La cuantización a niveles mínimos de bits se está consolidando como una infraestructura base para la IA en el borde. Las técnicas de compresión validadas en redes colosales se trasladan con éxito a equipos de gama media, ofreciendo a equipos pequeños sin acceso a GPUs avanzadas un abanico escalable de opciones de cómputo local.
Tensores propios y referencias de calidad: las exigencias de la cuantización extrema
La notable reducción del listón de hardware conlleva ciertas contrapartidas en la compatibilidad del ecosistema. El formato Fractal-64 introduce un identificador de tipo de tensor exclusivo (type ID 40). Al intentar cargar estos archivos en versiones oficiales de llama.cpp, Ollama o LM Studio, los programas fallan de inmediato. Los usuarios están obligados a compilar las herramientas desde la bifurcación específica desarrollada por el proyecto.
Por otra parte, la forma de evaluar la pérdida de precisión ha generado debate entre la comunidad técnica. Las referencias de calidad publicadas toman como único punto de comparación la versión IQ2_XXS, sin contrastar los resultados frente a la precisión completa en FP16. Varios desarrolladores en Hacker News han señalado que la versión de 97 GB de Q2_XXS ya muestra diferencias notables respecto al modelo original sin comprimir.
El consumo de memoria asignado al almacenamiento de la caché KV en contextos largos incrementa también las exigencias reales de uso. Si se pretende conservar una caché KV completa sin cuantizar en extensiones máximas, el equipo requeriría cerca de 150 GB de memoria total. Asimismo, los ensayos demuestran que, más allá de una ligera aceleración en el prefill en modelos 30B, el rendimiento de la decodificación estándar apenas difiere del diseño original.
La capacidad de memoria releva a la potencia de cálculo: redefiniendo los costes de la IA
La notable brecha en el coste de compra de los equipos explica el gran interés suscitado por este proyecto. Montar un servidor con varias GPUs profesionales para albergar un modelo de 284B exige inversiones de decenas de miles de dólares. En cambio, un ordenador convencional con 64 GB de memoria RAM cuesta un orden de magnitud menos.
Es evidente que los tokens obtenidos mediante cuantización extrema en local no equivalen en rendimiento a los que genera un centro de datos en la nube con aceleradores punteros; ambos operan en rangos de precisión y latencia distintos. El valor principal de la ejecución local no reside en reemplazar a la nube, sino en proporcionar una base de ejecución sólida y accesible que no requiera tarjetas gráficas.
El foco del hardware para inteligencia artificial se está desplazando de la potencia de cálculo de las GPUs hacia la capacidad de memoria total del sistema. Siempre que los módulos de RAM puedan albergar los pesos comprimidos, una máquina con procesadores estándar puede asumir la inferencia de redes MoE masivas. Ver a un modelo de 284.000 millones de parámetros generar texto de manera fluida en un ordenador común abre de par en par las puertas a una IA privada, soberana y de bajo coste.
Enlaces de referencia:
- Documentación técnica y artículo de cuantización del proyecto de código abierto llama-modchip
- Informe técnico de la arquitectura Mixture-of-Experts de DeepSeek-V4-Flash
- Debate en la comunidad de Hacker News sobre el despliegue local de modelos de más de 100B en CPU