市販の 32GB メモリモジュール 2 枚が、数百万円クラスの専用アクセラレータに代わり、2840 億パラメータを誇る超巨大モデルを駆動する支点となりつつある。2026 年 11 月 4 日に公開されたオープンソースプロジェクト llama-modchip v2.4.0 は、DeepSeek-V4-Flash の実行フットプリントを 64GB メモリ内に完全に収めることに成功した。単体 GPU を搭載しない汎用デスクトップ PC が、数千億規模の Mixture-of-Experts(MoE)モデルを安定して動かし始めている。
このアプローチは、最先端モデルをローカルで動かすためのハードウェアの前提を根本から書き換えつつある。これまで最先端の重みを自前環境で実行するには、巨大な VRAM を備えたエンタープライズ向け計算カードの導入が不可欠だった。極小ビット幅の量子化技術によってパラメータの格納容量が劇的に圧縮された結果、マザーボードのメモリスロットを埋めるだけで、誰でも千億級モデルの門戸を叩けるようになった。
20GBの冗長性を削減:56.56GiBの重みを64GBメモリに格納
DeepSeek-V4-Flash は総計 284.33B のパラメータを持ち、43 層のマルチヘッド潜在的アテンション(MLA)と 256 基のルーティングエキスパートで構成され、トークンごとに 13.17B のパラメータがアクティベートされる。公式標準の UD-IQ1_S 量子化を適用した場合でも、チェックポイントの容量は 76.87 GiB に達する。64GB メモリを積んだ一般的な Linux マシンでは、OS やシステム予約分を引いた実効空き容量はおよそ 62.5 GiB にとどまる。
この容量差のまま従来の手法で実行すれば、確実にシステム破綻を招く。カーネルの OOM Killer によりプロセスが強制終了されるか、仮想メモリへの激しいスワップアウトが発生して演算が極端に停滞する。物理メモリが枯渇した環境では、頻繁なページイン・ページアウトによりプロセッサの推論処理が実質的に停止してしまう。
llama-modchip は独自開発の SwiGLU-H2 二次ヘッシアン量子化技術を採用し、特注の Fractal-64 形式を用いてテンソル構造を再構築した。これにより平均パラメータビット幅を 3.75 bpw まで抑制し、重みサイズを 76.87 GiB から 56.56 GiB へと圧縮した。全体で 20.31 GiB(26.4%)の削減を達成し、モデルを物理メモリの安全圏へと滑り込ませた。
256K のロングコンテキスト設定時においても、プロセスの常駐メモリ(VmRSS)は 57.61 GiB に抑えられている。64GB の物理メモリに対して約 6.4 GiB のバッファが確保され、仮想メモリスワップおよび NVMe へのディスクスラッシングを完全にゼロ化。ディスクアクセスを回避した純 CPU 構成により、メインメモリのみで安定した演算を持続できる。
GPUなしで秒間9〜14トークン出力:自己投機的デコードが実用速度を切り拓く
この検証環境には専用のアクセラレータは一切存在せず、AMD Ryzen 9 9955HX を搭載した一般的なデスクトップ PC に過ぎない。16 コアの Zen 5 アーキテクチャをベースとするこの CPU は、純粋なプロセッサ命令セットのみですべてのテンソル積を処理する。素のデコードフェーズにおける出力速度は、毎秒 9.06 〜 9.95 トークンを維持する。
CPU 処理特有のレイテンシ限界を突破するため、プロジェクトは Stockfish-PVS 自己投機的デコード(Self-Speculative Decoding)アルゴリズムを導入した。軽量な予測分岐によって不要な行列計算を省くことで、実効デコードスループットを毎秒 11.5 〜 14.7 トークンまで引き上げることに成功。この速度は、人間の読書速度やターミナル経由のツール呼び出しにおける実用ラインを十分にクリアしている。
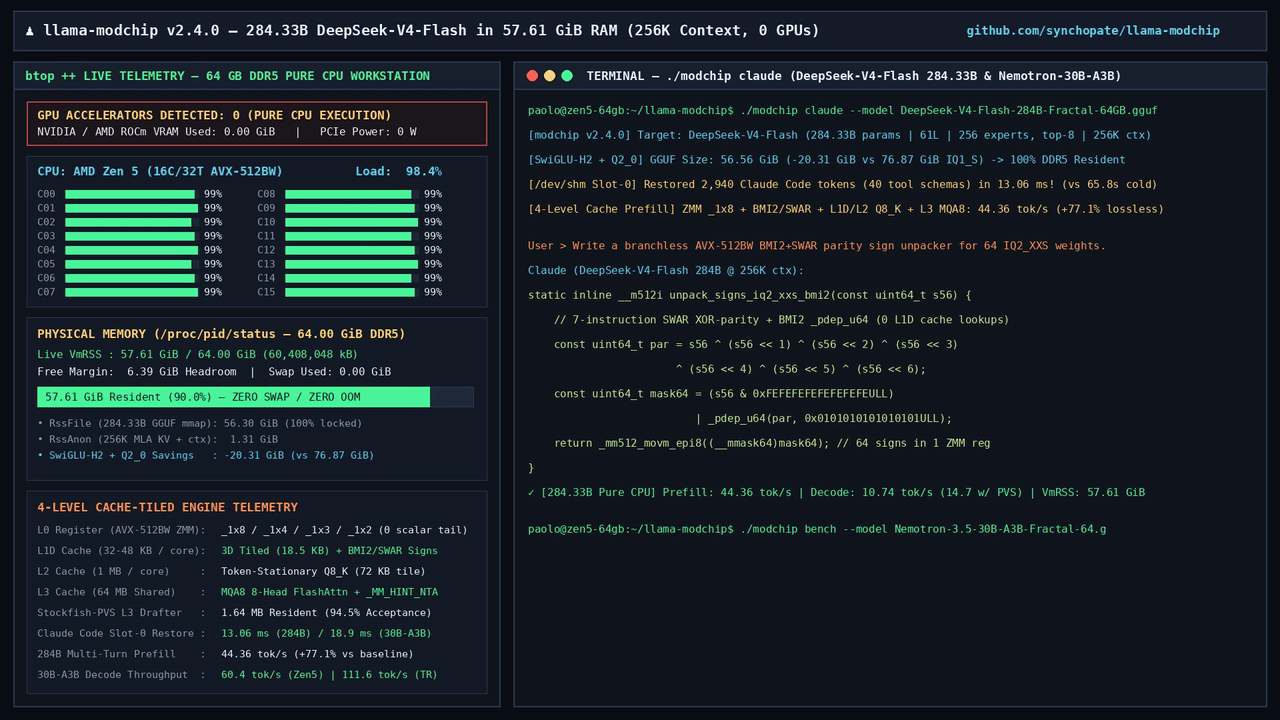 図:64GB メモリ搭載デスクトップ上でターミナル Agent 処理を自律実行する 284B モデル。出典:llama-modchip リポジトリ assets
一方で、プロンプトのプリフィル処理には CPU の計算力的な限界が露呈する。現バージョンのプリフィル速度は毎秒 43.16 〜 44.36 トークンであり、前バージョンの毎秒 25 トークンから 77% 向上したものの、1 万トークンの長文プロンプトを処理する場合、最初の 1 文字が出力されるまでに約 225 秒の待機を要する。
この特性は、CPU 単体運用の明確な適用境界を示している。高並発の商用リクエストや頻繁なコールドスタートを伴う対話型サービスには適さない。しかし個人ユースにおいては、最初の数分間の取り込み時間を引き換えに、2000 億超のパラメータを完全に手元で独占・制御できるメリットは極めて大きい。
30Bクラスは16GBへ:ミドルスペック機をカバーする第2の選択肢
本プロジェクトは 284B の超巨大モデルへの対応にとどまらず、中規模モデル向けの軽量化パイプラインも用意している。Nemotron-3.5-30B-A3B を量子化変換したチェックポイントは 14.35 GiB まで縮小され、16GB から 32GB のメモリを搭載する主流のノート PC でも稼働可能となった。
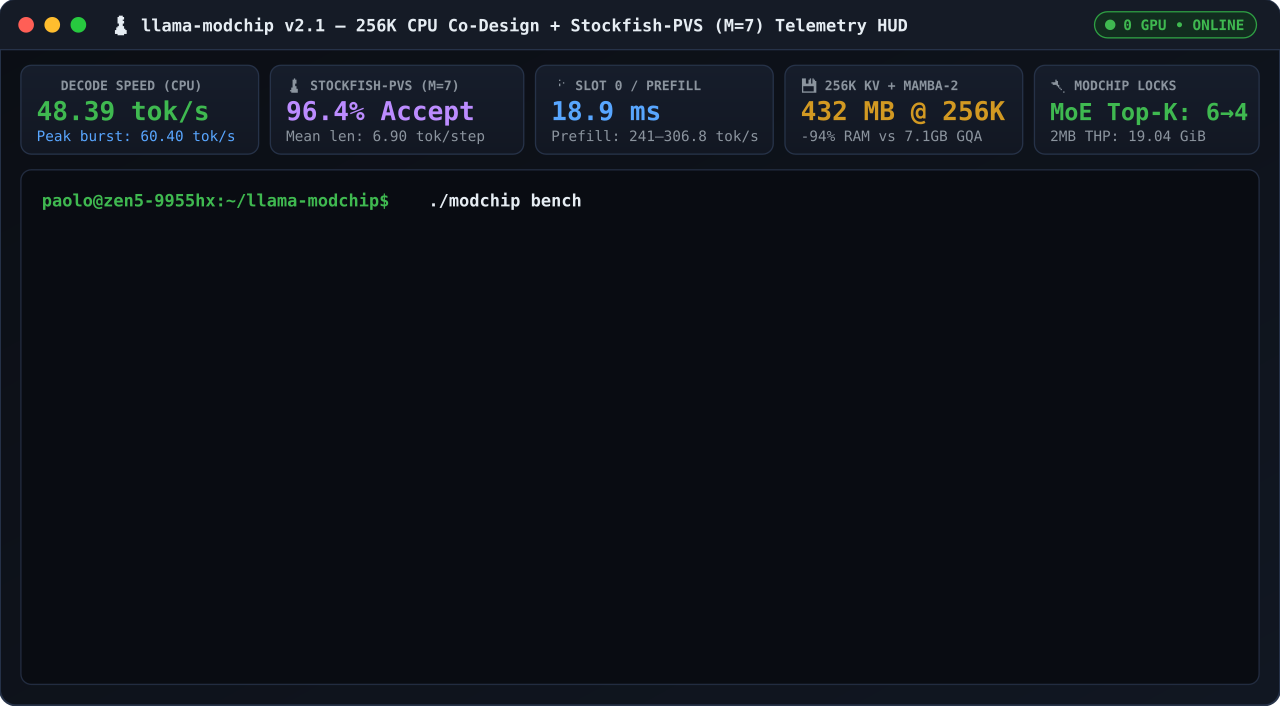 図:llama-modchip のターミナル設定およびモデルロード手順。出典:llama-modchip リポジトリ assets/modchip_demo.svg
一般的なコンシューマー向けデュアルチャネル DDR メモリ環境において、30B モデルのデコードスループットは毎秒 25 〜 111 トークンに達する。開発チームのベンチマーク評価でもすべての品質ゲートを無傷でパスしており、コンパクトな容量と俊敏なレスポンスが、中規模モデルのオフライン実用性を一段と高めている。
極小ビット量子化は、エッジ運用の共通基盤へと急速に進化している。最大級のネットワークで実証された圧縮手法がミドルレンジ機器へと水平展開され、高額な専用カードを持たない小規模チームにも実用的なローカル推論の選択肢がもたらされた。
独自テンソルと品質基準:極限量子化に突きつけられる実証課題
ハードウェアの敷居を劇的に下げる一方で、エコシステムの互換性という大きな代償を払っている。Fractal-64 形式は独自のテンソル型識別子(type ID 40)を使用しているため、本家 llama.cpp や Ollama、LM Studio などの汎用ランタイムでは直接読み込めずエラーとなる。推論を実行するには、プロジェクトが提供する専用フォークからバイナリをビルドする必要がある。
また、精度低下の評価手法についてもコミュニティ内で議論を呼んでいる。プロジェクトが公開している品質ベンチマークは IQ2_XXS との比較のみにとどまり、FP16 フル精度との直接比較は行われていない。Hacker News 上の開発者からは、97GB 版の Q2_XXS モデルであっても原典のフル精度出力と明らかな解離が見られるとの指摘が上がっている。
さらに、長文コンテキストにおける KV キャッシュのメモリ消費も現実的な課題だ。非量子化の KV キャッシュを長文展開した場合、システム全体で約 150GB のメモリが必要となる。実測値によれば、30B モデルのプリフィルが若干高速化された以外は、通常デコードの挙動はオリジナルの実装と大差ないという報告もある。
計算リソースからメモリ容量へ:数千億モデルのコスト構造改革
導入コストの圧倒的な落差が、このソリューションの求心力を裏付けている。284B クラスのモデルを自前で収容するマルチ GPU クラスタを構築するには、数万ドル規模の投資が避けられない。それに対し、64GB メモリを積んだ一般的な PC の調達コストは文字通り一桁低い。
もちろん、超低ビット量子化されたローカル推論の出力は、クラウド上の巨大 GPU クラスタが提供する高精度・超高速トークンとそのまま同列には扱えない。両者が狙うレイテンシや品質の領域は別物である。ローカル運用の本質はクラウドの代替ではなく、GPU がない場所でも確実に動く自律的な実行基盤を手に入れることにある。
AI ハードウェアの関心は、GPU の演算力からシステム全体のメモリ容量へと確実に広がりを見せている。圧縮された静的重みをメモリに乗せられる限り、普通の CPU ノードが千億級 MoE モデルの推論を立派に支えられる。家庭用 PC が 2840 億モデルの出力を刻み始めた事実は、低コストなプライベート AI 時代の本格的な到来を告げている。
参考リンク:
- llama-modchip オープンソースプロジェクト技術ドキュメントおよび量子化論文
- DeepSeek-V4-Flash Mixture-of-Experts アーキテクチャ技術レポート
- Hacker News コミュニティにおける CPU ローカル千億モデル運用の議論