Neue iPhones hängen im Aktivierungsbildschirm fest
Am Vormittag des 17. November 2026 stießen unzählige Nutzer beim Einrichten ihrer neuen iPhones auf dieselbe Fehlermeldung: Unable to Activate – Aktivierung fehlgeschlagen. Die Hardware wies keinerlei Defekt auf; der Engpass lag vollständig auf Seiten der Apple-Infrastruktur. Im Tagesverlauf weitete sich die Störung über iPhone, iPad, Mac, Apple Watch und Apple TV aus. Selbst in den stationären Apple Stores konnten zeitweise weder Bestellungen abgewickelt noch Retouren verbucht werden.
Die offizielle Systemstatusseite von Apple – gewissermaßen ein digitaler Gesundheitsbericht, auf dem funktionierende Dienste grün markiert und beeinträchtigte Systeme gesondert ausgewiesen werden – meldete anfangs sechs Ausfälle: App Store, Apple Music, iCloud-Account und -Anmeldung, AppleCare auf dem Gerät, App Store Connect sowie Xcode Cloud. Besonders gravierend erwies sich der Ausfall von iCloud-Account und -Anmeldung: Sowohl der Kauf von Apps als auch die Erstaktivierung eines Geräts setzen eine erfolgreiche Authentifizierung voraus. Bricht dieses vorgelagerte Nadelöhr weg, werden nachgelagerte Prozesse unweigerlich mit in den Abgrund gerissen.
Jenseits des offiziellen Dashboards fiel die Liste der von Nutzern gemeldeten Störungen noch deutlich länger aus: Apple News, Apple Pay, Apple Card, Apple Support, Anmelden mit Apple (Sign in with Apple), TestFlight und weitere Dienste kamen hinzu – gut zehn weitere Posten. Im Reddit-Forum r/Apple_Employees berichteten Mitarbeiter, dass selbst interne Systeme in Retail-Stores und Firmenbüros gleichzeitig lahmgelegt waren. Zusammengenommen überstieg die Zahl der betroffenen Dienste problemlos die Marke von zwanzig.
Auf der Störungsmeldeplattform Downdetector schossen die Problemmeldungen für App Store, iCloud und Apple Support zeitgleich in die Höhe. Derartige Kurven aus Nutzersignalen reagieren typischerweise deutlich schneller als offizielle Bekanntmachungen: Noch bevor der Konzern das Ausmaß des Schadens eingegrenzt hatte, hatten die Endgeräte der Kunden längst Fakten geschaffen.
Apple schließt Cyberangriffe aus und bekennt sich zu internem Update-Fehler
Apple versuchte nicht, die Schuld externen Angreifern zuzuschieben. In einer Erklärung gegenüber Bloomberg-Reporter Mark Gurman formulierte das Unternehmen unmissverständlich: „Ein internes Update hat heute Morgen zu Unterbrechungen bei einigen Diensten geführt. Die meisten unserer Systeme laufen inzwischen wieder.“ Von entscheidender Bedeutung war der explizite Ausschluss eines Cyberangriffs – diese Klarstellung entzog den reflexartigen Spekulationen über gezielte Hacking-Angriffe sofort den Boden. Ein „internes Update“ bezeichnet Konfigurations- oder Softwareanpassungen auf den Servern in Apples eigenen Rechenzentren. Dies unterscheidet sich grundlegend von App-Updates auf Endgeräten und gleicht eher dem Austausch der Hauptstromversorgung eines Ladengeschäfts während der regulären Öffnungszeiten.
Gegen 17:24 Uhr US-Ostküstenzeit meldeten amerikanische Medien, dass die zentralen Endkundendienste weitgehend wiederhergestellt seien, während Apple eine zügige Behebung der restlichen Störungen versprach. Für Privatnutzer war der Zwischenfall bis zum späten Nachmittag im Wesentlichen ausgestanden. Doch der eigentliche Rattenschwanz zog sich an anderer Stelle hin: Die Infrastruktur für Entwickler erholte sich wesentlich langsamer.
Wie kann ein einziges internes Update über zwanzig Dienste gleichzeitig zu Fall bringen? Die Antwort liegt in der Architektur moderner Großplattformen verborgen: Sämtliche Dienste teilen sich dieselben basalen Abhängigkeiten – Authentifizierung, Identitätsverwaltung und Konfigurationsverteilung. Wird eine dieser gemeinsamen Kernkomponenten durch eine fehlerhafte Änderung destabilisiert, wächst sich die Störung augenblicklich von einem punktuellen Defekt zu einem plattformweiten Flächenbrand aus.
In der Zuverlässigkeitstechnik (Site Reliability Engineering) gilt ein alter Grundsatz: Für den Ausfall von Produktivsystemen sorgt fast ausnahmslos die eigene Bereitstellungspipeline. Angreifer von außen stellen zweifellos eine Gefahr dar; wenn jedoch eine gesamte Infrastruktur gleichzeitig offline geht, spielen Hacker nur selten die Hauptrolle.
Zwei getrennte Status-Dashboards, uneinheitliche Systemgrenzen
Wer während des Vorfalls in Erfahrung bringen wollte, welche Systeme konkret ausgefallen und welche bereits wieder online waren, war auf Apples eigene Übersichtsseiten angewiesen. Apple betreibt jedoch zwei verschiedene Statusseiten: eine für Entwickler und eine für Endverbraucher. Und diese beiden Übersichten stimmen keineswegs überein. So taucht HomeKit – das Framework zur Steuerung vernetzter Lampen und Türschlösser – ausschließlich auf der Verbraucherseite auf. Wer ergründen wollte, warum die Beleuchtung im Smart Home streikte, und wer wissen wollte, warum ein App-Build fehlschlug, musste sich die Antworten auf zwei getrennten Seiten zusammensuchen.
Auch im zeitlichen Verlauf zeigte sich ein bezeichnendes Ungleichgewicht. Am Morgen des 18. November Pekinger Zeit – dem Tag nach dem Ausfall – wies das Entwickler-Dashboard immer noch sieben gestörte Dienste aus: den Notarisierungsdienst für Drittanbietersoftware (Developer ID Notary Service), drei Zugänge zu App Store Connect, den Verkaufsanalysedienst Sales and Trends sowie die Portale Apple Music Connect und Apple Music for Artists (zwei weitere Dienste wurden als „behoben“ geführt). Während der Privatkundenbereich bereits am Vorabend größtenteils entstört worden war, schleppte der Entwicklerbereich eine lange Fehlerliste mit sich herum. Die Zeche für Infrastrukturunfälle zahlen in der Praxis fast immer zuerst die Softwareentwickler.
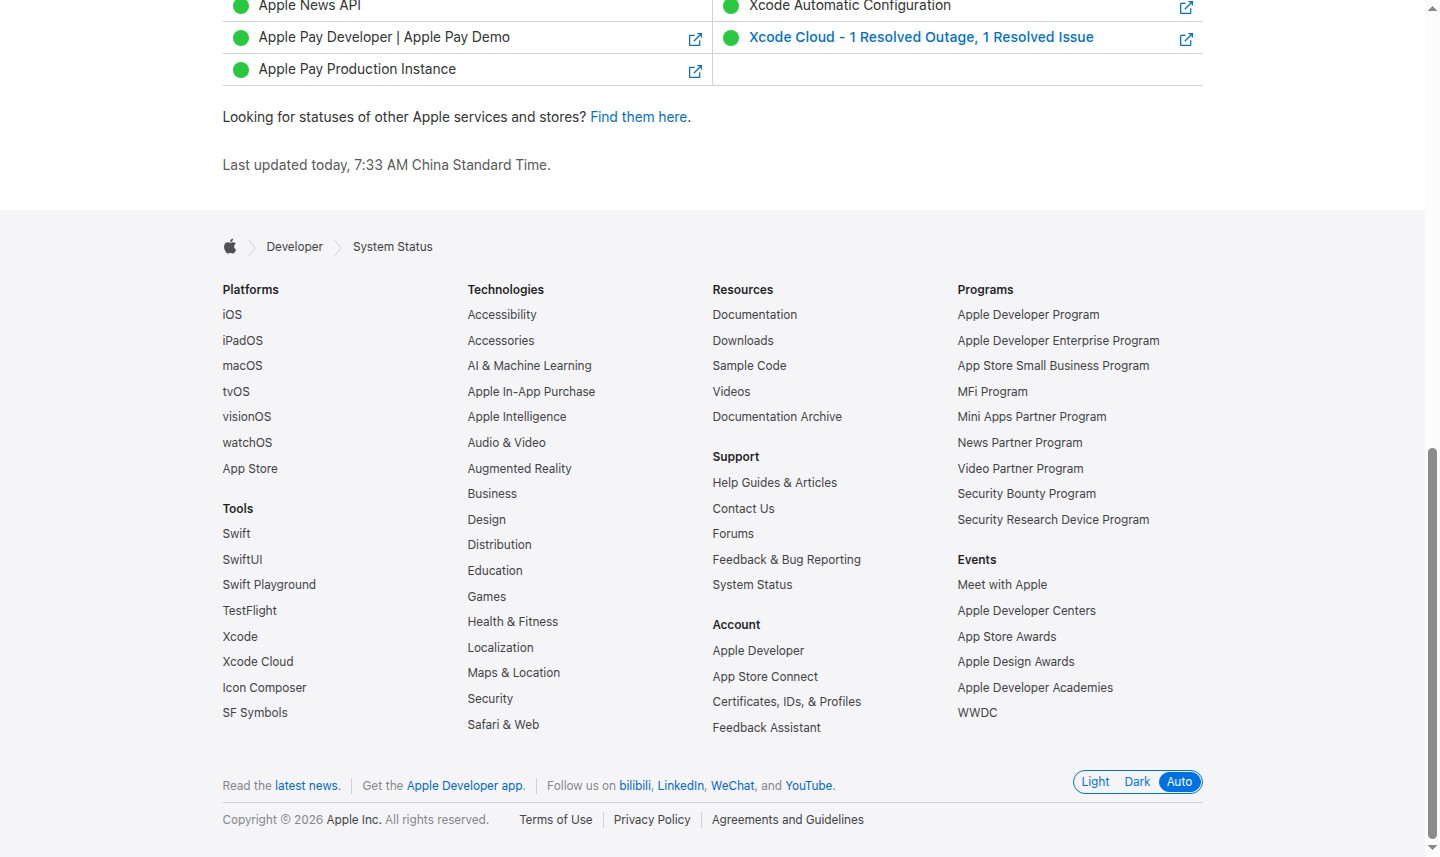 Abbildung: Die Apple Entwickler-Statusseite wies auch am Folgetag noch mehrere aktive Störungen aus, sauber getrennt nach beeinträchtigten und wiederhergestellten Systemen. Quelle: Offizielle Statusseite von Apple
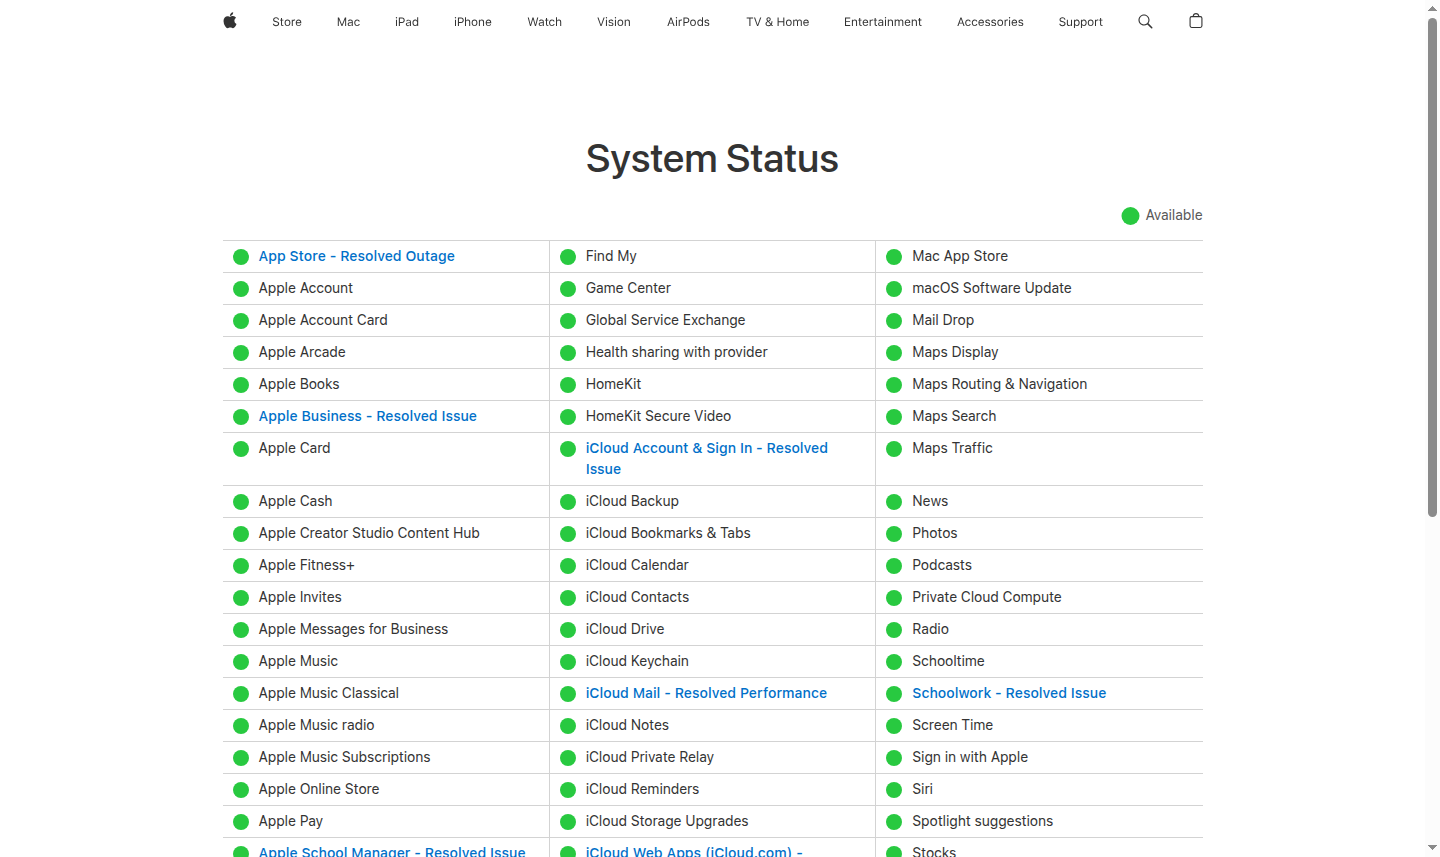 Abbildung: Die an Endkunden gerichtete Systemstatusseite. Die gelisteten Dienste weichen ab; HomeKit wird exklusiv hier geführt. Quelle: Offizielle Statusseite von Apple
Das Dashboard für Endkunden strukturiert die Dienste aus Sicht des alltäglichen Gebrauchs, wodurch beide Dashboards aneinander vorbeireden. Dass die beiden Bestandsaufnahmen nicht deckungsgleich sind, offenbart ein grundlegendes strukturelles Problem: Selbst intern scheint bei Apple keine einheitliche Definition dessen zu existieren, was eigentlich als eigenständiges „System“ gilt. Zwei Nutzergruppen blicken auf zwei voneinander abweichende Berichte, und niemand vermag die wahren Grenzen dieses Ausfalls lückenlos zu rekonstruieren.
Ein einziges Megafon, und der Betreiber hält es in der Hand
Die Struktur dieses Zwischenfalls ist sinnbildlich für unsere moderne IT-Landschaft: Haben erst einmal alle Akteure – Privatpersonen ebenso wie Unternehmen – ihre Arbeitslasten auf eine Handvoll dominanter Cloud-Anbieter verlagert, geht das Deutungsmonopol bei Störungen automatisch an den Betreiber über. Persönliche Fotos und Notizen liegen in der iCloud, unternehmenseigene Build-Pipelines in Xcode Cloud. Je stärker die Konzentration voranschreitet, desto weniger unabhängige Stimmen bleiben übrig. Endnutzer haben keinen Zutritt zu den Rechenzentren, keine Einsicht in Systemprotokolle und keine alternativen Prüfpfade; was der Betreiber formuliert, ist die einzige zugängliche Realität. Die erste Stellungnahme stammte von Apple, und auch das Urteil, einen Angriff auszuschließen, fällte Apple allein. Dass Apple als einzige Partei über die nötigen Daten verfügt, mag unvermeidlich sein; der Preis dafür ist jedoch, dass von Anfang bis Ende nur eine einzige Version der Geschichte existiert.
Fairerweise muss gesagt werden, dass Apples Krisenmanagement im Branchenvergleich solide war: Die wichtigsten Dienste standen binnen weniger Stunden wieder, Angriffe wurden unmissverständlich ausgeschlossen, der Fehler beim internen Update offen eingestanden und die Statusseiten fortlaufend aktualisiert. Es gibt genügend Plattformen, die Störungen totschweigen oder sich auf die Floskel zurückziehen, dass „einige Nutzer Beeinträchtigungen feststellen könnten“. An der asymmetrischen Kommunikationsstruktur ändert das jedoch nichts. Dass Plattformen wie Downdetector bei jedem Vorfall Rekordzugriffe verzeichnen, liegt schlicht daran, dass sie die einzige verbleibende, unabhängige Kontrollinstanz für Nutzer darstellen – ein ziviles Messinstrument abseits offizieller Verlautbarungen.
Hinter diesem Ausfall steckte kein Hackerangriff, sondern lediglich ein internes Update und zwei Statusseiten, die nicht zueinander passten. Wer die Infrastruktur kontrolliert, hält das Megafon. Apple hat dieses Megafon diesmal souverän bedient und bereitwillig Verantwortung übernommen. Doch der Vorfall führte der Branche gleichzeitig vor Augen: Es gibt in diesem Raum von Anfang bis Ende immer nur ein einziges Megafon.
Weiterführende Links:
- Apple Entwickler-Systemstatus (Developer System Status)
- Apple Systemstatus für Endkunden (System Status)
- Bloomberg: Bericht von Mark Gurman
- Downdetector Störungsdaten
- r/Apple_Employees Mitarbeiter-Community