Durante años, el procesamiento de voz operó bajo una premisa tácita: para que una máquina entienda lo que dices, tu voz debe abandonar primero el dispositivo. La señal debía empaquetarse y enviarse a los servidores centralizados de un gigante tecnológico.
Nos acostumbramos a este intercambio durante los últimos años, sacrificando privacidad a cambio de la precisión de los modelos masivos en la nube. Sin embargo, el 2 de octubre de 2026, el equipo de Cactus presentó Whistle, un modelo de reconocimiento de voz de código abierto que derriba por completo ese axioma.
Desarrollado por Jakub Mroz y Henry Ndubuaku, el resultado es un único archivo binario de apenas 16,9 MB. En entornos locales de CPU pura, supera en velocidad al estándar de la industria de 145,3 MB, Whisper base. Con este tamaño ínfimo, Whistle proclama que la conexión obligatoria a internet ha dejado de ser un requisito técnico indispensable para los servicios de voz.
16,9 MB en un reloj inteligente: rompiendo el dogma de la conexión permanente
Durante mucho tiempo, el reconocimiento de voz se comercializó como un servicio pesado dependiente de la nube. Los modelos predominantes ocupan cientos de megabytes y requieren entornos de ejecución complejos. Whistle adopta un camino diametralmente opuesto.
Su enfoque comercial es sumamente explícito: teléfonos móviles, dispositivos portátiles (wearables), robótica, domótica, sistemas de automoción y microcontroladores. Un archivo de 16,9 MB significa que puede integrarse sin dificultad en el chip de un reloj inteligente o en la memoria flash de unos auriculares inalámbricos. El modelo admite audio monoaural a 16 kHz en fragmentos de hasta 30 segundos.
Incorpora soporte nativo para siete idiomas (incluidos español, inglés y alemán) con detección automática del idioma. Todo el procesamiento nuclear se ejecuta en tres etapas puramente locales. La primera es la transcripción directa del habla.
La segunda fase genera marcas de tiempo a nivel de palabra junto con sus puntuaciones de probabilidad. La tercera extrae representaciones vectoriales (embeddings) de características de voz codificadas en tramas de 80 milisegundos. Al procesar el audio de principio a fin en el propio equipo, se elimina de raíz cualquier riesgo de filtración de datos por transmisión remota.
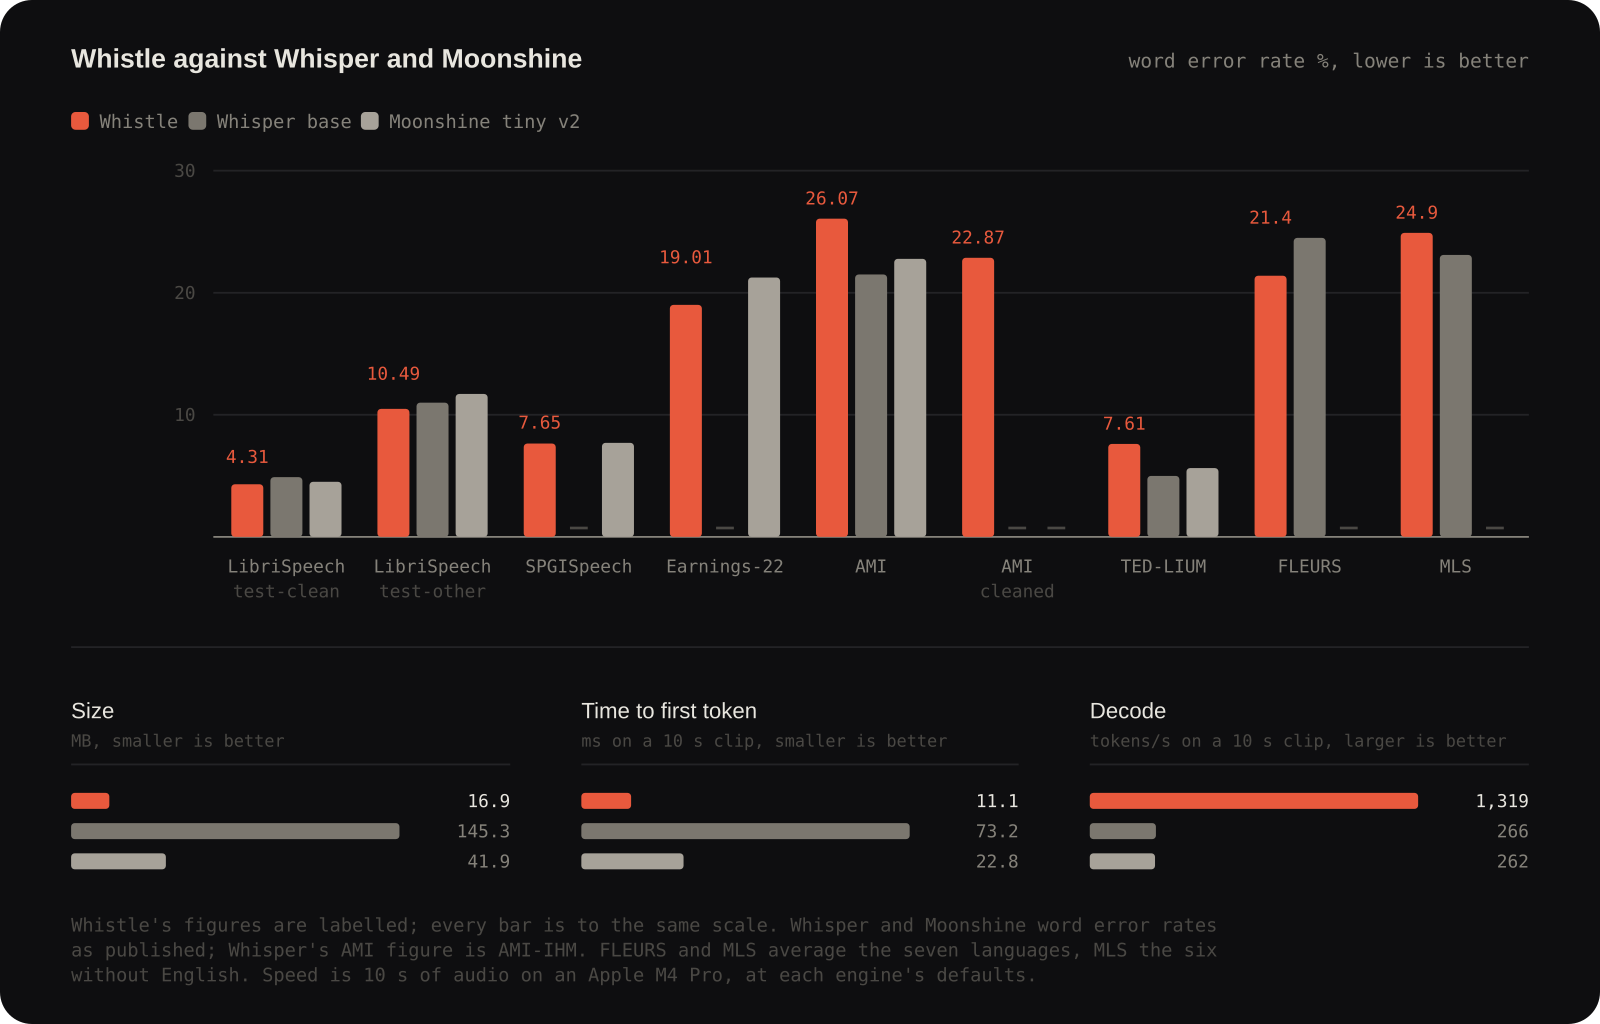 Figura: Comparativa de Whistle frente a Whisper base y Moonshine tiny v2 en tasa de error de palabras (WER), tamaño, latencia al primer token y rendimiento de decodificación. Fuente: Repositorio oficial de Cactus.
11 milisegundos al primer token: superando la latencia del viaje a la nube
Con una brecha de tamaño tan abismal, la velocidad se convierte en el arma definitiva del modelo ligero frente a los gigantes de la nube. Evaluado en un procesador Apple M4 Pro ejecutándose exclusivamente sobre CPU, Whistle alcanzó una latencia al primer token de solo 11,1 milisegundos para un fragmento de audio de 10 segundos.
En comparación, Whisper base arrojó una latencia de 73,2 milisegundos en idénticas condiciones, mientras que otra alternativa ligera, Moonshine tiny v2, necesitó 22,8 milisegundos. Para los sentidos humanos, 11,1 milisegundos representa un intervalo prácticamente imperceptible.
Antes de que el usuario termine de pronunciar la primera mitad de una frase, la pantalla ya muestra la primera palabra transcrita. En rendimiento global de decodificación, Whistle alcanzó la asombrosa cifra de 1.319 tokens por segundo, eclipsando los 266 tokens/s de Whisper base, que es 8,6 veces más voluminoso.
En un entorno local que prescinde por completo de negociaciones de red y pérdidas de paquetes, el modelo compacto recupera la iniciativa en la respuesta interactiva mediante pura eficiencia de cálculo.
Abandonar la obsesión por los benchmarks: basta con ganar en escenarios clave
Con un peso de solo 16,9 MB, resulta inviable ganar en todas las suites de evaluación sintéticas. En la métrica de referencia, la tasa de error de palabras (Word Error Rate, WER), ambos contendientes intercambian golpes. Whistle destaca con solidez en contextos cotidianos y aplicaciones prácticas.
En LibriSpeech, Whistle registró un 4,31 en audio limpio y un 10,49 en entornos ruidosos. Asimismo, tomó la delantera en el ámbito financiero con SPGISpeech (7,65) y en el conjunto multilingüe FLEURS (21,4). Por su parte, Whisper base recuperó terreno en grabaciones de reuniones con AMI (26,07), conferencias en TED-LIUM (7,61) y en el conjunto multilingüe MLS (24,9).
En escenarios de propósito específico que no demandan una generalización universal para todos los acentos del planeta, los modelos compactos para edge computing ya han alcanzado la frontera de la utilidad operativa. En lugar de perseguir un dominio absoluto en las tablas de clasificación académicas, Whistle opta por ser sumamente útil en entornos delimitados: no una panacea universal para cualquier señal sonora, sino un bisturí monopropósito afilado para hardware específico.
Exprimiendo el rendimiento: eliminando cualquier redundancia técnica
Para exprimir al máximo el rendimiento en un espacio tan reducido, la ingeniería debe ser implacable. En vez de reinventar la rueda, el equipo de Cactus reutilizó la arquitectura base de Needle, su modelo de lenguaje textual propio. Para tareas de voz, simplemente añadieron un mecanismo de atención cruzada con compuertas (gated cross-attention) en cada capa del decodificador.
Cuando entran los datos de audio, el modelo proyecta las matrices necesarias en una sola pasada y las reutiliza a lo largo de toda la secuencia de decodificación. Una búsqueda por haz (beam search) paralela de cinco vías consume únicamente cinco búferes de texto cortos, eludiendo por completo la necesidad de recalcular los pesados tensores de audio cinco veces consecutivas.
En los silencios, el módulo de detección de actividad vocal devuelve un resultado vacío al instante, impidiendo que el audio en blanco consuma recursos en la costosa canalización de decodificación. Además, para optimizar la precisión en nombres propios especializados, el motor emplea autómatas finitos clásicos para el sesgo de palabras clave (keyword biasing). El sistema puede elevar artificialmente la probabilidad de acierto de términos infrecuentes sin obligar a la red neuronal a memorizarlos mediante entrenamiento.
Convertir grabaciones de voz en llamadas a herramientas con un solo binario
En el plano del despliegue, Whistle se ofrece precompilado para 17 plataformas de destino: desde sistemas de escritorio como macOS y Linux hasta plataformas móviles como Android e iOS, e incluso entornos WebAssembly (WASI) dentro de navegadores web.
El código del motor de inferencia es sumamente limpio y jamás consulta variables de entorno del sistema durante la ejecución. Todas las directrices de comportamiento se rigen por valores predeterminados fijados en tiempo de compilación o por parámetros explícitos pasados por el llamante. Es más, al compartir el mismo formato de cuantificación de bajo nivel y el motor en C++ con Needle, ambos componentes se integran de forma transparente.
Con el mismo archivo binario, cargar una configuración de texto genera transcripciones convencionales. Cargar un archivo con definiciones de herramientas omite la conversión textual intermedia y traduce la voz directamente en instrucciones ejecutables del sistema.
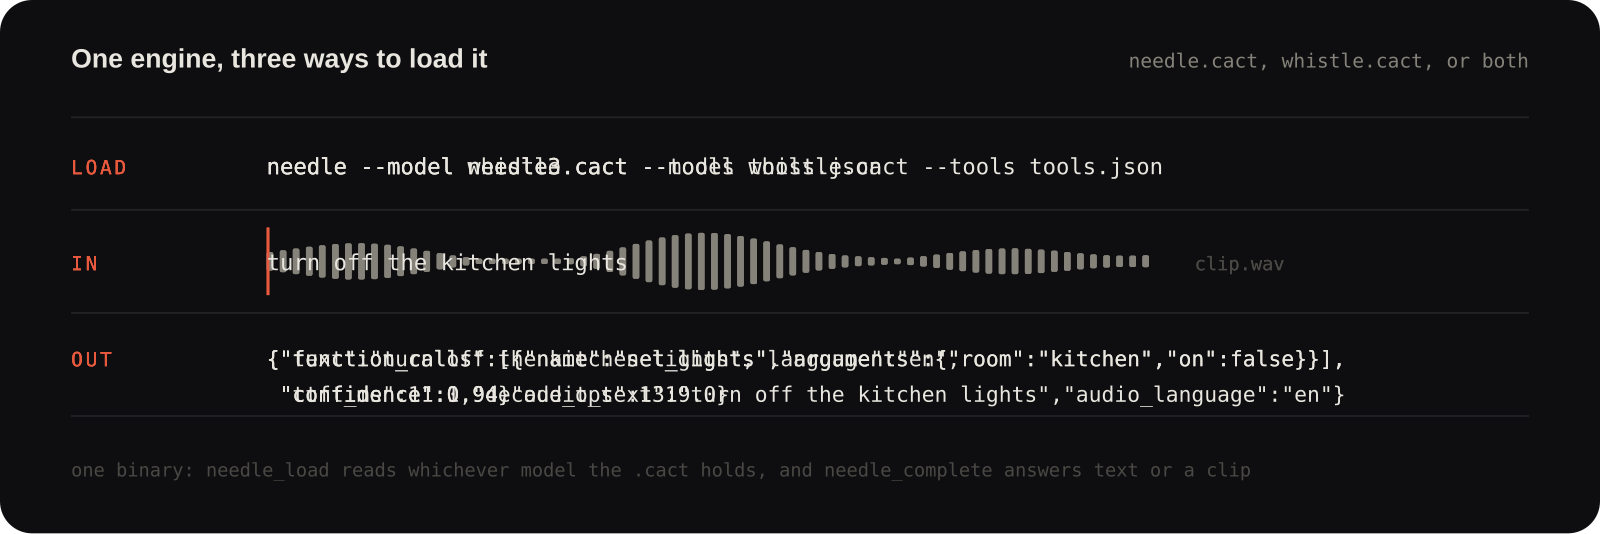 Figura: Arquitectura de despliegue donde un único binario genera distintos resultados en función de la configuración cargada. Fuente: Repositorio oficial de Cactus.
Resolver problemas reales importa más que ganar puntos en benchmarks
La atención de la comunidad técnica no se centró en décimas de diferencia en pruebas sintéticas. En un comentario de Hacker News, un usuario compartió el dilema real de su padre de 84 años, quien padece dificultades en el habla tras sufrir un ictus.
El usuario implementó un sistema de dictado local para su padre. El anciano lograba dictar una página entera de su autobiografía en apenas diez minutos, ahorrándose días de dolorosa escritura manual en el teclado. No obstante, los modelos comerciales convencionales registraban fielmente cada carraspeo, titubeo y corrección sobre la marcha.
Cuando el padre decía «un elefante, no, un mono trepó al árbol», los modelos estándar transcribían cada vacilación palabra por palabra. Lo que el anciano necesitaba de verdad era un motor de dictado especializado, capaz de omitir las rectificaciones automáticas y generar directamente la intención final deseada.
En contextos de dictado extenso, los usuarios no requieren un servicio omnipotente en la nube que aspire a la perfección universal en cualquier dispositivo. Combinar una herramienta local diminuta para la captura instantánea con un modelo económico para la depuración lógica posterior resulta infinitamente más práctico que exigir al usuario que grabe una y otra vez sus pensamientos.
Whistle constituye la confirmación empírica de que, cuando el modelo es lo bastante compacto para residir en un reloj, la computación local recupera su rentabilidad. En vez de competir en la carrera armamentística de cientos de miles de millones de parámetros en la nube, exprime la eficiencia operativa en rincones aislados de la red.
Un reloj antiguo desconectado puede interpretar órdenes habladas en 11 milisegundos. La imposición de enviar la voz a la nube ha perdido definitivamente cualquier justificación técnica.
Enlaces de referencia:
- Publicación oficial y benchmarks de Cactus
- Debate en la comunidad de Hacker News