Pendant des années, les technologies vocales reposaient sur un postulat tacite : pour qu’une machine comprenne la parole humaine, la voix devait impérativement quitter l’appareil. Les données sonores étaient encapsulées puis expédiées vers les fermes de serveurs d’un géant du numérique.
Au fil du temps, ce compromis est devenu une habitude : sacrifier la confidentialité au profit de la précision des modèles massifs hébergés dans le cloud. Mais le 2 octobre 2026, l’équipe de Cactus a mis en ligne Whistle, un modèle vocal open source qui fait voler cet axiome en éclats.
Conçu par Jakub Mroz et Henry Ndubuaku, le projet se matérialise sous la forme d’un fichier binaire autonome d’à peine 16,9 Mo. Exécuté localement sur processeur (CPU), il surpasse en vitesse la référence de l’industrie, Whisper base (145,3 Mo). Par cette empreinte mémoire dérisoire, Whistle démontre avec éclat que la connexion permanente au réseau n’est plus un prérequis incontournable en matière d’ingénierie vocale.
16,9 Mo dans une montre connectée : la fin du dogme de la connexion permanente
Longtemps cantonnée au statut de service cloud lourd et centralisé, la reconnaissance vocale imposait jusqu’ici des centaines de mégaoctets de paramètres et des environnements d’exécution complexes. Whistle prend le contre-pied absolu de cette approche.
Le positionnement technique revendiqué est sans équivoque : téléphones mobiles, objets connectés (wearables), robotique, domotique, systèmes embarqués automobiles et microcontrôleurs. Un fichier de 16,9 Mo peut se loger sans peine dans la puce d’une montre connectée ou dans la mémoire flash d’écouteurs sans fil. Le modèle traite des flux audio mono à 16 kHz par séquences maximales de 30 secondes.
Il intègre d’emblée la prise en charge de sept langues (dont le français, l’anglais et l’allemand) ainsi qu’un module d’identification automatique de la langue. L’intégralité du pipeline s’opère en trois étapes purement locales. La première étape réalise la transcription directe du signal.
La deuxième étape calcule les horodatages au niveau du mot ainsi que les scores de probabilité associés. La troisième étape extrait des représentations vectorielles (embeddings) de caractéristiques vocales, encodées par fenêtres de 80 millisecondes. Les données audio étant intégralement digérées sur l’appareil, tout risque d’interception ou de fuite par transmission réseau est physiquement aboli.
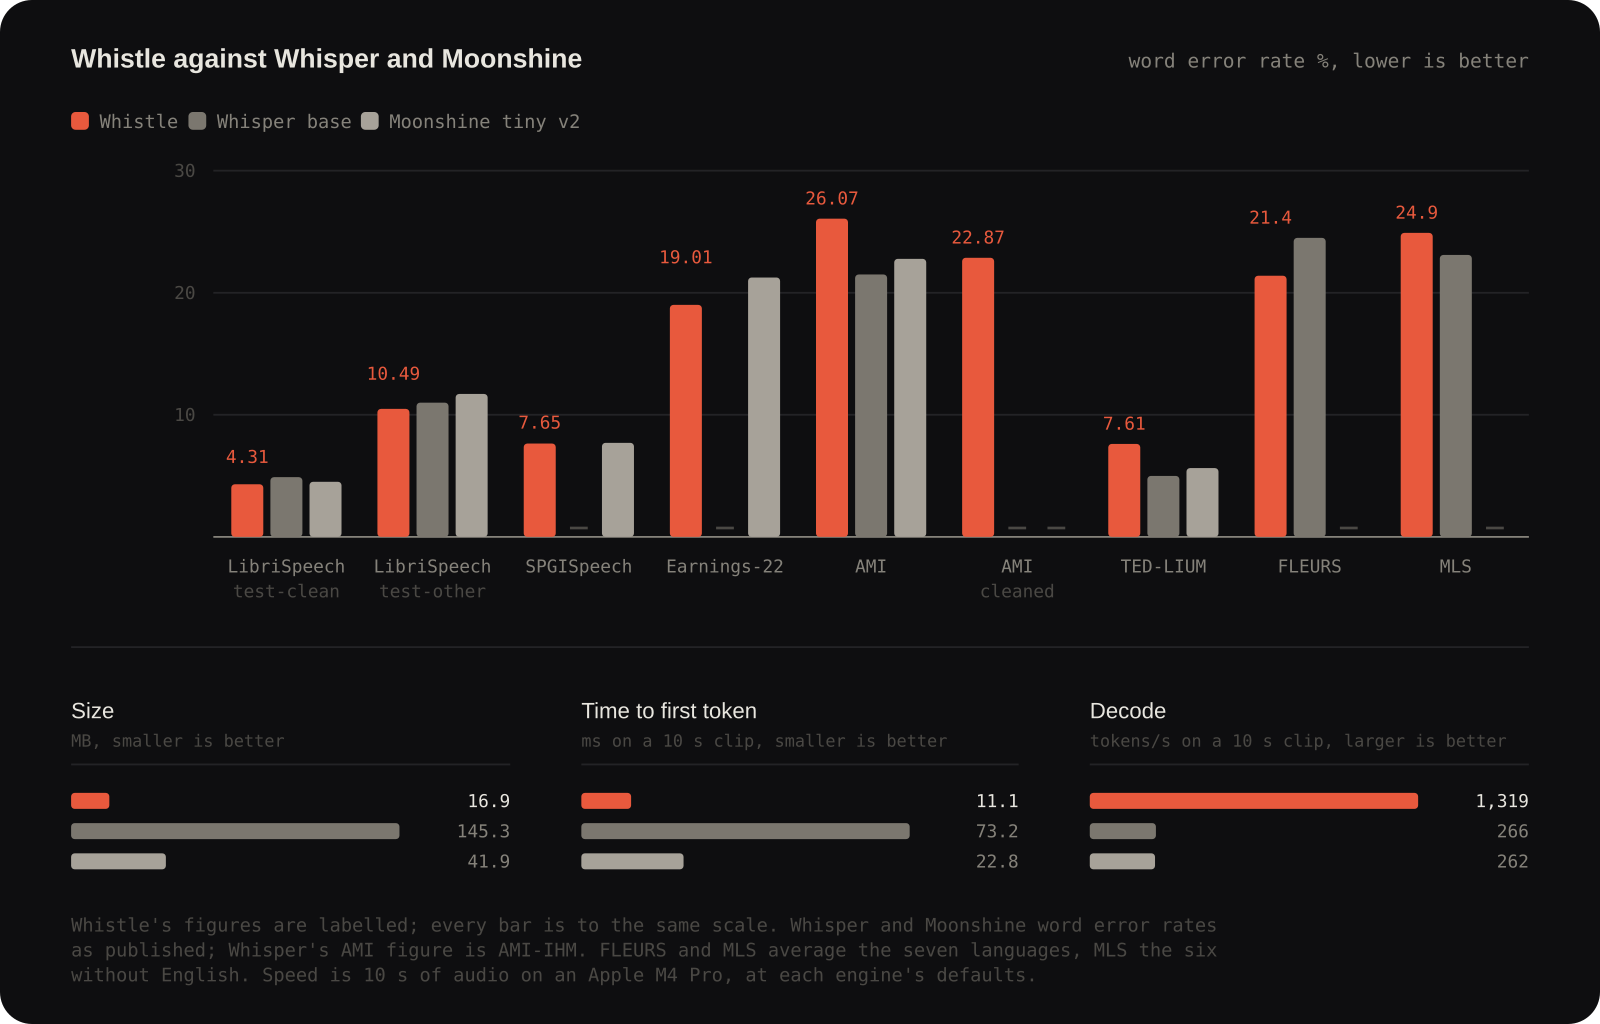 Figure : Comparaison entre Whistle, Whisper base et Moonshine tiny v2 sur le taux d’erreur de mots (WER), la taille, la latence au premier token et le débit de décodage. Source : Dépôt officiel de Cactus.
11 millisecondes au premier token : la vitesse locale surpasse le trajet aller-retour du cloud
Face à un tel écart de volumétrie, la vélocité brute devient l’arme décisive du modèle léger contre les mastodontes du cloud. Évalué sur un processeur Apple M4 Pro en exécution CPU pure sans accélération matérielle, Whistle affiche une latence au premier token de seulement 11,1 millisecondes sur un enregistrement de 10 secondes.
En comparaison, Whisper base requiert 73,2 millisecondes dans les mêmes conditions, tandis qu’un autre modèle léger, Moonshine tiny v2, affiche 22,8 millisecondes. À l’échelle de la perception humaine, 11,1 millisecondes relève de l’instantanéité pure.
Avant même que l’interlocuteur n’ait achevé la première moitié de sa phrase, le premier mot transcrit surgit déjà sur l’écran. Côté débit global de décodage, Whistle atteint le chiffre remarquable de 1 319 tokens par seconde, surclassant largement les 266 tokens/s de Whisper base, pourtant 8,6 fois plus volumineux.
Au sein d’un environnement local affranchi des allers-retours réseau et des paquets perdus, le modèle compact reprend le contrôle de l’interactivité par la seule efficacité de son calcul.
Dépasser l’obsession des benchmarks : triompher sur des cas d’usage ciblés
Avec une taille de 16,9 Mo, aucun modèle ne peut prétendre écraser l’ensemble des jeux de données d’évaluation. Sur le critère capital du taux d’erreur de mots (Word Error Rate, WER), les deux concurrents se rendent coup pour coup. Whistle brille tout particulièrement sur les enregistrements du quotidien et les applications métiers.
Sur le benchmark LibriSpeech, Whistle obtient un score de 4,31 sur les signaux clairs et de 10,49 en milieu bruité. Il prend également la tête sur les enregistrements financiers de SPGISpeech (7,65) ainsi que sur le jeu multilingue FLEURS (21,4). De son côté, Whisper base reprend l’avantage sur les réunions orales d’AMI (26,07), les conférences de TED-LIUM (7,61) et le corpus multilingue MLS (24,9).
Dès lors qu’une application ciblée ne réclame pas une généralisation universelle à tous les accents du globe, les modèles compacts pour l’edge computing ont atteint le seuil d’utilité opérationnelle. Plutôt que de viser un triomphe absolu sur les classements théoriques, Whistle privilégie l’efficacité pratique : non pas une panacée universelle pour tous les flux audio imaginables, mais une lame affûtée pour des équipements spécialisés.
Optimiser chaque cycle : une ingénierie débarrassée de toute redondance
Extraire de telles performances d’une enveloppe aussi restreinte a exigé une rigueur d’ingénierie sans compromis. Loin de réinventer la roue, l’équipe de Cactus a directement réutilisé l’infrastructure sous-jacente de Needle, son modèle textuel maison. Pour le traitement vocal, elle s’est contentée d’incorporer un mécanisme d’attention croisée à portes (gated cross-attention) dans chaque couche du décodeur.
Dès l’arrivée du signal audio, le modèle projette les matrices requises en une seule passe et les réutilise tout au long du processus de décodage. Une recherche par faisceau (beam search) parallèle sur cinq voies ne mobilise que cinq mémoires tampons textuelles très compactes, évitant de recalculer cinq fois d’affilée les lourds tenseurs acoustiques.
Sur les segments silencieux, le module de détection d’activité vocale renvoie immédiatement un résultat vide, épargnant ainsi au moteur tout calcul superflu dans le pipeline de décodage. Pour accroître la reconnaissance des noms propres métiers, le moteur intègre des automates finis classiques dédiés au biaisage de mots-clés (keyword biasing). Les développeurs peuvent ainsi rehausser artificiellement la probabilité d’entités rares sans contraindre le réseau neuronal à un coûteux apprentissage par cœur.
Transformer l’audio en appels d’outils au sein d’un binaire unique
Sur le plan du déploiement, Whistle est précompilé pour 17 plateformes cibles : des postes de travail sous macOS et Linux aux systèmes mobiles Android et iOS, jusqu’aux modules WebAssembly (WASI) directement exécutables dans le navigateur.
Le code du moteur d’inférence est remarquablement épuré : il s’abstient rigoureusement de lire la moindre variable d’environnement au cours de son exécution. Tous les paramètres opérationnels proviennent de valeurs figées à la compilation ou d’arguments passés explicitement par l’appelant. Mieux encore : partageant le format de quantification bas niveau et le moteur C++ de Needle, les deux composants s’associent sans la moindre friction.
Avec un binaire unique, le chargement d’un fichier de configuration textuelle produit des transcriptions classiques. L’injection d’une configuration outillée (tool-calling) permet en revanche de court-circuiter l’étape du texte pour convertir directement la parole en instructions système immédiatement exécutables.
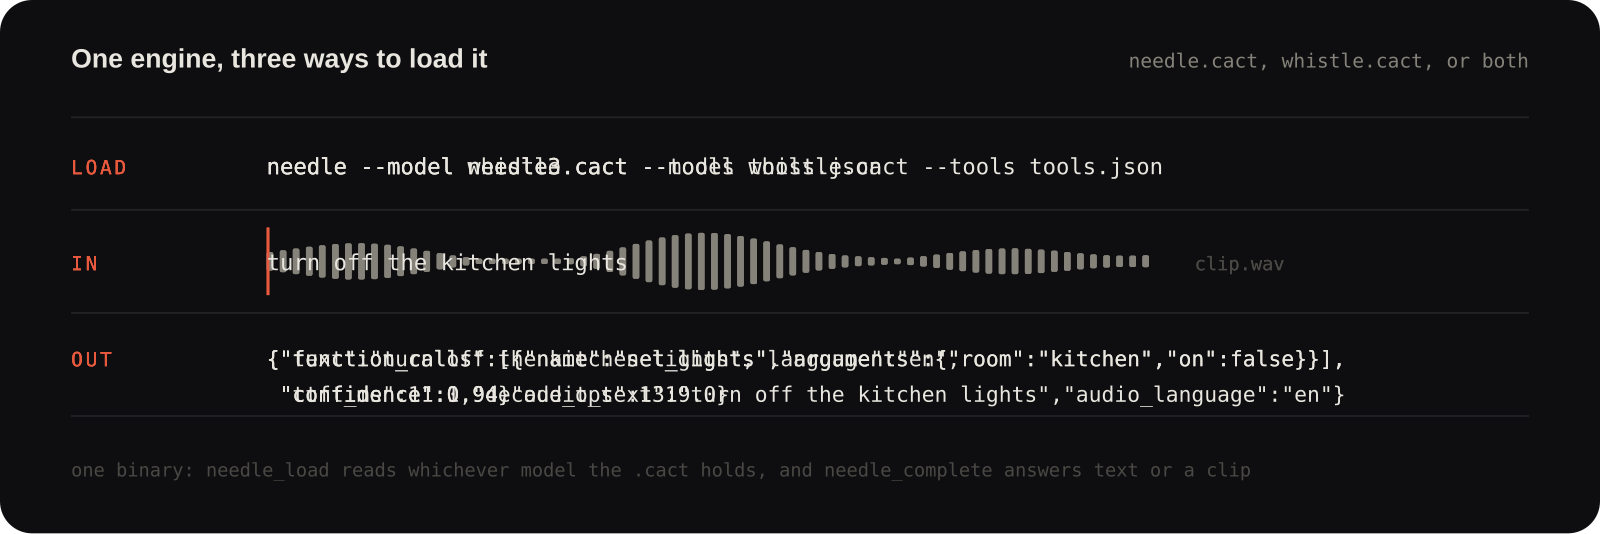 Figure : Architecture de déploiement où un même binaire génère différents résultats selon la configuration chargée. Source : Dépôt officiel de Cactus.
Résoudre des problèmes concrets plutôt que courir après les benchmarks
L’attention des développeurs ne s’est pas arrêtée aux écarts de virgule sur les bancs d’essai. Dans un commentaire très remarqué sur Hacker News, un utilisateur a partagé la situation bien réelle de son père de 84 ans, dont l’élocution est devenue confuse à la suite d’un accident vasculaire cérébral.
L’utilisateur avait conçu pour lui un environnement de dictée locale. L’octogénaire parvenait ainsi à dicter une page entière de ses mémoires en dix minutes, lui évitant des journées d’efforts laborieux au clavier. Cependant, les modèles vocaux généralistes transcrivaient servilement chaque hésitation, chaque raclement de gorge et chaque reprise de phrase.
Lorsque le père prononçait « un éléphant non un singe a grimpé sur l’arbre », les modèles conventionnels conservaient chaque mot sans discernement. Ce dont son père avait véritablement besoin, c’était d’un moteur de dictée spécialisé, capable d’ignorer spontanément les corrections à la volée pour ne restituer que le propos final.
Dans le cadre d’une dictée au long cours, les utilisateurs ne recherchent pas un service omnipotent dans le cloud cherchant la perfection abstraite sur tous les matériels. Exploiter un outil local ultra-léger pour capturer immédiatement la parole, complété par un modèle économique pour le nettoyage logique, s’avère infiniment plus ergonomique que de contraindre un utilisateur à répéter inlassablement ses phrases.
Whistle apporte la démonstration qu’une fois compressé au point de tenir dans une montre, le traitement local redevient pleinement compétitif. Au lieu de participer à la course aux armements de centaines de milliards de paramètres dans le cloud, il pousse l’efficience à son paroxysme dans les environnements déconnectés.
Lorsqu’une vieille montre hors ligne est capable de comprendre des ordres vocaux en 11 millisecondes, l’obligation d’acheminer la voix vers le cloud perd toute justification technique.
Liens de référence :
- Publication officielle et benchmarks de Cactus
- Discussion sur la communauté Hacker News