全世界一直有一个不公开的默认前提。要让机器听懂你说的话,你的声音必须先离开这台设备。它会被打包发送到某家巨头公司的服务器上。
我们在过去几年里习惯了这笔交易,用隐私去换取云端大模型的准确率。但 2026 年 10 月 2 日,Cactus 团队发布了一个名为 Whistle 的语音模型。它把这个前提拆掉了。
作者 Jakub Mroz 和 Henry Ndubuaku 拿出的成果,是一个大小仅 16.9MB 的单文件。它在本地环境跑出了比 145.3MB 的行业标杆 Whisper base 还要快的速度。它用极小的体积宣告,语音服务强制要求网络连接在工程上已经不再是必选项。
16.9MB 塞进手表,打破联网执念
长期以来,语音识别被包装成一种沉重的云端服务。主流模型的体积动辄上百兆,跑起来还需要复杂的依赖环境。Whistle 走了一条相反的路线。
官方给它的产品定位非常明确:手机、可穿戴设备、机器人、智能家居、车载系统以及微控制器。一个 16.9MB 的文件,意味着它能被轻松塞进一块智能手表的芯片里,或者一副耳机的闪存中。模型支持处理 16 kHz 单声道音频,一次最多处理 30 秒。
它内置英语、德语等七种语言且支持自动检测。所有的核心工作全部在本地的三步内完成。第一步是语音转写。
第二步是输出词级别的时间戳及概率。第三步是提取每 80 毫秒一帧的语音特征输出编码。声音数据消化在了本地,物理上断绝了上传泄露的可能。
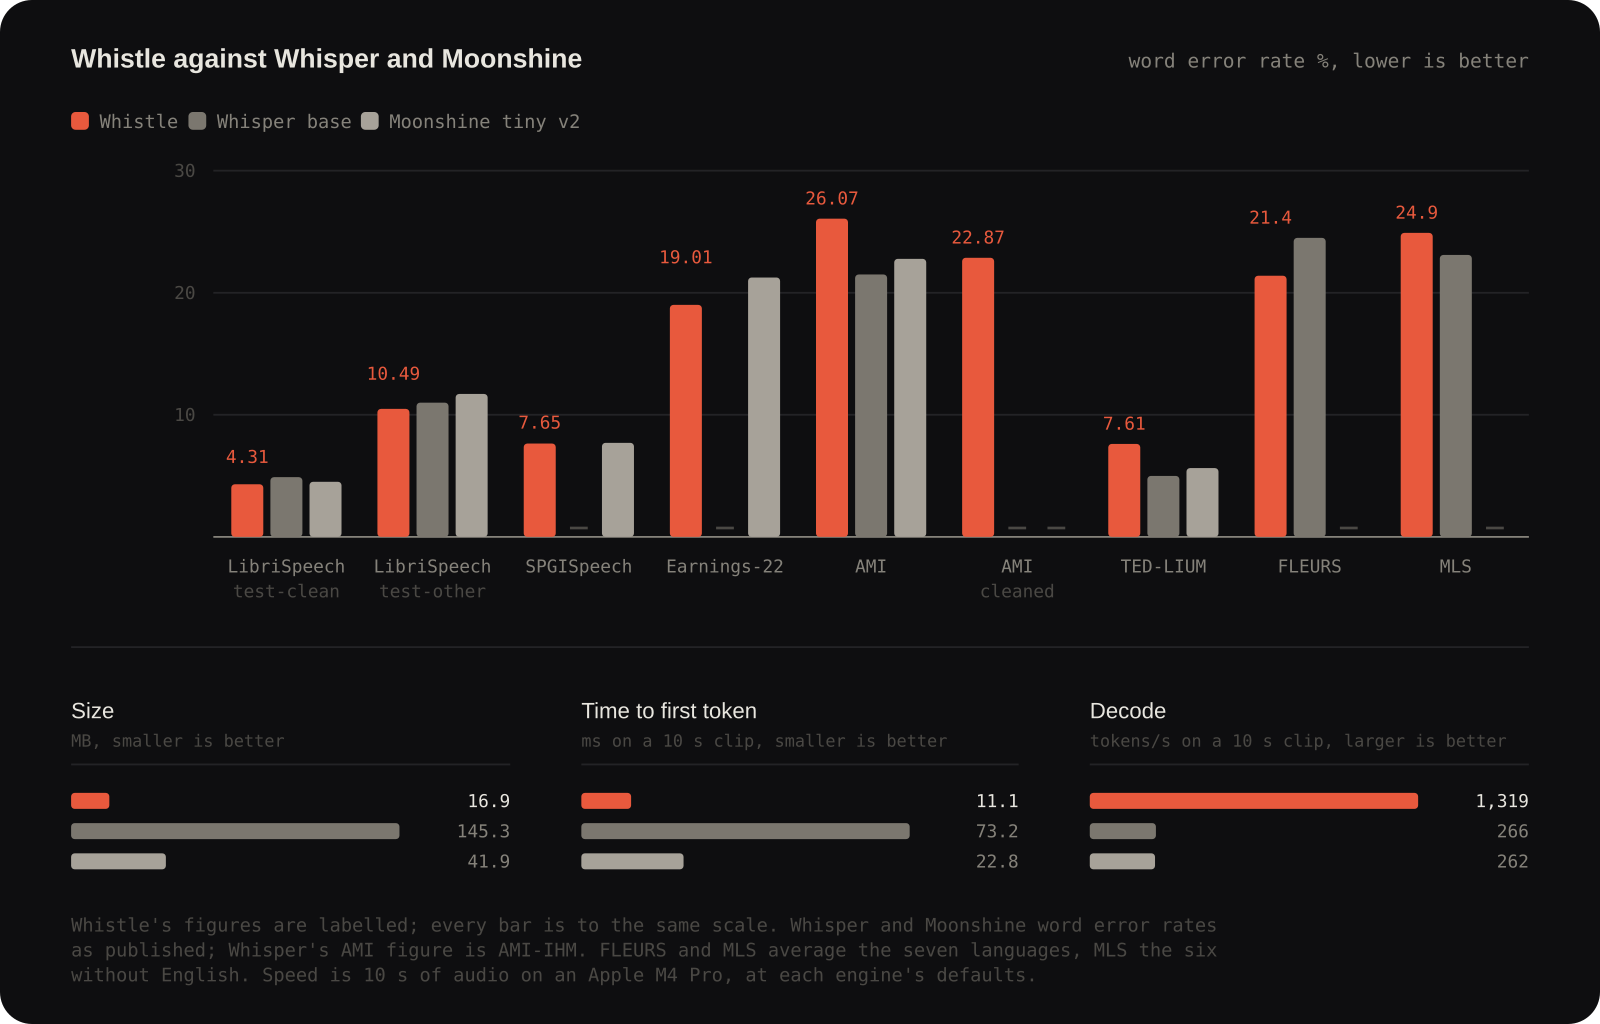 图:Whistle 与 Whisper base、Moonshine tiny v2 在词错误率、体积、首字延迟和解码速度上的对比。来源:Cactus 官方仓库
11毫秒首字延迟压过云端返回速度
在体积相差巨大的情况下,速度成了小模型反击云端巨无霸的最佳武器。开发团队在 Apple M4 Pro 处理器下,用一段 10 秒的音频进行了测试。结果显示,在纯 CPU 裸跑状态下,Whistle 的首字延迟仅为 11.1 毫秒。
作为对比,同台竞技的 Whisper base 首字延迟高达 73.2 毫秒。另一款轻量模型 Moonshine tiny v2 也需要 22.8 毫秒。11.1 毫秒在感官上是一个极短的时间跨度。
你还没说完上半句,屏幕上就已经吐出了第一个字。在整体解码速度上,Whistle 达到了每秒 1319 个 token 的惊人成绩。而体积比它大 8.6 倍的 Whisper base 只有每秒 266 个。
在不需要考虑网络连接和传输损耗的纯本地环境,小模型用最直接的计算速度抢回了交互响应的主导权。
放下榜单执念,特定场景能赢就够了
当模型只有 16.9MB 时,它注定无法在所有的测试集上取得全胜。在衡量准确率的核心指标词错误率上,两方互有胜负。Whistle 在日常场景表现出色。
它在 LibriSpeech 测试集的干净环境拿到 4.31,复杂环境拿到 10.49。同时在金融领域的 SPGISpeech(7.65)以及多语言集 FLEURS(21.4)上也处于领先。而 Whisper base 则在会议录音 AMI(26.07)、TED-LIUM(7.61)和多语种集 MLS(24.9)上扳回一城。
在无需多语言泛化支持全宇宙口音的单任务场景中,小模型已经摸到了前沿的门槛。它不追求在排行榜上呈现全面压倒的优势,而是选择在具体领域做到好用。不去给所有人做通用的解药,只做特定设备上最锋利的单用途刀片。
抠出每一滴性能,工程上舍弃一切冗余
要在受限体积内榨出性能,工程上必须斤斤计较。Cactus 团队没有重造轮子,而是直接复用了同厂文本模型 Needle 的底层代码。针对语音任务,他们仅在每一个解码器层里额外加入了一个带门控的交叉注意力机制。
当音频数据到达时,模型会一次性投影好所需矩阵并在整个处理中复用。五路并行的查找路径只需消耗五份极短的文本缓存。它不用把沉重的音频文件翻来覆去计算五遍。
对于静音片段,检测模块会直接返回空结果,根本不让这部分数据进入耗时的流程。为了提升特定专有名词的识别率,他们采用传统自动机算法来做关键词纠偏。系统可以人为提高冷僻名字的命中概率,而不用强迫整个神经网络去死记硬背。
用一个文件把录音直接变成工具调用
在部署层面上,它被预编译到了多达 17 个目标平台。从桌面端的 macOS、Linux,到移动端的 Android、iOS。它甚至支持浏览器和 WASI 组件。
引擎代码极为干净,运行期间绝对不读取任何系统环境变量。所有行为规范要么是编译定死的默认值,要么是用户手动敲入的开关参数。更巧的是,它和 Needle 引擎共用同一套底层量化,它们可以无缝衔接。
同一个二进制文件,加载文本配置能直接输出文字。如果换上一套包含工具配置的文件,它能越过文字这一步,直接把一段语音转化成系统操作指令。
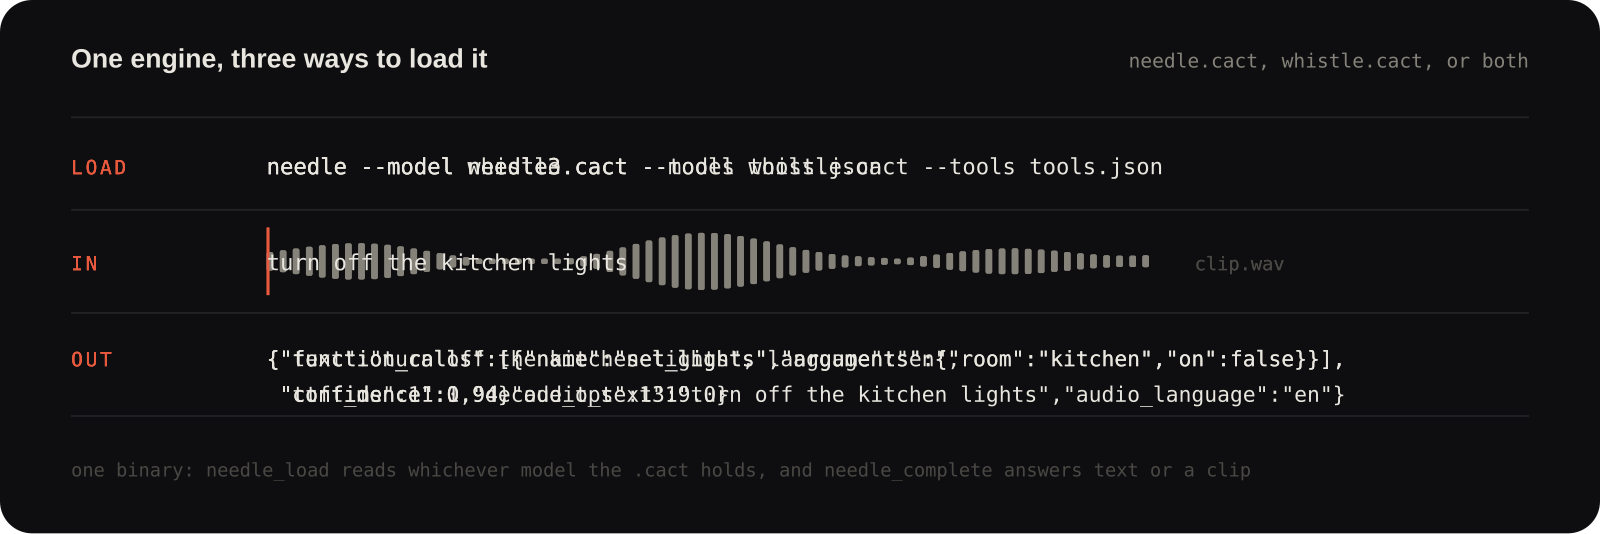 图:同一个二进制加载不同配置出不同结果的部署示意图。来源:Cactus 官方仓库
解决具体难题比跑分更重要
技术社区关注的焦点并没有停留在基准测试的分数之差。在 Hacker News 的一条评论里,一位用户分享了他 84 岁父亲的真实困境。老人由于中风,说话含混不清,常人很难立刻听懂发音。
这位用户为父亲搭建了本地语音输入系统。老人花十分钟就能口述一页纸,省下了好几天的敲字时间。但通用语音模型会把每一个停顿的杂音和纠正词忠实地记录下来。
当老人说「一头大象不对是一只猴子爬上了树」时,通用模型会一字不落地保留。真正能帮到他父亲的,是一个专门的口述引擎。它能自动忽略纠正词汇,直接输出猴子爬树的最终结果。
在长文口述的场合,人们需要的不再是一个试图在所有设备上表现完美的通用服务。用极小的本地工具做快速初步记录,再用廉价模型做逻辑清理。这种方式远比反复让用户重新录音要顺手得多。
这是本批次唯一一条证明模型体积小到可以塞进手表的新闻。它也是本地化重新变得划算的明确信号。它不用去云端卷千亿参数的规模,而是在断网的角落里把具体场景的效率推到了极限。
一块不联网的旧手表也能在 11 毫秒内听懂口语指令。强制联网的语音服务已经失去了技术上的必然性。
参考链接:
- Cactus 官方发布与基准测试
- Hacker News 社区讨论