输入 1 美元,缓存读取仅需 0.05 美元每百万 token,而此时调用者手里捏着的是支持 1M 上下文和 600B 总参数的底层模型。阶跃星辰的 Step 5 Preview 在 2026 年 10 月 8 日上线 API 并宣布即将释出开源权重,把模型性能的讨论强行拉回了工程成本核算上。当参数总量被稀疏架构降权,激活参数加上缓存命中率开始成为新的度量衡。Step 5 亮出了底牌:开源模型的低成本不再只是性能落后的掩护,而是通过特定架构设计实现的硬指标。它在单次代码任务中具备惊人的爆发力,但在长程多步执行中依然暴露出技术短板。成本前沿被推开了,长程执行还没有。
600B 巨型底座只给 27B 激活参数
Step 5 Preview 的核心工程杠杆建立在其庞大的稀疏 MoE 架构之上。总参数量高达 600B 的巨型底座负责存储广阔的世界知识,但在每次推理处理单个 token 时,模型仅激活其中一条 27B 的计算路径。这把大模型参数军备竞赛的重心直接从堆砌总规模切向了压榨激活比。低至 4.5% 的激活参数比例换来的是显而易见的速度红利与算力节省。
OpenRouter 的三日统计数据显示,Step 5 的吞吐量 P50 达到 81 tok/s,在长窗口内的均值最高可达 P99 163 tok/s。1M token 的超长上下文窗口需要粗暴的生成速度来填满,这 27B 激活参数就是在为高并发的读写吞吐让路。不仅如此,Step 5 原生支持了文本、图像以及视频等多模态输入,最长支持输出 64K token。官方发布的散点图清晰地标示出,Step 5 在获取特定跑分时消耗的算力远低于同档次竞品。
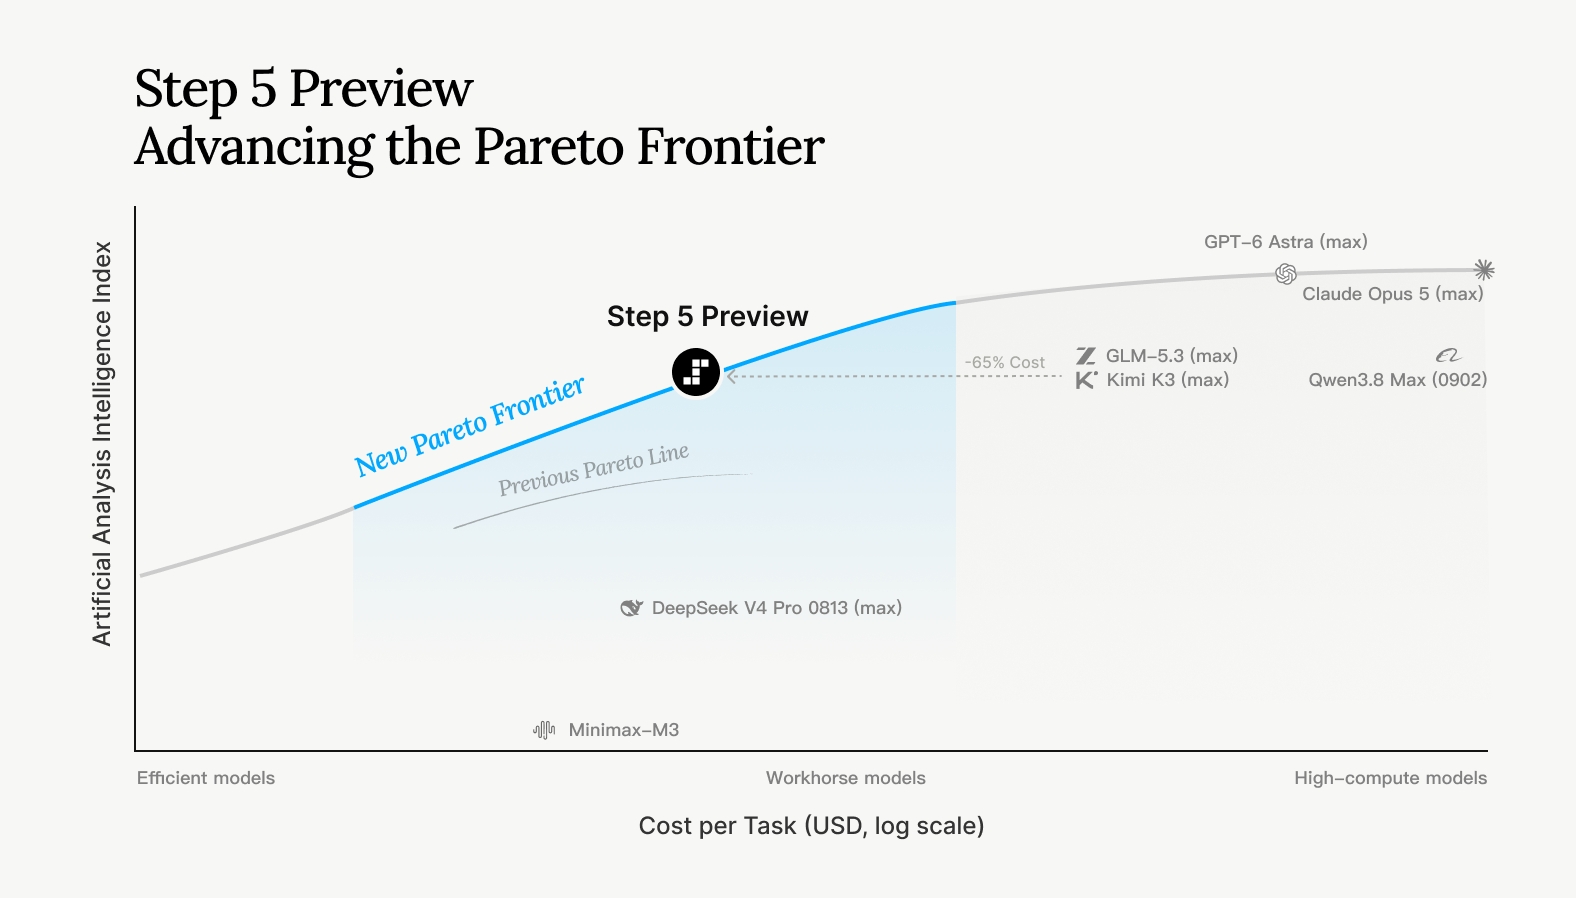 图:官方发布的「智能水平 vs 每任务成本」散点图,展示 Step 5 在同等智能下的成本位置。来源:阶跃星辰官方发布页
这 600B 的巨物生来就不是为了让个人在本地离线运行的。Hacker News 上有用户尖锐地指出,这种体量的静态权重根本跑不进个人工作站常见的 128GB 统一内存。它必须依托云端的大规模集群,依靠高度稀疏化来摊薄服务侧的硬件开销,这本身就是针对云原生 API 定制的底层方案。
95.1% 缓存命中率击穿账面单价
在 OpenRouter 的官方列表上,Step 5 的标定价格为输入 1 美元、输出 2.70 美元每百万 token。单看这两组数字,它在当下激烈的 API 价格战中只能算中规中矩。但它真正的杀伤力在于高达 95.1% 的缓存命中率,这让其缓存读取的单价暴跌至 0.05 美元。抛开缓存机制去谈 1M 上下文的 API 定价没有意义,高频次复用的系统提示词与长文档背景,会把实际的调用账单直接打碎。
根据 OpenRouter 平台的三日统计监控,在缓存机制的加持下,实际加权平均后的输入价格仅为 0.0966 美元每百万 token。只要 prompt 在服务器端驻留的时间够长,调用者实际上拿到的是前沿多模态模型的推理能力和百亿参数级别小模型的白菜价。阶跃星辰官方明确将其定位为面向 agentic work 的旗舰模型,并在演示案例中展示了它从卧室照片直接生成可编辑 3D 空间的「Room Planner」能力。
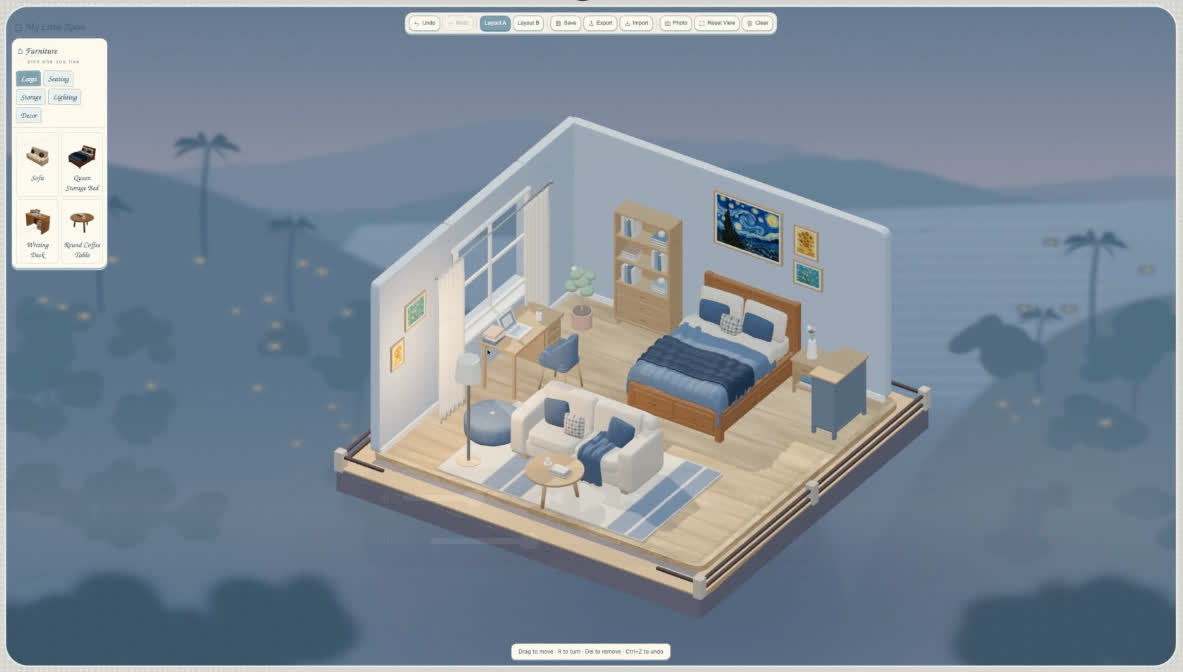 图:官方演示案例「Room Planner」:从一张卧室照片生成可编辑 3D 空间。来源:阶跃星辰官方发布页
在这种需要反复输入图像状态并微调生成结果的工作流中,长下文缓存是维持系统响应速度并压制成本的唯一解法。这种计费维度的错位让一分钱一分货的传统逻辑在缓存面前不再绝对。高缓存命中率强行补偿了大型模型在输入处理阶段的算力消耗,使得模型厂商能够以极低的边际成本对外提供服务。这给了官方在 10 月 15 日直接释出开源权重的底气。
DeepSWE 压过竞品,单点爆发力触及前沿
在代码生成与静态漏洞修复能力上,Step 5 展现出了极强的单点爆发力。在 DeepSWE v1.1 评测基准中,它拿下了 67.7 分,微弱压过同属开放权重阵营的 Kimi K3 Max 的 67.5 分和 GLM-5.3 Max 的 66.9 分。在阶跃星辰自建的 StepCodeBench 榜单中,它更是以 49.0 分大幅领先于 Kimi 的 43.9 和 GLM 的 40.2。
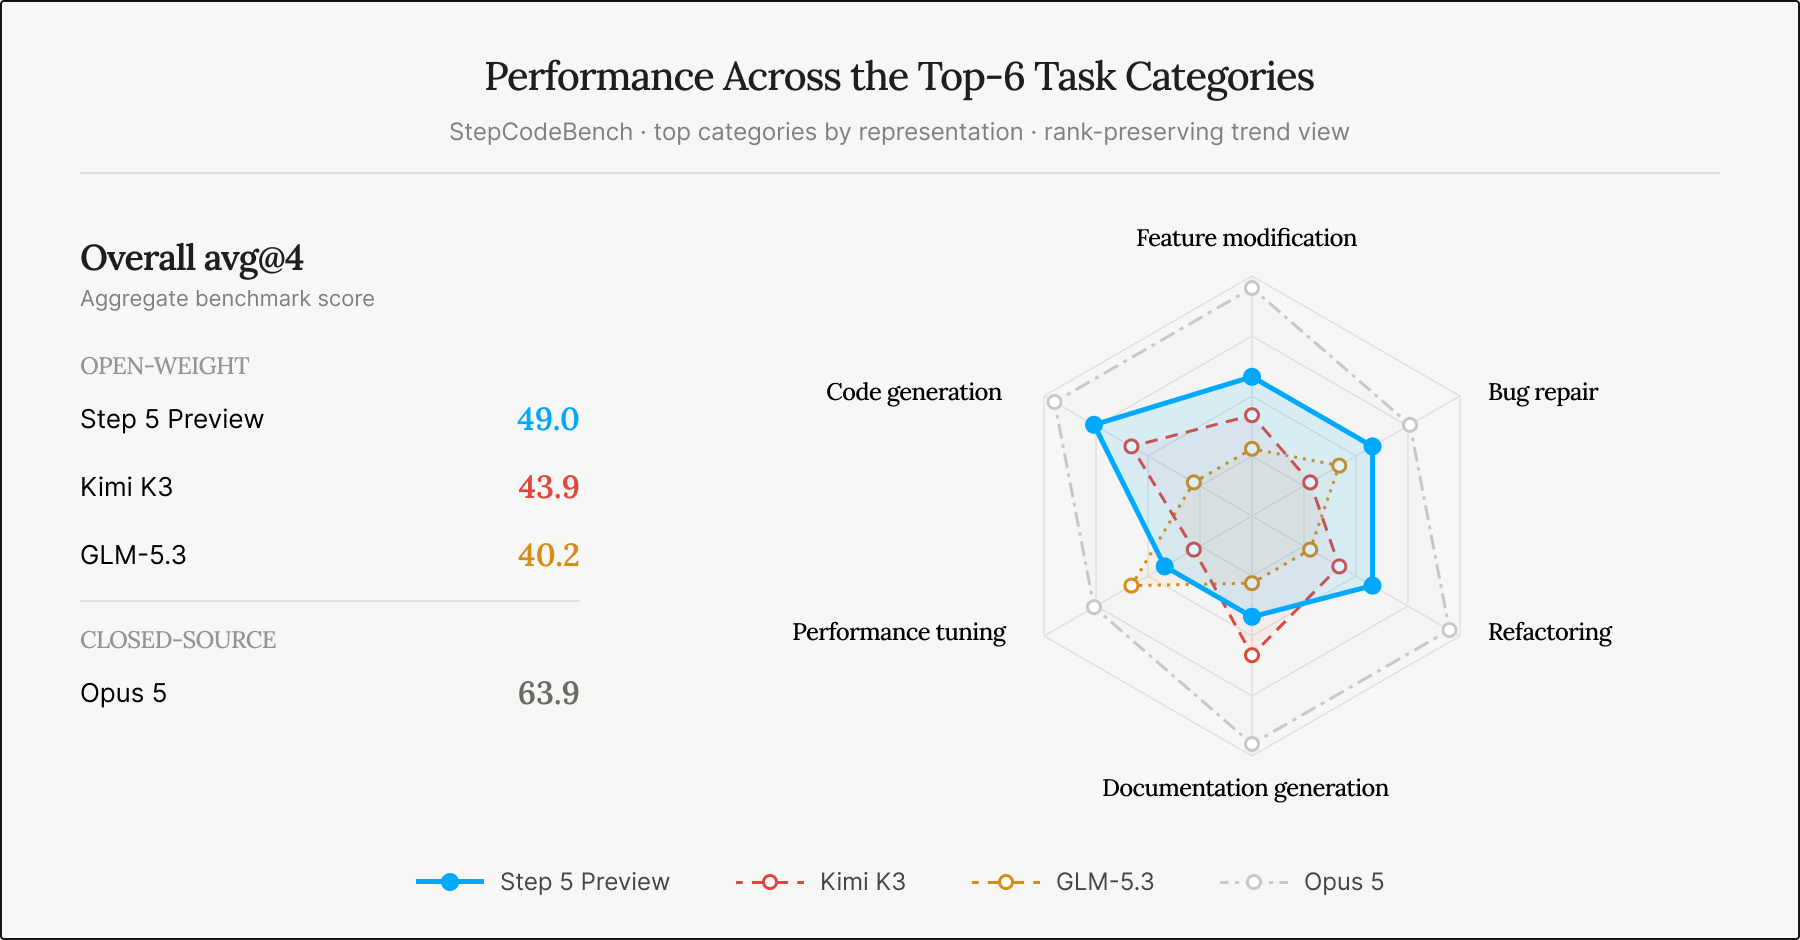 图:官方 StepCodeBench 六类任务的雷达对比图。来源:阶跃星辰官方发布页
开源模型在静态的代码补全和错误修复任务上,已经形成了对前沿闭源模型 GPT-6 Astra 的 74.1 分的稳定追赶态势。阶跃星辰为了证明这个成绩的含金量,特别指出 StepCodeBench 覆盖了 553 个独立仓库、9 类任务以及 33 种编程语言。在 ProgramBench 和 FrontierFinance 这两项专业属性突出的基准测试中,Step 5 分别斩获 80.5 和 66.4 的高分,稳居开源阵营第一,在特定金融单项上逼近了 Claude Opus 5。
官方声称,在他们组织的内外部专家评测中,约有 70% 的参与者认为该模型有能力自主完成中高复杂度的编程任务。这些静态数据勾勒出了一个在单一专业领域极具穿透力的工具模型画像。
3.47 秒延迟拖累 Terminal-Bench 多步执行
局部的静态跑分胜利并不能掩盖 Step 5 在动态长程任务中的疲软。在考察复杂多步环境交互的 Terminal-Bench v4 评测中,Step 5 仅仅拿到 33.3 分,远低于 GLM-5.3 的 41.9 分,距离 GPT-6 Astra 的 57.9 更是相差甚远。长程 Agent 任务不只需要单次生成的代码片段正确。它更需要在数十次甚至上百次的系统文件读取和工具调用中,保持上下文状态不崩盘。
OpenRouter 的监控数据部分解释了这种终端任务断层的原因:其端到端 P50 延迟高达 13.05s,而结构化输出错误率更是达到了 15.15%。在动辄需要连环调用十几个终端命令的测试环境中,单次 3.47 秒的 P50 首字延迟会被无情地堆叠放大。Hacker News 社区中有评论指出:长程 agent 场景下,哪怕只有 1.5 秒以上的单步延迟,都会迅速吃掉吞吐速度带来的所有红利。
高达 15.15% 的结构化错误率对于工具调用来说是个大麻烦。虽然它的基础工具调用错误率只有 1.81%,但结构化输出的偏差会导致生成 JSON 或终端指令时出现微小的语法漂移,这足以让整个 Agent 工作流在中途报错。Step 5 能够轻易看懂大段代码并给出精准补丁,一旦要求它自己去终端环境里多步验证,偏高的延迟和结构化错误就会成为系统卡点。
综合指数不占优,工程选型只看长板
面对这种两极分化的测试表现,海外开发者社区的评价出现了明显撕裂。Hacker News 上有用户贴出 Artificial Analysis 的榜单,指出 Step 5 综合指数仅为 44,认为它沿所有维度看都不算拔尖。但立刻有开发者反驳,指出综合指数表格通常只对模型厂商的市场宣传有用,对于实际构建工程架构的人来说,模型关键看长板够不够长。
从 Step 3.5 到 3.7 时代,阶跃星辰一直在打磨工具调用与子 agent 的编排能力。社区用户指出,Step 5 并非要在通用闲聊评测上刷榜,它是为一个明确的工程流定制的:作为个人助理集群中负责特定任务的底层节点。它擅长吃进大量背景代码,在短时间内吐出单一任务的解决方案。
Step 5 用稀疏化和 95% 的缓存命中率,把开源模型的成本优势变成了核心的设计目标,而不是性能妥协的借口。它最大的工程价值,是将 1M 上下文和高质量专业代码生成的账单强行压缩到了极低的区间。虽然它在 Terminal-Bench 这类长程多步执行上的短板依然刺眼,但对于懂得利用外部工程框架来规避延迟陷阱的开发者来说,这个底座的性价比已经足够诱人。
参考链接:
- Step 5 Preview 官方发布页
- OpenRouter 模型主页
- Hacker News 社区讨论