Ein Dollar für eine Million Eingabe-Token, aber nur 0,05 Dollar für Cache-Lesezugriffe – und das bei einem Basismodell mit einem Kontextfenster von 1M Token und 600 Milliarden Parametern. Am 8. Oktober 2026 veröffentlichte StepFun die API für Step 5 Preview und kündigte die baldige Freigabe der Open-Source-Gewichte an. Damit verlagerte das Unternehmen die Debatte um Modellfähigkeiten mit Nachdruck zurück auf System-Engineering und Grenzkostenkalkulation. Wenn spärlich besetzte (Sparse) Architekturen das Gesamtwachstum der Parameter von den tatsächlichen Rechenkosten entkoppeln, werden die Quote aktiver Parameter und die Cache-Trefferquote zum eigentlichen Gradmesser. Step 5 legt die Karten offen auf den Tisch: Niedrige Betriebskosten bei offenen Modellen sind keine Ausrede mehr für mangelnde Leistung, sondern ein gezieltes Resultat architektonischer Optimierung. Während das Modell bei isolierten Programmieraufgaben verblüffende Spitzenleistungen erzielt, treten bei komplexen, mehrstufigen Agenten-Workflows deutliche Schwächen zutage. Die Kostengrenze wurde verschoben, die autonome Langzeitausführung hinkt jedoch hinterher.
600B-Basisarchitektur mit lediglich 27B aktiven Parametern
Der wesentliche Hebel von Step 5 Preview liegt in seiner riesigen, spärlichen MoE-Architektur (Mixture of Experts). Die monumentale Basis von 600 Milliarden Parametern dient der Speicherung umfassenden Weltwissens, doch bei der Inferenz aktiviert das Modell pro verarbeitetem Token lediglich einen Pfad von 27 Milliarden Parametern. Damit verlagert sich der Schwerpunkt im Parameter-Wettrüsten vom reinen Größenwachstum auf die Maximierung der Aktivierungsquote. Der geringe Anteil von nur 4,5 % an aktiven Parametern bringt erhebliche Durchsatzgewinne und spürbare Einsparungen bei der Rechenleistung mit sich.
Dreitagesdaten von OpenRouter zeigen für Step 5 einen medianen Durchsatz (P50) von 81 Token/s, der im P99-Bereich bei langen Kontextfenstern auf bis zu 163 Token/s klettert. Ein gigantisches Fenster von 1M Token erfordert rohe Generierungsgeschwindigkeit, um sinnvoll gefüllt zu werden; die 27B aktiven Parameter wurden exakt dafür optimiert, parallele Lese- und Schreibdurchsätze zu maximieren. Darüber hinaus verarbeitet Step 5 multimodale Eingaben aus Text, Bild und Video nativ und unterstützt Ausgaben von bis zu 64K Token. Das offizielle Streudiagramm verdeutlicht, dass Step 5 für vergleichbare Benchmark-Ergebnisse weitaus weniger Rechenaufwand benötigt als konkurrierende Modelle.
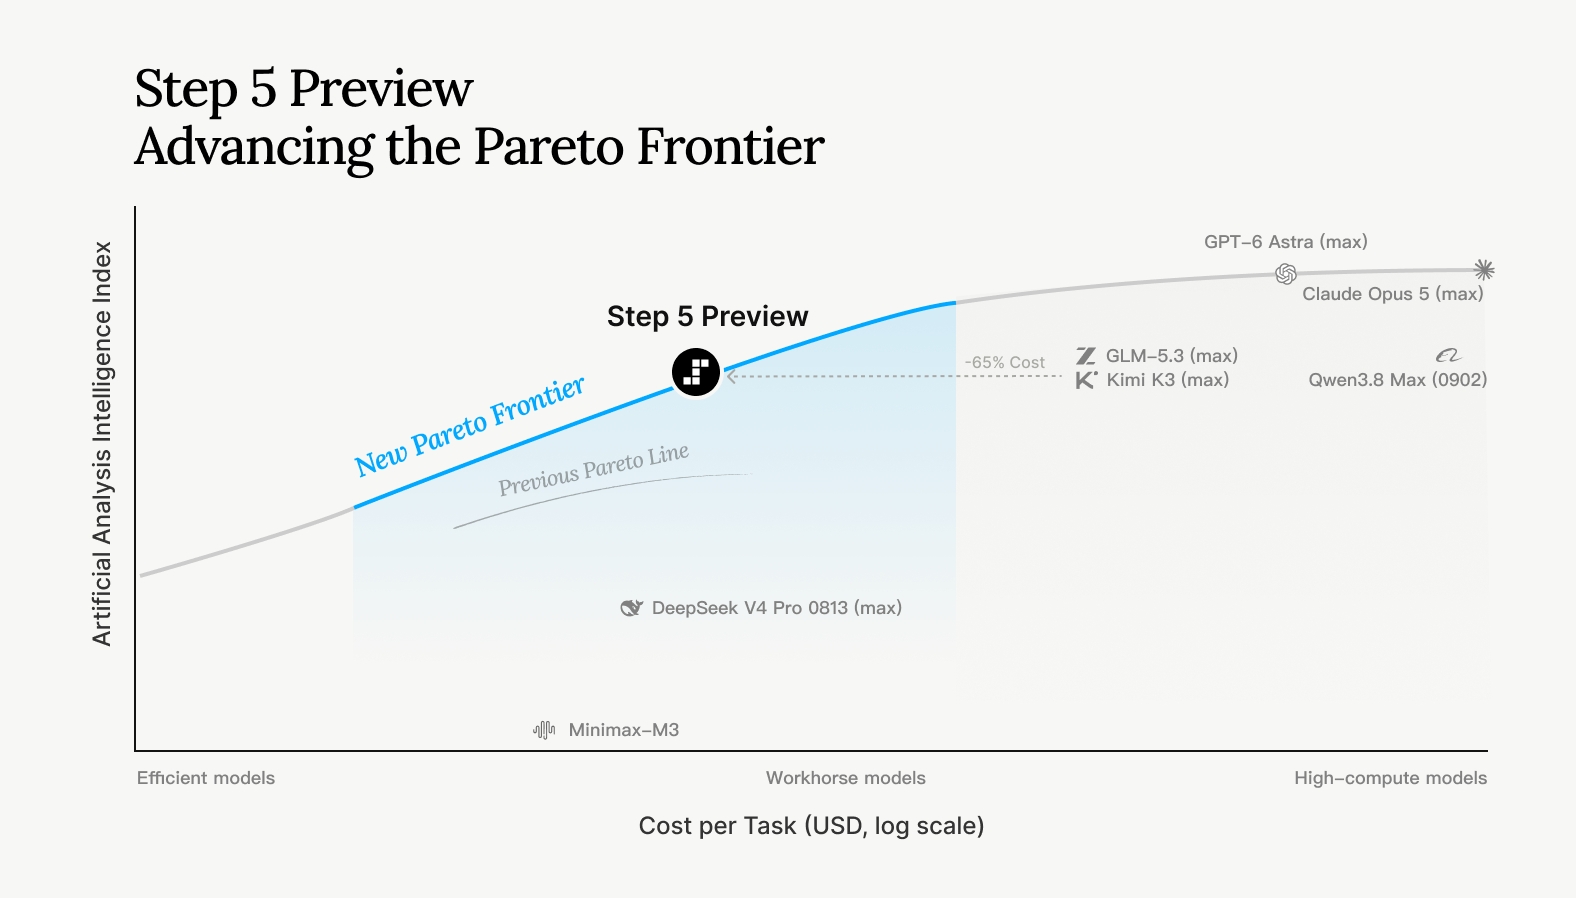 Abb.: Offizielles Streudiagramm „Intelligenzniveau vs. Kosten pro Aufgabe“, das die Kosteneffizienz von Step 5 bei vergleichbarer Leistungsfähigkeit darstellt. Quelle: Offizielle Ankündigung von StepFun
Ein 600B-Koloss war nie dafür konzipiert, lokal auf gewöhnlichen Entwickler-Rechnern betrieben zu werden. In den Diskussionen auf Hacker News wurde schnell betont, dass statische Gewichte dieser Größenordnung nicht in den typischen 128-GB-Einheitsspeicher moderner Workstations passen. Das Modell erfordert zwingend großskalige Cloud-Cluster, um die Hardwarekosten über extreme Dünnbesetzung zu amortisieren. Es handelt sich um ein System, das von Grund auf für Cloud-native APIs maßgeschneidert wurde.
95,1 % Cache-Trefferquote unterbieten die offiziellen Listenpreise drastisch
Auf OpenRouter wird Step 5 mit einem Listenpreis von 1,00 Dollar für Eingaben und 2,70 Dollar für Ausgaben pro Million Token geführt. Isoliert betrachtet wirken diese Zahlen im aktuellen Preiskampf der API-Anbieter unspektakulär. Die wahre Sprengkraft entfaltet sich jedoch durch die Cache-Trefferquote von 95,1 %, die den Preis für zwischengespeicherte Token auf minimale 0,05 Dollar drückt. Wer die API-Kosten eines 1M-Kontexts ohne Caching-Mechanismen betrachtet, verfehlt die Realität: Häufig wiederverwendete System-Prompts und umfangreiche Referenzdokumente senken die effektiven Rechnungsbeträge dramatisch.
Die Auswertungen von OpenRouter belegen, dass der gewichtete Durchschnittspreis für Eingaben dank Caching auf 0,0966 Dollar pro Million Token sinkt. Solange die Prompts im Server-Cache verbleiben, erhalten Anwender die Inferenzleistung eines modernen multimodalen Spitzenmodells zum Tarif eines kleinen Modells der Zehn-Milliarden-Klasse. StepFun positioniert das Modell ausdrücklich als Flaggschiff für Agenten-Workflows und demonstrierte dies anhand der Anwendung „Room Planner“, die aus einem simplen Schlafzimmerfoto einen editierbaren 3D-Raum generiert.
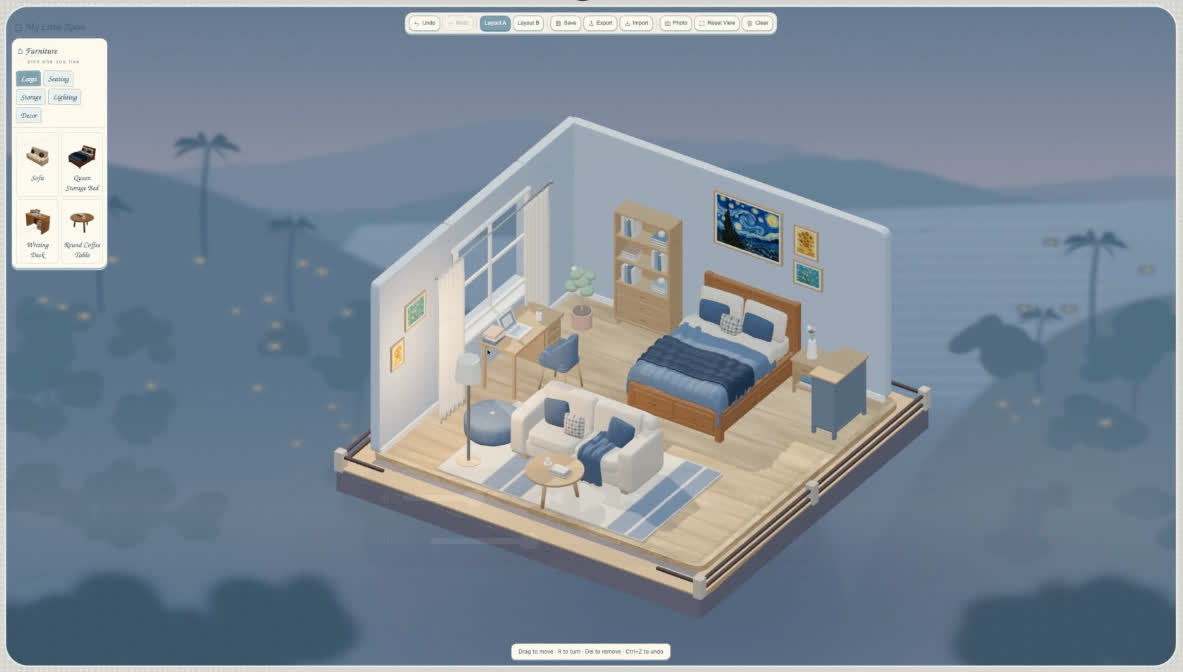 Abb.: Offizielle Demonstration „Room Planner“ zur Erzeugung editierbarer 3D-Räume aus einem einzigen Schlafzimmerfoto. Quelle: Offizielle Ankündigung von StepFun
In Workflows, bei denen Bildzustände fortlaufend übermittelt und Resultate iterativ verfeinert werden, ist Prompt-Caching der einzige Weg, um niedrige Latenzen und vertretbare Kosten zu gewährleisten. Diese Asymmetrie bricht mit dem traditionellen Dogma, dass hohe Modellqualität zwingend hohe Token-Gebühren erfordert. Die hohe Cache-Trefferquote gleicht den Rechenaufwand in der Prefill-Phase effektiv aus, sodass Anbieter ihre Dienste zu minimalen Grenzkosten bereitstellen können. Dieser wirtschaftliche Spielraum ermöglichte es StepFun, die Veröffentlichung der offenen Gewichte für den 15. Oktober anzusetzen.
Vorsprung im DeepSWE: Spitzenleistung bei isolierten Programmieraufgaben
Bei der Code-Generierung und statischen Fehlerbehebung beweist Step 5 beachtliche Durchschlagskraft im Einzeldurchlauf. Im Benchmark DeepSWE v1.1 erzielte das Modell 67,7 Punkte und setzte sich damit knapp gegen Kimi K3 Max (67,5 Punkte) und GLM-5.3 Max (66.9 Punkte) aus dem Lager der offenen Gewichte durch. Im hauseigenen StepCodeBench baute Step 5 diesen Vorsprung mit 49,0 Punkten gegenüber Kimi (43,9) und GLM (40,2) noch deutlich aus.
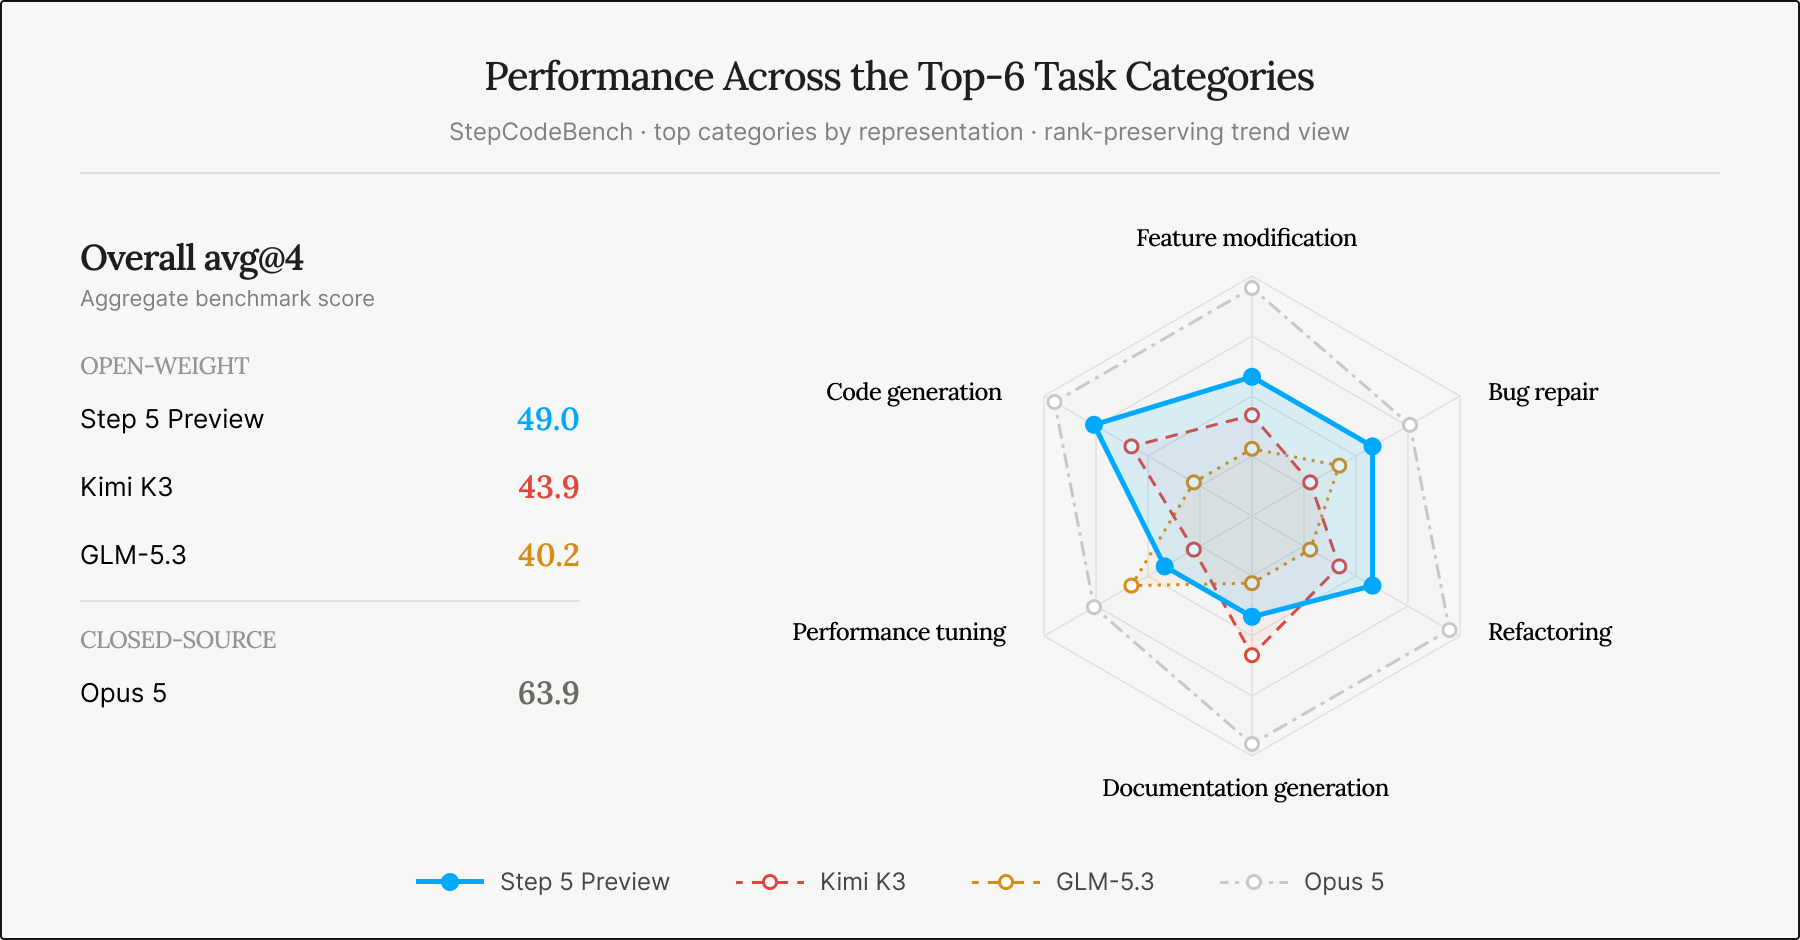 Abb.: Offizielles Netzdiagramm zum Vergleich von sechs Aufgabenkategorien in StepCodeBench. Quelle: Offizielle Ankündigung von StepFun
Bei statischer Code-Vervollständigung und Patch-Synthese schließen Open-Source-Modelle kontinuierlich zum proprietären Spitzenreiter GPT-6 Astra (74,1 Punkte) auf. Um die Aussagekraft der Ergebnisse zu untermauern, verweist StepFun darauf, dass StepCodeBench 553 eigenständige Repositories, 9 Aufgabentypen und 33 Programmiersprachen umfasst. Auch in den anspruchsvollen Fachbenchmarks ProgramBench (80,5 Punkte) und FrontierFinance (66,4 Punkte) belegte Step 5 den Spitzenplatz unter den offenen Modellen und rückte bei Finanzaufgaben nahe an Claude Opus 5 heran.
In Expertenbefragungen stuften rund 70 % der internen und externen Prüfer das Modell als fähig ein, Programmieraufgaben mittlerer bis hoher Komplexität eigenständig zu bewältigen. Diese statischen Messwerte zeichnen das Bild eines hochspezialisierten Werkzeugmodells für abgegrenzte Entwicklungsdomänen.
3,47 Sekunden Latenz bremsen mehrstufige Ausführungen im Terminal-Bench
Die Erfolge in statischen Tests können jedoch nicht darüber hinwegtäuschen, dass Step 5 in dynamischen, interaktiven Szenarien schwächelt. Im Benchmark Terminal-Bench v4, der mehrstufige Terminal-Interaktionen bewertet, kam Step 5 auf lediglich 33,3 Punkte – weit abgeschlagen hinter GLM-5.3 (41,9 Punkte) und in deutlicher Distanz zu GPT-6 Astra (57,9 Punkte). Langwierige Agenten-Aufgaben erfordern mehr als nur korrekten Code im ersten Durchlauf; sie verlangen absolute Kontextstabilität über Dutzende von Dateizugriffen und Tool-Aufrufen hinweg.
Telemetriedaten von OpenRouter erklären diesen Einbruch: Die End-to-End-P50-Latenz liegt bei 13,05 Sekunden, während die Fehlerrate bei strukturierten Ausgaben 15,15 % erreicht. Wenn ein Testlauf die Verkettung von über zehn Terminalbefehlen verlangt, kumuliert sich eine Time-to-First-Token von 3,47 Sekunden (P50) rasant. Wie in Hacker-News-Kommentaren treffend bemerkt wurde: In Agenten-Systemen tilgt jede Einzelschritt-Latenz jenseits von 1,5 Sekunden den Vorteil eines hohen Durchsatzes im Handumdrehen.
Die Fehlerrate von 15,15 % bei strukturierten Formaten ist für Tool-Calling-Schleifen eine schwere Hypothek. Zwar liegt die grundlegende Tool-Calling-Fehlerrate bei nur 1,81 %, doch syntaktische Abweichungen in JSON-Strukturen oder Shell-Befehlen bringen den gesamten Ausführungspfad zum Scheitern. Step 5 liest umfangreiche Codebasen mühelos und liefert präzise Patches, doch sobald das Modell in eine autonome Validierungsschleife im Terminal übergeht, werden Latenz und Schema-Drift zu unüberwindbaren Hindernissen.
Rückstand bei Gesamtindizes: Warum Systemarchitekten auf gezielte Stärken setzen
Angesichts dieser gegensätzlichen Testergebnisse gehen die Meinungen in der Entwicklergemeinde auseinander. Auf Hacker News verwiesen einige Nutzer auf den Artificial-Analysis-Gesamtindex, bei dem Step 5 mit 44 Punkten abschnitt, und bemängelten das Fehlen von Spitzenwerten über alle Testdimensionen hinweg. Andere Entwickler hielten dagegen, dass kumulierte Ranglisten vor allem dem Marketing dienen. Für Systemarchitekten zähle in der Praxis primär, wie ausgeprägt die spezifischen Spitzen eines Modells sind.
Seit den Versionen Step 3.5 und 3.7 hat StepFun gezielt an Funktionsaufrufen und der Koordination von Sub-Agenten gefeilt. Die Community sieht in Step 5 kein Modell, das auf generische Chatbot-Bestenlisten abzielt, sondern einen Baustein für dedizierte Workflows: als Ausführungsknoten in Agenten-Clustern, der riesige Kontextmengen verarbeitet und zielgerichtete Lösungen liefert.
Dank starker Dünnbesetzung und einer Cache-Trefferquote von 95 % definiert Step 5 niedrige Kosten als primäres Architekturelement und nicht als Begleiterscheinung reduzierter Leistungsfähigkeit. Der größte engineeringseitige Mehrwert besteht darin, 1M-Kontexte und anspruchsvolle Code-Generierung in ein drastisch günstigeres Preissegment überführt zu haben. Auch wenn die Defizite im mehrstufigen Terminal-Bench unübersehbar bleiben: Entwickler, die Latenzfallen durch externe Frameworks abfedern können, finden in diesem Modell ein bemerkenswert attraktives Preis-Leistungs-Verhältnis.
Weiterführende Links:
- Offizielle Ankündigung von Step 5 Preview
- OpenRouter Modellseite
- Diskussion auf Hacker News