Ausgabepreise um den Faktor 9 gesenkt, Kosten pro Aufgabe um das 20-Fache reduziert
Am 16. November 2026 stellte Tencent Hunyuan das Modell Hy4 flash vor. In der offiziellen API-Preisliste liegt der Ausgabepreis bei 0,281 US-Dollar pro Million Token – verglichen mit 2,501 US-Dollar bei der Vorgängergeneration Hy4 entspricht dies einem Preissturz um das 8,9-Fache. Beim zwischengespeicherten Eingabepreis (Cached Input) weitet sich der Abstand sogar auf das 14-Fache aus (0,003 gegenüber 0,042 US-Dollar). Die bemerkenswerteste Zahl verbirgt sich jedoch im internen Benchmark WorkIndex von Tencent: Für die Erledigung identischer Aufgaben belaufen sich die durchschnittlichen Kosten pro Aufgabe bei Hy4 flash auf lediglich ein Zwanzigstel im Vergleich zu Hy4.
 Abbildung: Hauptgrafik der Ankündigungsseite von Hy4 flash. Quelle: Tencent Hunyuan
Ankündigungen über Preissenkungen bei großen Sprachmodellen gab es in den vergangenen zwei Jahren zuhauf, doch eine Reduzierung der realen Kosten pro Aufgabe auf ein Zwanzigstel markiert ein Novum. Ein Token ist die kleinste Abrechnungseinheit eines Modells und entspricht grob einem Zeichen oder einem halben Wort; praxisrelevante Aufgaben verbrauchen schnell Hunderttausende von Token. Wenn zwar der Token-Preis sinkt, das Modell jedoch weitschweifiger antwortet, wächst die Rechnung dennoch. Tencent hat den Bewertungsmaßstab daher konsequent vom reinen Token-Preis auf abgeschlossene Aufgaben umgestellt – und mit dem Wechsel des Maßstabs verschieben sich auch die Ranglisten.
Ein derartiges Preisniveau lässt sich nicht durch reine Marketingrabatte halten. Es erfordert systematische Einsparungen auf allen Ebenen des Modell- und Inferenz-Stacks. Hy4 flash erzielt diesen Kostensprung durch drei klar definierte Schichten: Modellarchitektur, Inferenz-Engineering und Post-Training. Im Folgenden werden diese drei Ebenen im Detail aufgeschlüsselt.
Bepreisung nach Token, Abrechnung nach Aufgaben
WorkIndex ist ein von Tencent entwickelter interner Evaluierungsbenchmark. Seine acht Testdisziplinen bilden konkrete, abrechenbare Arbeitsabläufe ab: Erstellung von Präsentationen, Überarbeitung von Folien, kollaborative Präsentationserstellung zwischen Mensch und KI, gemeinsame Markdown-Verfassung, Dokumentenbearbeitung, Korrektur von Tabellenkalkulationen, Audio- und Videobearbeitung sowie visuelles Verstehen. Nach offiziellen Angaben übertrifft Hy4 flash die Gesamtaufgabenleistung von Hy4 preview leicht, während die durchschnittlichen Kosten pro Aufgabe auf 1/13 von Hy4 preview, 1/20 von Hy4 und 1/8 von DeepSeek-V4.1-Flash-1017 sinken (letzteres berechnet nach der Max-Stufe zu Spitzenzeiten).
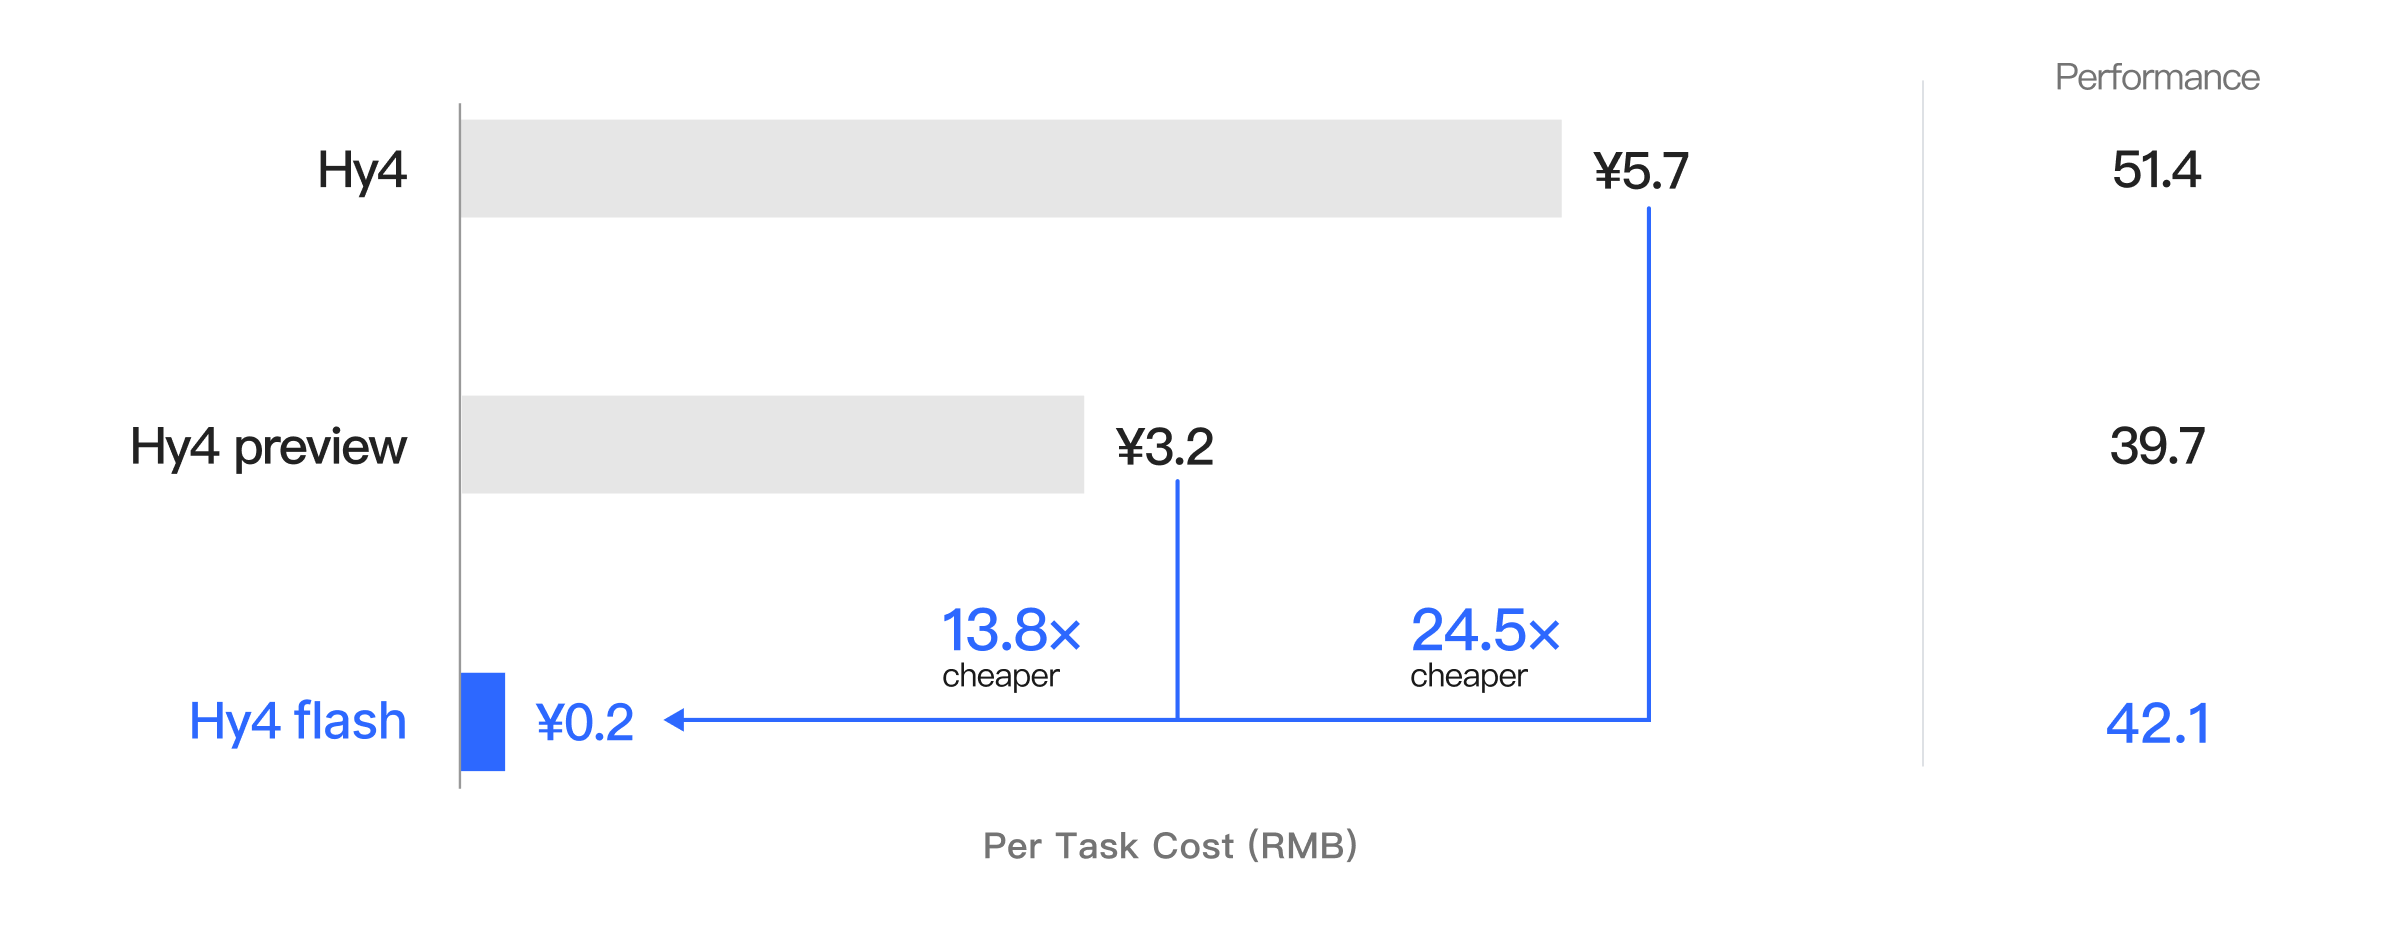 Abbildung: Offizielle Figure 1: Leistungs-Kosten-Verteilung über acht interne WorkIndex-Evaluierungen und sieben öffentliche Agenten-Benchmarks. Bemerkenswert ist, dass die horizontale Achse die Kosten und nicht die Punktzahl abbildet. Quelle: Tencent Hunyuan
Die Kernaussage dieser Gegenüberstellung ist in der Bildunterschrift festgehalten: Während die Leistungswerte nahezu identisch bleiben, brechen die Kosten um das 8- bis 20-Fache ein. Indem Tencent die Kosten als Hauptachse wählt, setzt das Unternehmen ein klares Statement: Bevor über die Leistungsfähigkeit eines Modells diskutiert wird, muss dessen Wirtschaftlichkeit geklärt sein. Je enger die Scores auf öffentlichen Bestenlisten zusammenrücken, desto entscheidender wird die Kostenrechnung als primäres Differenzierungsmerkmal.
Der erste Hebel: KV-Cache auf 1/24 verkleinert
Um die Einsparungen zu verstehen, muss die Rolle des KV-Cache (Key-Value-Cache) betrachtet werden. Wann immer ein Sprachmodell ein langes Dokument verarbeitet, legt es eine Art Notizbuch an, in dem die Aufmerksamkeitsbeziehungen zwischen jedem Token und dem vorherigen Kontext festgehalten werden. Je umfangreicher das Dokument ist, desto mehr Grafikspeicher belegt dieses Notizbuch, desto mehr Speicherseiten müssen bei jedem Generierungsschritt durchsucht werden und desto teurer wird der Betrieb. Bei Aufgaben mit langen Kontexten entfällt der Großteil der Infrastrukturkosten auf diesen Speicherbedarf.
Hy4 flash kombiniert drei Architekturbausteine: hybride Aufmerksamkeit (verschiedene Textabschnitte werden mit unterschiedlicher Rechenintensität verarbeitet, um einfache Passagen ressourcenschonend zu berechnen), LatentMoE (eine Mixture-of-Experts-Architektur, bei der der Großteil der Modellparameter im Leerlauf verbleibt und nur bei Bedarf aktiviert wird) sowie Engram. Offiziellen Zahlen zufolge schrumpft der KV-Cache-Bedarf dadurch auf 1/24 im Vergleich zu Hy3 und 1/6 im Vergleich zu Hy4. Weil das Notizbuch auf einen Bruchteil seiner ursprünglichen Größe schrumpft, wird ein Kontextfenster von 1 Million Token wirtschaftlich tragbar. Selbst wenn Dokumente mit Millionen Wörtern verarbeitet werden, läuft der Grafikspeicher nicht voll. Der Preis für zwischengespeicherte Eingaben von 0,003 US-Dollar ist die direkte Konsequenz: Wiederkehrende Kontexte müssen nicht neu berechnet werden, und die vorzuhaltenden Daten beanspruchen nur noch einen winzigen Bruchteil des Speichers.
Die MoE-Architektur spart gezielt Rechenleistung: Von den 224 Milliarden Gesamtparametern (darunter 64 Milliarden im Engram-Modul) werden pro Token lediglich 12 Milliarden aktiviert. Bildlich gesprochen stehen in einer Halle 224 Mitarbeiter bereit, doch bei jedem eingehenden Wort werden nur 12 von ihnen zur Arbeit gerufen, während die übrigen keine Betriebskosten verursachen. Rechenleistung streng bedarfsgerecht abzurufen und inaktive Parameter nicht mit Strom zu versorgen, bildet das architektonische Fundament für dauerhaft niedrige Preise.
Höhere Geschwindigkeit, kürzere Antworten
Während die Architektur den Speicherbedarf senkt, reduziert das Inferenz-Engineering die reine Maschinenzeit. Der Inferenz-Stack von Hy4 flash stützt sich auf drei zentrale Säulen: Megakerne (Zusammenfassung der gesamten Decodierschleife in ein hochgradig fusioniertes GPU-Programm, wodurch Latenzen beim Hin- und Hertransportieren von Daten zwischen Modulen entfallen), 4-Bit-Quantisierung (Verdichtung der Modellparameter von hochpräzisen Gleitkommazahlen auf 4 Bit, was Speicherbandbreite schont) sowie DFly-Scheduling. Tencent beziffert die Decodiergeschwindigkeit auf über 150 Token pro Sekunde. Niedrige Preise setzen hohe Geschwindigkeiten voraus: Je mehr Token ein einzelner Grafikprozessor pro Sekunde ausgibt, desto geringer fällt die auf das einzelne Token entfallende Maschinenlaufzeit aus – nur so bleibt das Angebot profitabel.
Das Post-Training setzt am Volumen der erzeugten Token an. Hy4 flash durchlief zunächst eine Selbstdestillation auf Basis des größeren Vorgängermodells Hy4, um allgemeine Problemlösungskompetenzen zu übernehmen, und wurde anschließend mittels Reinforcement Learning darauf trainiert, präzise und knapp zu antworten. Laut offiziellen Daten sanken die durchschnittlichen End-to-End-Ausgabetoken um 50 Prozent. Da die Token-Ausgabe die teuerste Stufe der Preisstruktur darstellt (0,281 US-Dollar gegenüber 0,070 US-Dollar bei Standardeingaben), halbiert eine um die Hälfte gekürzte Antwort unmittelbar die Rechnung. Dieser Ansatz entfaltet unter den drei Optimierungsschritten die direkteste Wirkung.
Erst im Zusammenspiel dieser drei Ebenen entsteht die Reduzierung auf 1/20: Die Architektur minimiert den Speicherbedarf, das Inferenz-Engineering reduziert die Laufzeit pro Einheit, und das Post-Training halbiert die teuersten Ausgabetoken. Keine dieser Maßnahmen hätte isoliert betrachtet einen Kostenvorteil dieser Größenordnung erzielen können. Echte Wirtschaftlichkeit ist ein Resultat gezielten Systemdesigns, nicht kurzfristiger Preisnachlässe – Erstere ist fest in Modell und Inferenz-Stack verankert, Letztere existiert nur auf Werbefolien.
Offizielle Zahlen: Einordnung und Bewertung
Hinsichtlich der Datenbasis ist Transparenz geboten: Sämtliche angeführten Kennzahlen stammen aus offiziellen Angaben von Tencent. WorkIndex ist ein interner Benchmark; die Testszenarien und Vergleichsmodelle wurden intern festgelegt, und unabhängige Reproduktionen durch Dritte stehen bislang aus. Solche internen Leistungsnachweise weisen naturgemäß eine Tendenz zugunsten des Anbieters auf und bedürfen einer kritischen Würdigung.
Allerdings deuten mehrere unabhängige interne Signale auf eine breite Bestätigung hin. In einem Doppelblindtest mit 85 internen WorkBuddy-Nutzern über 259 Aufgaben und 27 Kategorien hinweg erzielte Hy4 flash Zufriedenheitswerte auf dem Niveau von Claude Haiku 5.5, bot die kürzeste Gesamtlaufzeit und wies deutlich niedrigere Aufgabenkosten auf als alle Vergleichsmodelle. Auch in produktiven Anwendungen zeichnen sich konsistente Verbesserungen ab: Im Produktivitätsassistenten WorkBuddy sank die durchschnittliche Bearbeitungszeit um 70 Prozent bei Kosten von etwa 1/15 von Hy4. Der WeCom-Assistent DaYuan lieferte Antworten 88 Prozent schneller aus und reduzierte die Ausgabetoken im Denkmodus um rund 60 Prozent. In der QQ-Plattform steigerte der Assistent Xiao Q die Nutzerzufriedenheit bei Musikempfehlungen, Kanalinteraktionen, Qzone-Beiträgen und Horoskopanalysen um 6,16, 2,84, 0,92 bzw. 2,22 Prozentpunkte, während Yuanbao eine Verbesserung der Agentenleistung um 13,6 Prozent gegenüber Hy3 verzeichnete.
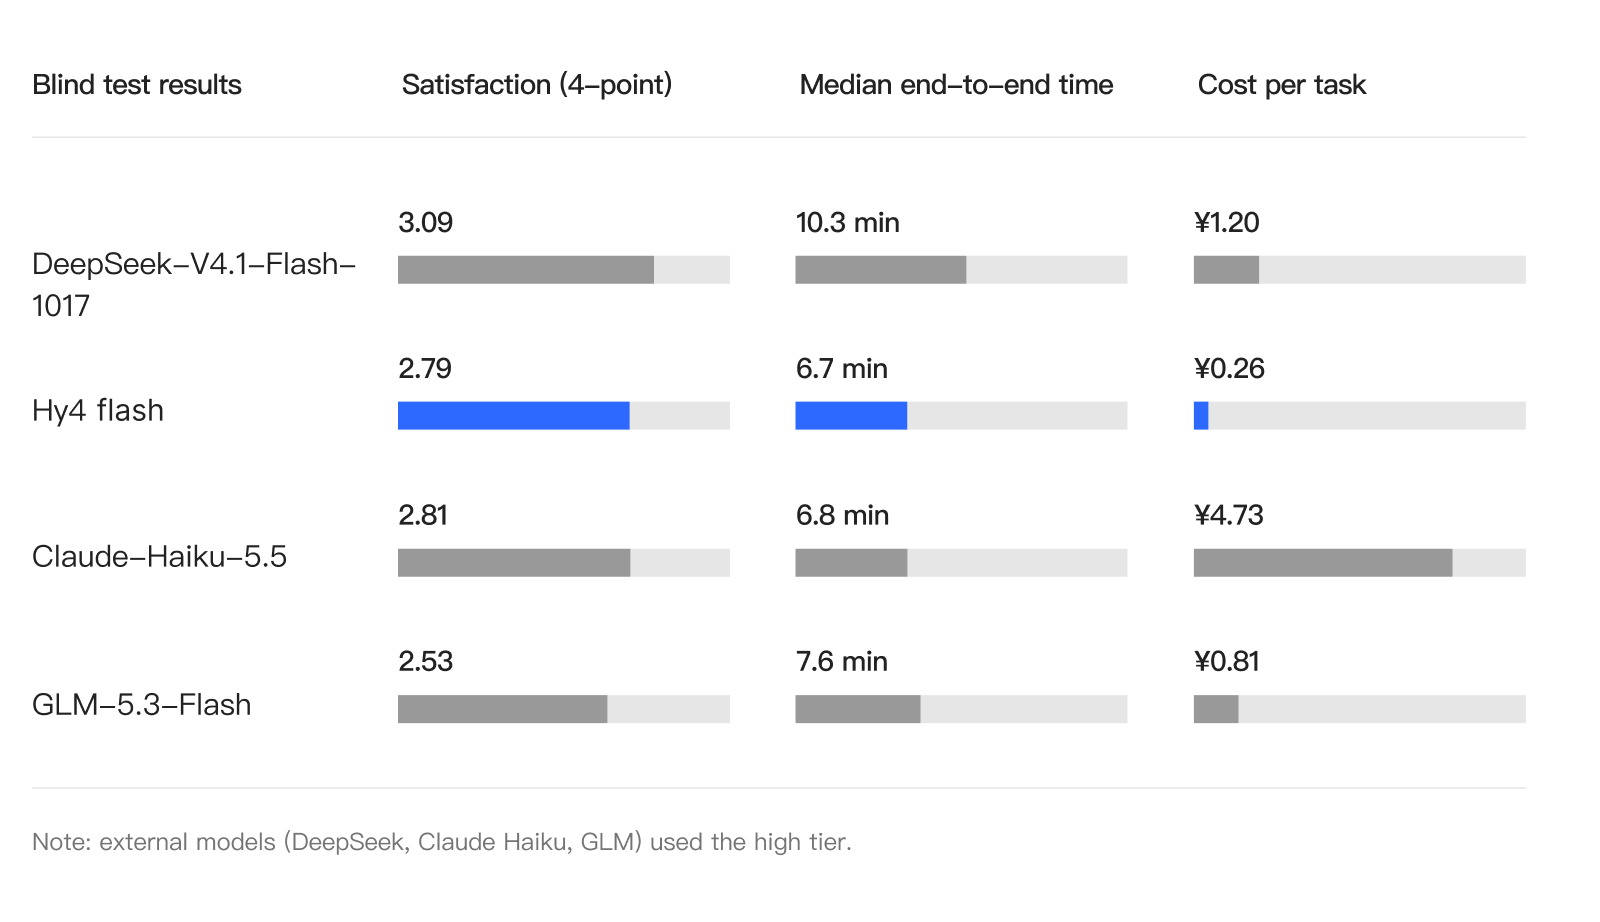 Abbildung: Ergebnisse des Doppelblindtests mit 85 WorkBuddy-Nutzern über 259 Aufgaben und 27 Kategorien. Die Zufriedenheit reichte an Haiku 5.5 heran bei zugleich kürzester Bearbeitungszeit. Quelle: Tencent Hunyuan
Während ein einzelner Benchmark gezielt optimiert werden kann, lässt sich eine gleichzeitige Leistungssteigerung über mehrere voneinander unabhängige Produktlinien hinweg kaum künstlich herbeiführen. Büroanwendungen, Kommunikationsassistenten und autonome Agenten weisen alle in dieselbe Richtung. Dies belegt, dass die Architektur zur Kostensenkung in realen Produktionsumgebungen stabil funktioniert. Genaue Messwerte müssen durch unabhängige Dritte bestätigt werden, die grundsätzliche Tendenz ist jedoch plausibel.
Ein neues Wertungsschema im Spitzenfeld
In der Ankündigung steckt Tencent die Einsatzszenarien klar ab: Für alltägliche Produktivitätsaufgaben – gründliche Websuche, Dokumentenverarbeitung, Präsentationserstellung, schnelle Frontend-Prototypen sowie Computer Use (die direkte Bedienung von Desktop-Oberflächen durch das Modell) – wird Hy4 flash empfohlen. Für komplexe, langfristige Softwareentwicklungsprojekte empfiehlt Tencent weiterhin das Standardmodell Hy4 aufgrund dessen höherer Denk- und Abstraktionsfähigkeit. Beide Modelle koexistieren: flash überzeugt durch überragende Wirtschaftlichkeit, Hy4 durch maximale Problemlösungskompetenz.
Die Bereitstellungskanäle sind bereits eingerichtet: Das Modell ist über Tencent Cloud TokenHub, WorkBuddy, Yuanbao, WeCom, QQ, ima und Marvis verfügbar; eine Anbindung an OpenRouter ist in Vorbereitung. Bis zum 30. November ist WorkBuddy kostenlos nutzbar, und auf die TokenHub-API wird ein Rabatt von 50 Prozent gewährt. Zudem plant Tencent die Veröffentlichung der Modellgewichte als Open Source. Erst wenn der Code frei zugänglich ist, wird sich zeigen, wie viele Entwickler und Unternehmen die Kombination aus 1/24-KV-Cache, Megakernel und halbierter Token-Ausgabe adaptieren – dies wird der eigentliche Härtetest für das Konzept sein.
Um auf die eingangs erwähnte Zahl zurückzukommen: Wenn die kognitiven Fähigkeiten führender Modelle zunehmend konvergieren, entwickeln sich die Kosten pro Aufgabe zum entscheidenden Hebel für signifikante Wettbewerbsvorteile. Die Wirtschaftlichkeit von Hy4 flash basiert auf systematischer Optimierung von Architektur, Inferenzpipeline und Post-Training, ohne Abstriche bei den allgemeinen Modellfähigkeiten zu machen. Diese Effizienz ist im System selbst verankert und lässt sich von Wettbewerbern studieren und adaptieren. Auf der Anzeigetafel des Spitzenfelds stehen künftig zwei Werte: die Punktzahl im Benchmark und der Betrag auf der Abrechnung. Nachdem der Wettlauf um die höchste Intelligenz an Trennschärfe verliert, hat der Wettbewerb um die günstigste Ausführung gerade erst begonnen.
Weiterführende Links:
- Offizielle Ankündigungsseite von Tencent Hunyuan Hy4 flash