出力単価は約9分の1、タスクあたりコストは20分の1へ
2026年11月16日、テンセント混元(Tencent Hunyuan)は「Hy4 flash」を発表した。公式API料金表によると、出力100万トークンあたりの価格は0.281米ドルで、前世代Hy4の2.501米ドルから約8.9倍引き下げられた。キャッシュヒット時の入力価格差はさらに広がり、0.042米ドルから0.003米ドルへと14倍に達する。だが本当に注目すべき数字は、公式社内ベンチマーク「WorkIndex」に隠されている。まったく同じ業務をこなした場合、Hy4 flashのタスクあたり平均コストはHy4の20分の1に抑えられている。
 図:Hy4 flash発表ページのメインビジュアル。出典:テンセント混元
過去2年間、大規模言語モデルの「値下げ」発表は数多く行われてきたが、「タスクあたりの実行コスト」を20分の1まで削った事例は極めて異例だ。トークンはモデル課金の最小単位であり、おおむね1文字から半単語に相当するが、実務タスクでは数十万トークンを容易に消費する。単価が下がってもモデルの出力が冗長になれば、請求額は結局膨らむ。テンセントは今回、比較の基準をトークン単価からタスク単位へと大胆に切り替えた。ものさしを変えれば、順位も一変する。
これほどの低価格化は、単なる発表会用の一時的なディスカウントでは維持できない。モデル構造と推論スタック全体から多層的にコストを削ぎ落とす必要がある。Hy4 flashのコスト削減手法は、アーキテクチャ、推論エンジニアリング、事後学習(ポストトレーニング)の3層に集約される。以下で順を追って解説する。
トークンで値付けし、タスクで支払う
WorkIndexはテンセントが独自構築した評価スイートであり、8つの評価項目はいずれも成果物単位で課金可能な具体的実務で構成されている。スライド新規作成、スライド修正、人とAIの共同スライド作成、共同Markdown執筆、ドキュメント編集、スプレッドシート修正、音声・動画処理、視覚的理解だ。公式データによると、Hy4 flashの総合タスクスコアはHy4 previewをわずかに上回り、タスクあたりの平均コストはHy4 previewの13分の1、Hy4の20分の1、そしてピークタイムのMax帯で計算されたDeepSeek-V4.1-Flash-1017の8分の1にとどまる。
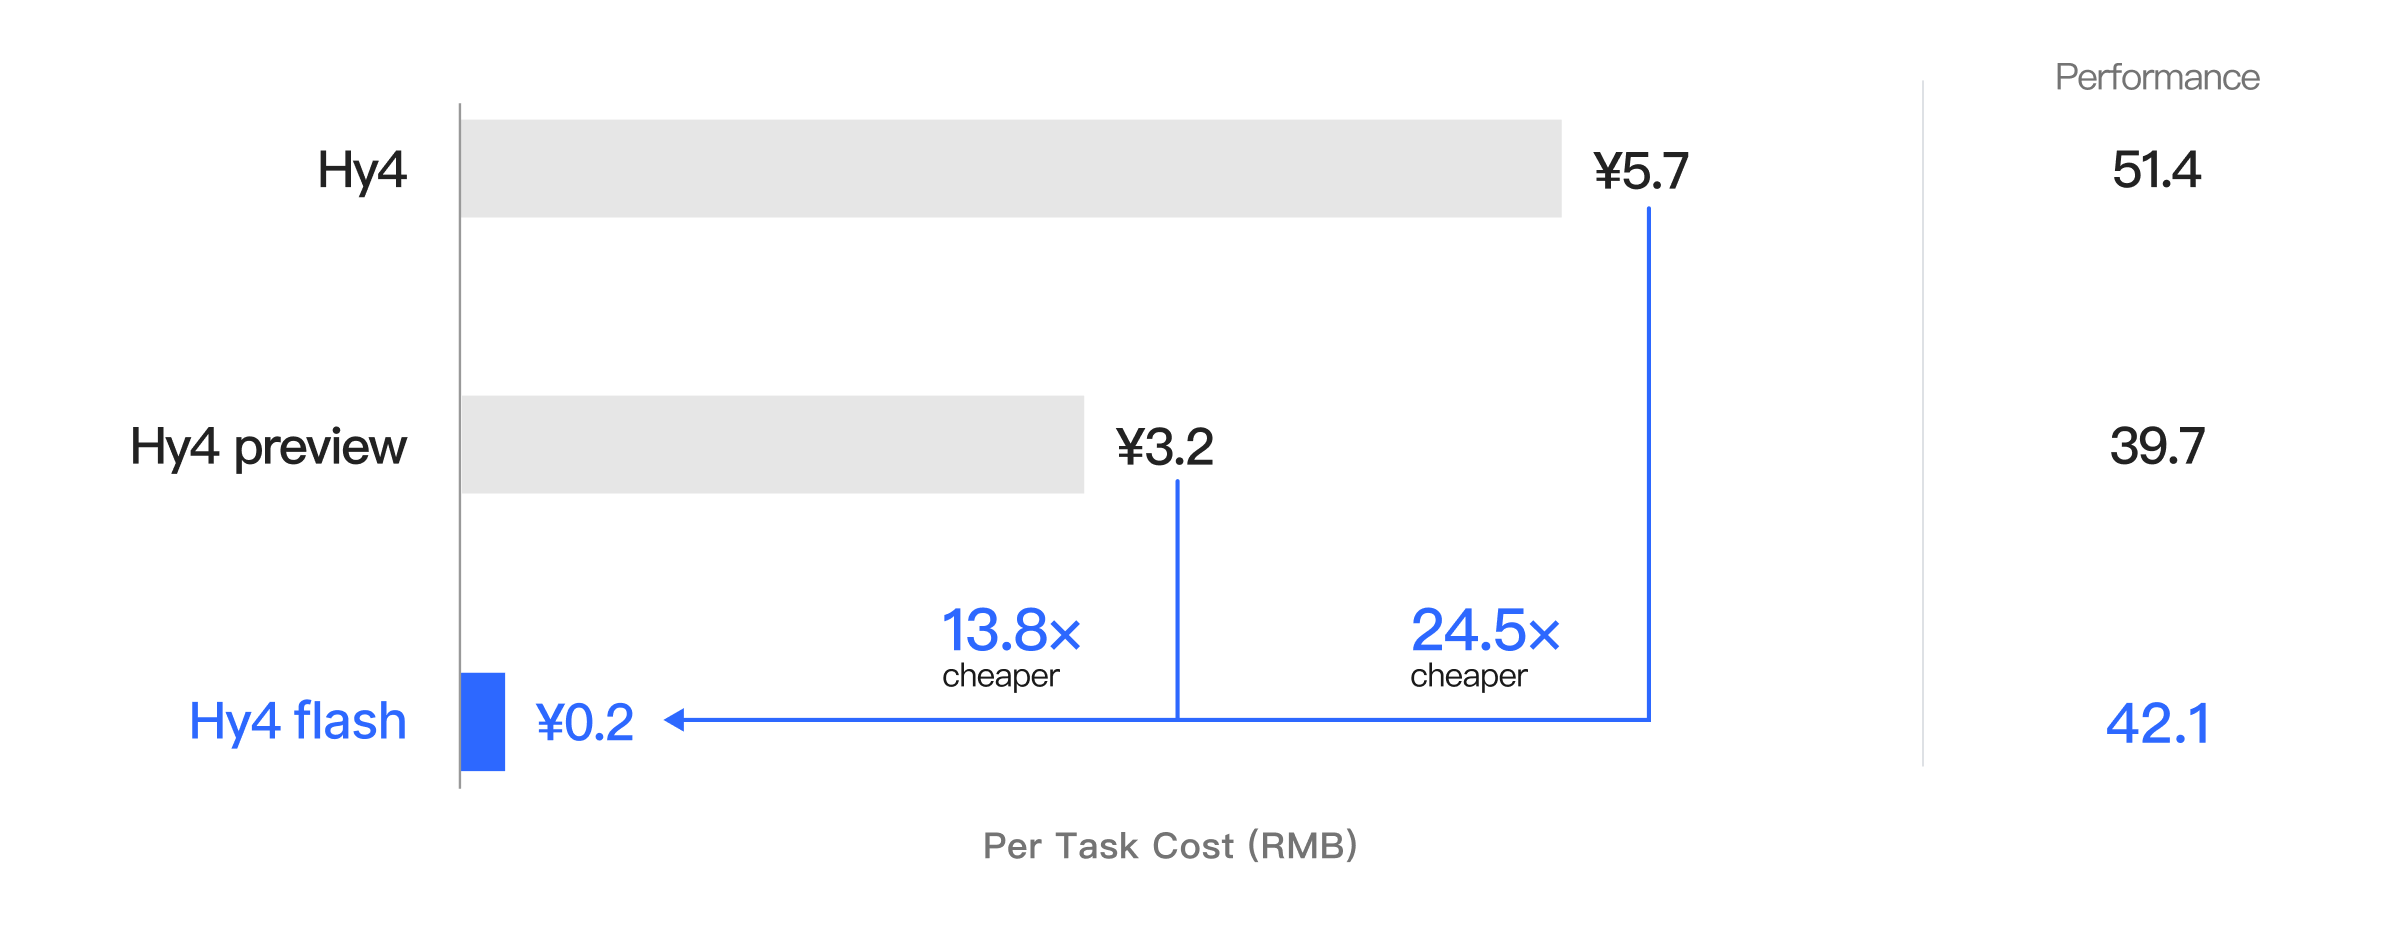 図:公式Figure 1:社内WorkIndex 8項目および公開エージェントベンチマーク7項目における性能とコストの分布。横軸はスコアではなくコストである点に注目。出典:テンセント混元
この比較図の読み解き方はキャプションに明記されている。スコアはほぼ同等を維持したまま、コストだけが8分の1から20分の1の帯域へ急落している。テンセントがコストを主軸に置いたこと自体がひとつの意思表明だ。モデルの実用性を測るなら、まず「いくらかかるのか」を問うべきだというメッセージである。各社の公開スコアが拮抗するほど、真の差を生み出す変数は請求書の数字へと移行していく。
コスト削減の第1手:KV cacheを24分の1へ圧縮
まずKV cache(Key-Value Cache)の役割を整理しよう。モデルは長文ドキュメントを読むたび、各文字と先行する文脈との関係をメモとして保持する。これがKV cacheだ。このメモが分厚くなるほどGPUメモリを圧迫し、生成ごとに参照すべきページ数が増え、運用コストが跳ね上がる。長文コンテキスト処理における費用の大半はこのメモの維持に費やされる。
Hy4 flashは、ハイブリッドアテンション(文脈に応じて計算精度を段階分けし、簡単な処理の計算量を抑える)、LatentMoE(専門家混合アーキテクチャ。モデルの大部分のパラメータを待機させ必要なものだけ動かす)、Engramという3つのアーキテクチャ要素を統合した。公式データによると、KV cacheの消費量はHy3の24分の1、Hy4の6分の1にまで縮小された。メモの厚みが従来の端数程度まで薄くなったことで、1Mトークンのコンテキストウィンドウを現実的なコストで運用できるようになる。 百万字規模のドキュメントを投入してもメモリが枯渇せず、だからこそ価格を引き下げられる。キャッシュヒット時の入力単価0.003米ドルという価格設定は、同じコインの裏返しだ。重複する文脈は再計算が不要で、保持すべきメモの容量も激減するため、ストレージコスト全体が圧縮される。
MoE設計が節約するのは計算リソースだ。総パラメータ数224B(うち64BはEngramモジュール)に対し、1トークンごとに活性化されるのはわずか12Bにすぎない。224人の従業員が待機するフロアで、1文字処理するごとに12人だけを招集し、残りは人件費を発生させずに待機させるイメージだ。必要な計算力だけをオンデマンドで動員し、遊休パラメータで電力を消費しない仕組みが、低単価を支えるアーキテクチャ上の基盤となっている。
処理を速く、そして短く話す
アーキテクチャがメモリとストレージを削るのに対し、推論エンジニアリングは処理時間を削る。Hy4 flashの推論スタックは3つの柱で構成される。megakernel(デコードループ全体を単一の融合GPUプログラムに集約し、モジュール間のデータ転送オーバーヘッドを排除)、4bit量子化(パラメータを高精度表現から4bitへと圧縮しメモリ帯域を節約)、そしてDFlyスケジューリングだ。公式発表によると、デコード速度は150トークン/秒以上を達成している。安さを実現するための前提条件は速さにある。1枚のGPUが1秒間に吐き出せるトークン数が増えるほど、トークンあたりに割り振られるマシン稼働時間は短くなり、薄利多売でも赤字にならない。
ポストトレーニングが削減するのは、生成されるトークン数そのものだ。Hy4 flashはまず前世代の大型モデルHy4からの自己蒸留を行い、教師役から汎用能力を継承したうえで、強化学習を通じて「要点を的確に、かつ簡潔に答える」訓練を施された。公式データによれば、エンドツーエンドの平均出力トークン数は50%削減された。出力トークンは料金体系の中で最も単価が高い(入力0.070米ドルに対し出力0.281米ドル)。言葉数を半分に絞れば、それだけで請求額は半減する。3層の中で最も直接的に効くアプローチだ。
この3つの層が掛け合わさることで、初めて20分の1という劇的な数字が成立する。アーキテクチャがメモリ維持費を削り、推論エンジニアリングが計算時間を薄め、ポストトレーニングが最も高価な出力を半減させる。どれか単体では1桁以上の価格差を打ち出せない。真の低価格は緻密なエンジニアリングによって設計されるものであり、単なるプロモーション価格とは根本的に異なる。前者はモデルの重みとスタックに刻み込まれ、後者は宣伝文句に留まるからだ。
公式発表の数字をどう受け止めるべきか
前提としてデータの出所を整理しておく必要がある。上述の数値はすべてテンセント公式の発表に基づいている。WorkIndexは自社製ベンチマークであり、評価課題や比較対象は独自に設定されたもので、現時点で第三者による検証は行われていない。公式発表のスコアシートには自社に有利なバイアスが含まれ得るため、一定の割り引きが必要だ。
しかし、社内の複数系統から整合的なシグナルが観測されている。85名の社内WorkBuddyユーザー、259件のタスク、27カテゴリを対象としたブラインドテストでは、Hy4 flashの満足度はClaude Haiku 5.5に迫り、エンドツーエンドの処理時間は最短を記録、タスクあたりコストは比較対象すべてのモデルを大きく下回った。業務プロダクト側の各チームでも顕著な成果が出ている。オフィスアシスタントWorkBuddyでは平均タスク所要時間が70%短縮され、コストはHy4の約15分の1となった。企業向けWeChat(WeCom)のアシスタント「大元」はHy4より出力が88%高速化し、思考モードの出力トークンが約60%減少した。QQの「小Q」は音楽推薦、チャンネル交流、Qzone、長文星座分析で満足度がそれぞれ6.16、2.84、0.92、2.22ポイント向上し、元宝のエージェント性能もHy3比で13.6%改善した。
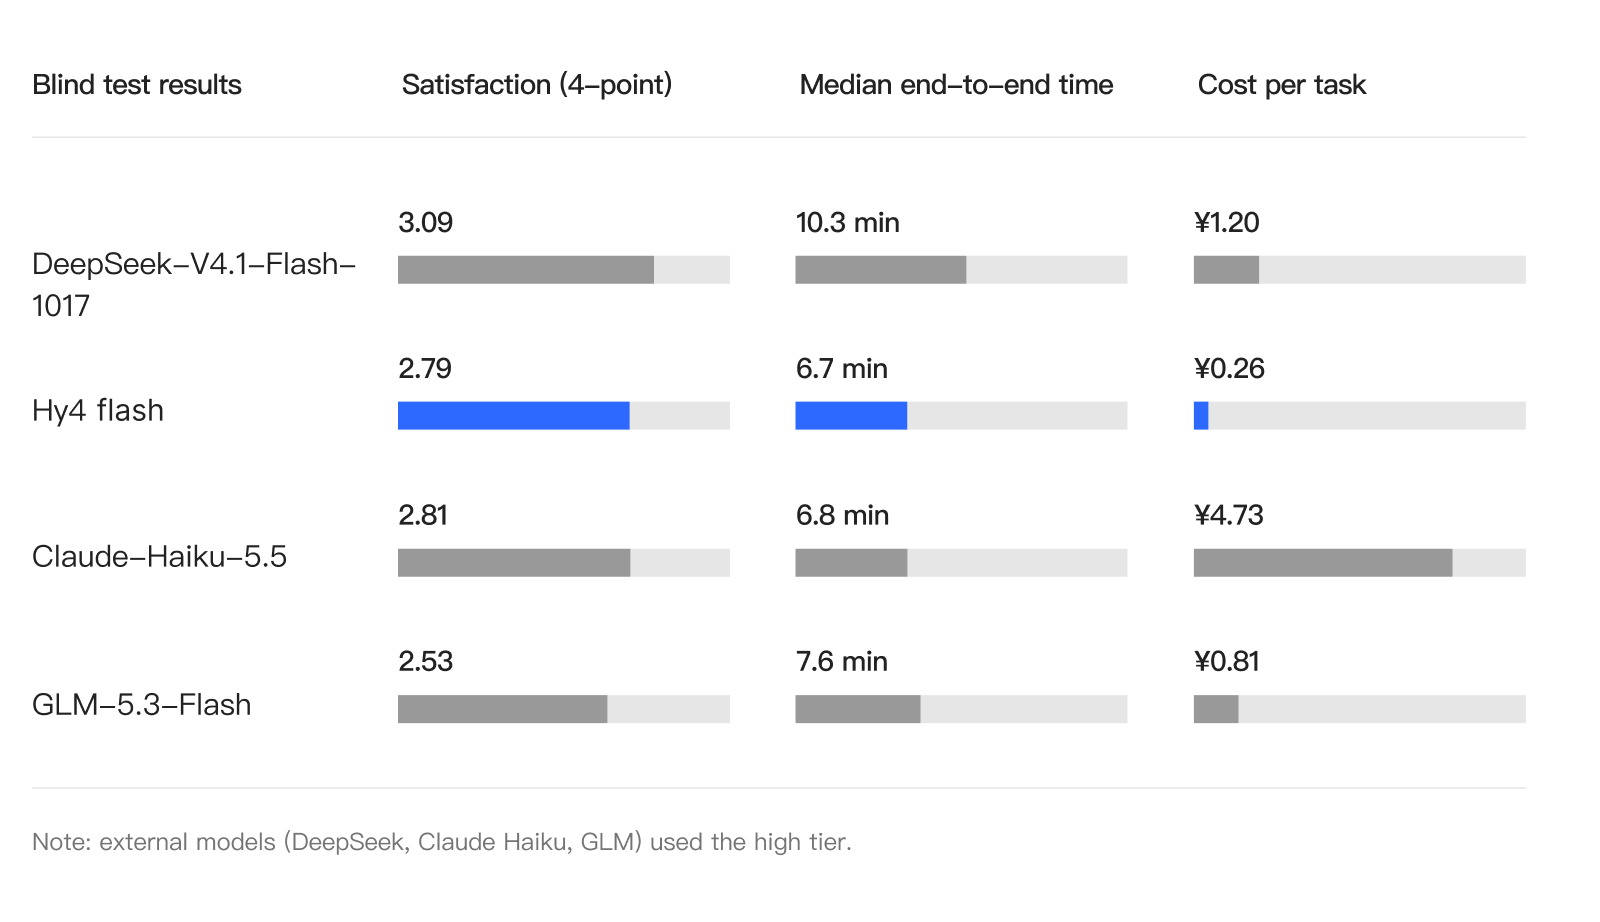 図:WorkBuddyユーザー85名、259タスク、27カテゴリによるブラインドテスト結果。Haiku 5.5に匹敵する満足度と最短の処理時間を記録。出典:テンセント混元
単一の社内ベンチマークなら都合よく設計できても、相互に独立した複数のプロダクトラインで同時に成果を揃えるのは容易ではない。オフィスツール、ソーシャルボット、自律エージェントの3領域が同じ方向性を示していることから、このコスト削減アーキテクチャが実際の商用環境で破綻していないことは読み取れる。厳密な数値検証は第三者の追試を待つ必要があるが、技術の方向性自体は十分に信憑性がある。
フロンティア競争のスコアボードが変わった
テンセントは発表の中で、モデルの使い分けの境界線を明確に引いている。日常的な生産性タスク――深掘り検索、文書処理、スライド作成、簡単なフロントエンド実装デモ、OSを操作するComputer Useなど――にはHy4 flashを推奨する。一方、長期的な推論が求められるソフトウェアエンジニアリングには、知能の上限が高いフラッグシップHy4を引き続き推奨している。flashはコストパフォーマンスで勝ち、Hy4は思考力の頂点で勝つという住み分けであり、どちらか一方が他方を駆逐する関係ではない。
提供チャネルはすでに整備されている。Tencent Cloud TokenHub、WorkBuddy、元宝、企業向けWeChat、QQ、ima、Marvisで利用可能であり、OpenRouterへの追加も控えている。11月30日まではWorkBuddyが無償提供され、TokenHub APIも半額キャンペーンが実施される。モデルウェイトのオープンソース化も計画されており、公開された暁には、「KV cache 1/24化+megakernel+出力半減」という構成案をどれだけの開発者や企業が追試・導入するかが、その真価を問う本当の試金石となるだろう。
冒頭の数字に立ち戻ろう。フロンティアモデルの知能差が縮まりつつある現在、タスクあたりの実行コストは桁違いの差を生み出せる数少ない重要変数となっている。Hy4 flashの低価格は、アーキテクチャ、推論最適化、ポストトレーニングの積み重ねによって汎用能力を落とさずに実現された。したがってこの安さはモデルとランタイムスタックそのものに定着しており、他社が模倣しようとも容易には揺るがない。次世代フロンティア競争のスコアボードには、2つの指標が並ぶことになる。ひとつはベンチマークのスコア、もうひとつは運用の請求額だ。誰が最も賢いかを競い合って差がつかなくなった後、誰が最も安く動かせるかを巡る戦いは、まだ始まったばかりだ。
参考リンク:
- テンセント混元 Hy4 flash 公式発表ページ