音声対話AIのデモはここ2年ほど華々しく披露されてきたが、企業の電話システムやコンタクトセンターで本格稼働した例は決して多くない。企業の導入を阻んできたのは主に2つの壁だ。ひとつは主要クラウドAPIを使うと1時間で数ドル単位に達する予測不能なコスト、もうひとつは会話の途中で1秒以上の沈黙が生じてしまう過剰な遅延である。
2026年10月21日、Mistralは音声モデルファミリー「Voxtral 3」を正式公開し、課金体系を一新した。音声文字起こしは1分あたり0.0035ドル、音声合成は文字数単位の従量課金。透明性の高い料金表が提示されたことで、音声エージェントは「実現できるかどうか」という技術実証から、「1分いくらで運用できるか」という調達の採算問題へと移行した。
滑らかなデモと計算できない請求書
これまで音声対話システムの構築といえば、複数の独立したサービスを組み合わせるのが常套手段だった。着信音声をまずテキストに書き起こし、大規模言語モデルに渡して回答を生成させ、そのテキストを音声合成エンジンに流して発話させる。課金単位もばらばらで、文字起こしは音声の長さ、推論はトークン数、合成は文字数で計算される。1本の問い合わせ電話が3種類の料金体系を跨ぐため、企業の財務部門にとって事前に月額上限を見積もることは困難を極めていた。
Voxtral 3はこれらの工程を単一のパイプラインに集約する。話者分離機能とコンテキストバイアスを備えた多言語文字起こしモデル「Voxtral Small Transcribe 3」、軽量4Bパラメータで低コスト展開を実現する「Mini Transcribe 3」、エンドツーエンド遅延を500ミリ秒未満に抑えたストリーミング対応の「Realtime Transcribe 3」、そして100万文字あたり13ドルで感情表現豊かな音声を出力する「Mini TTS 3」。さらに、複数ターンの対話や外部ツール呼び出し(Tool Calling)にネイティブ対応したVoice Agent SDKも同時に提供される。
4BモデルのMini Transcribe 3は分あたり0.0035ドル、1時間連続で文字起こしを行ってもわずか0.21ドル(約30円)に収まる。Mistralは公式発表の中で、OpenAI TTS-1、Deepgram、ElevenLabs Flash、Gemini Flashと価格を直接比較し、その圧倒的なコストパフォーマンスを前面に打ち出した。
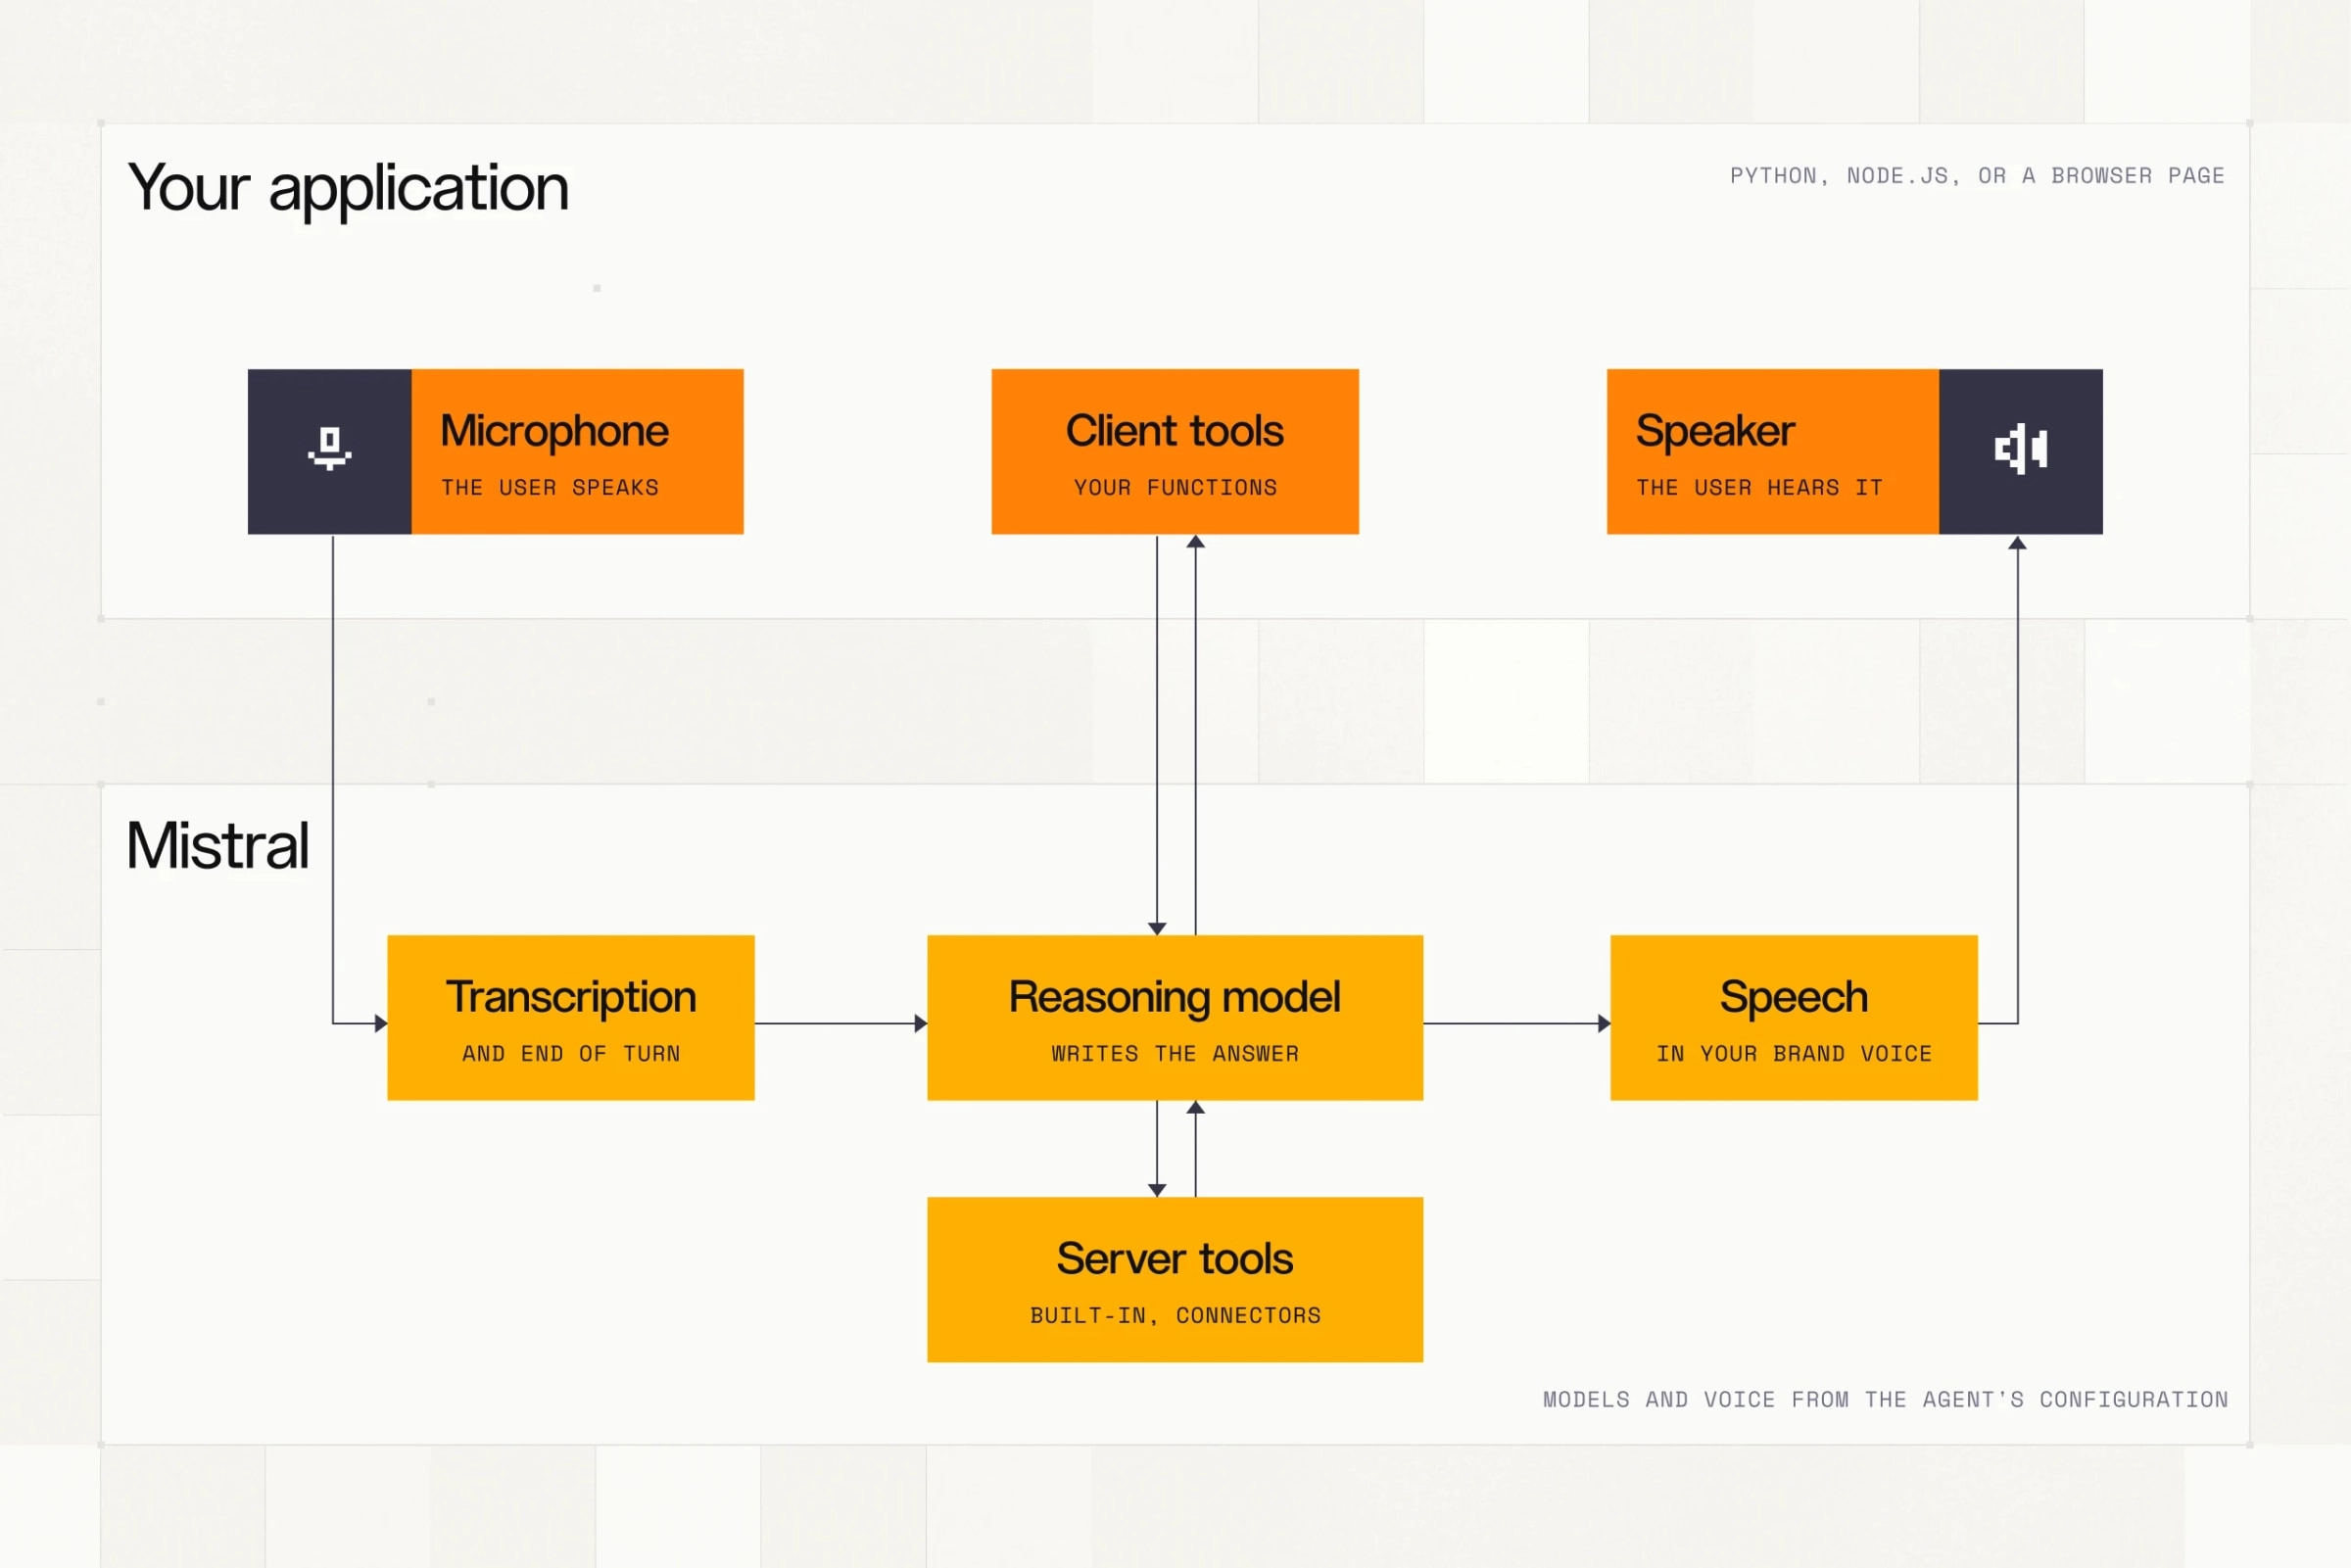 図:ユーザーの音声入力、推論、外部ツール連携、音声合成をリアルタイムに統合するVoxtral 3の音声エージェントアーキテクチャ。出典:Mistral AI 公式発表
遅延と「割り込み」こそが真の障壁
対話型インターフェースにおける遅延の許容範囲は極めてシビアだ。人間同士の対面会話における自然な間合いは数百ミリ秒程度であり、機械の応答が800ミリ秒を超えると、相手は「回線が途切れたのではないか」と不安を覚える。従来のクラウド構成では、音声アップロード、初回トークン生成のキュー待ち、音声合成のストリーミング返送といった各段のオーバーヘッドが積み重なり、合計1秒を超える遅延が常態化していた。
Realtime Transcribe 3がストリーミング文字起こしを500ミリ秒未満に圧縮したことで、その後の推論やツール呼び出しに十分なバッファが生まれた。カスタマーサポート業務において、これは極めて重要だ。ユーザーが話し終えるまでの間にバックエンドで顧客情報を照会し、発話の終了と同時に即座に回答を返すことが可能になる。
もうひとつの難題が「話の割り込み(ターン制御)」である。初期の音声システムは音量しきい値のみで無音を判定していたため、ユーザーの息づかいや考え中の短い沈黙で即座に機械が発話を遮ってしまう欠点があった。Voxtral 3では音響特徴量と意味論的コンテキストを統合してターンの終了を予測するため、話者が次の言葉を選んでいる最中の自然な「えーと」といった間を誤認識することがない。
45言語でエラー率4%台を達成
文字起こしの基礎性能においても、Voxtral Small Transcribe 3は45言語を対象としたFLEURSベンチマークで単語誤り率(WER)4.0%を記録し、4BのMini版も4.1%を達成した。比較対象として、同ベンチマークにおけるWhisper large-v3のスコアはそれぞれ16.0%および14.9%であり、Microsoft MAI-Transcribe-2、Gemini 3.5 Transcribe、Scribe v2、GPT-Transcribeなどの競合を大きく引き離している。
Artificial Analysisによる多言語評価でも、Voxtral Small Transcribe 3はフランス語、スペイン語、イタリア語、ポルトガル語、オランダ語などのヨーロッパ主要言語でトップの評価を獲得した。
企業現場で特に重視されるのは、複数人が同時に発言する混在環境への耐性だ。話者分離を含む対話評価において、Voxtral SmallのcpWER(結合順列単語誤り率)は18.4%を記録したのに対し、Gemini 3.5 Transcribeは38.4%にとどまった。この精度の差は、議事録作成システムを実務でそのまま運用できるか否かを分ける決定打となる。
専門用語の認識精度も大幅に改善された。コンテキストバイアス機能により、認識実行前にカスタム用語辞書をモデルに事前注入できるため、キーワードのリコール率は標準ベースラインの81.4%から94.6%へと向上した。医薬品名や特殊な製品型番も、後処理で人間が手作業修正する必要がなくなる。
 図:音声モデルの実用化は、膨大な呼量を処理する企業のカスタマーサービスや電話ネットワークに集中している。出典:Mistral AI 公式発表
データの保管場所が契約の成否を分ける
技術指標のクリアは参入の最低条件に過ぎない。銀行、医療機関、政府機関の調達プロセスでは、コンプライアンス上の大きな壁が存在する。話者の声紋を含む生音声データは厳格な生体認証情報(バイオメトリクス)に分類され、EUのGDPRをはじめとする各国の個人情報保護法規により、国境を越えた越境移転が厳格に規制されているからだ。
北米の大手プロバイダーの多くはパブリッククラウド上でのフルマネージド提供に限られており、顧客の音声データを指定の米系クラウドへ送出する必要がある。これに対しMistralは2つの選択肢を用意した。EU域内のデータセンターでホストされるAPIを利用するか、あるいはオープンモデルの重みを自社のプライベート環境にダウンロードしてオンプレミスで運用するかだ。データの保持・管理権を自社で完全に掌握できるこの仕組みは、欧州の金融機関や公共部門にとって法務審査のハードルを一気に下げる強力な強みとなっている。
音声AIの主戦場は、もはや単なる認識精度の競い合いから、運用コストの透明性とデータ主権(ガバナンス)の確保へと移行した。実用基準を超えた今、企業の採用を勝ち取る条件は極めてシンプルだ。「1分いくらかかるのか」、そして「サーバーは誰の管轄下にあるのか」である。
参考リンク:
- Mistral AI 公式発表
- Hacker News コミュニティ議論
- Artificial Analysis 音声モデル評価レポート
- BeSimple AI Voice Code Bench ベンチマーク